LoopVQ: Sub 1-bit KV Cache Quantization for Looped Transformers
도입 루프 트랜스포머는 같은 레이어 묶음을 여러 번 반복해서 쓰는 모델이다. 파라미터를 아끼는 대신 반복 단계마다 키·값 캐시를 따로 저장해야 해서, 서빙의 병목이 가중치에서 캐시로 옮겨 간다. 이 글은 그 캐시를 원소당 1비트 미만으로 압축하는 방법(LoopVQ)의 관찰과 설계, 실측 결과를 정리한다.…
도입 루프 트랜스포머는 같은 레이어 묶음을 여러 번 반복해서 쓰는 모델이다. 파라미터를 아끼는 대신 반복 단계마다 키·값 캐시를 따로 저장해야 해서, 서빙의 병목이 가중치에서 캐시로 옮겨 간다. 이 글은 그 캐시를 원소당 1비트 미만으로 압축하는 방법(LoopVQ)의 관찰과 설계, 실측 결과를 정리한다.…
도입 대화형 서비스처럼 배치 크기가 1에 가까운 상황에서, 전문가 혼합 언어 모델의 지연 시간은 대부분 라우팅된 전문가 가중치를 GPU 메모리에서 읽는 데서 생긴다. 전문가 안의 중간 차원 대부분은 한 토큰에 거의 기여하지 않으므로, 어느 채널을 읽을지 먼저 고르면 읽는 양을 크게 줄일 수 있다. 이 논…
모델이 직접 생성한 토큰으로 프루닝을 보정하고 디코딩 전용 커널을 결합합니다. A100 실험에서 최대 1.48배 가속을 얻은 조건과 품질 손실을 살펴봅니다.
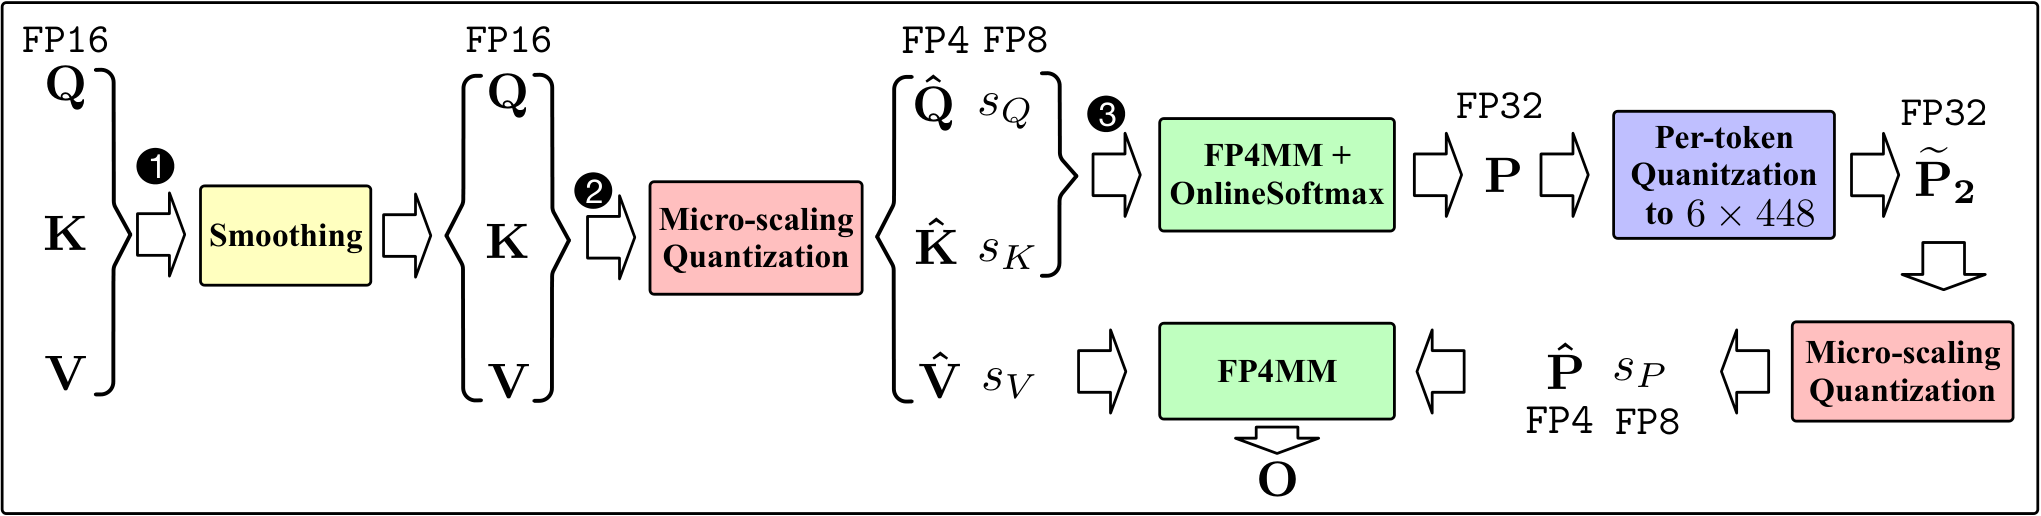
SageAttention3의 FP4 추론과 SageBwd의 INT8 학습을 구분합니다. 검산한 예시로 양자화 오차, 저장량, 커널과 전체 실행 시간의 차이를 설명합니다.
Native Sparse Attention (NSA) — 64 k 토큰도 11× 빠르게, 정확도는 그대로 한 줄 요약 (TL;DR) NSA는 ‘압축 → 선택 → 슬라이딩’ 3 분기 희소 어텐션과 GQA/MQA-친화 커널을 결합해 64 k 컨텍스트에서 디코딩 속도를 11.6 배, 학습 속도를 최대 9 배…