Channel Selection for Mixture-of-Experts Decoding Needs No Calibration Data
도입 대화형 서비스처럼 배치 크기가 1에 가까운 상황에서, 전문가 혼합 언어 모델의 지연 시간은 대부분 라우팅된 전문가 가중치를 GPU 메모리에서 읽는 데서 생긴다. 전문가 안의 중간 차원 대부분은 한 토큰에 거의 기여하지 않으므로, 어느 채널을 읽을지 먼저 고르면 읽는 양을 크게 줄일 수 있다. 이 논…
도입 대화형 서비스처럼 배치 크기가 1에 가까운 상황에서, 전문가 혼합 언어 모델의 지연 시간은 대부분 라우팅된 전문가 가중치를 GPU 메모리에서 읽는 데서 생긴다. 전문가 안의 중간 차원 대부분은 한 토큰에 거의 기여하지 않으므로, 어느 채널을 읽을지 먼저 고르면 읽는 양을 크게 줄일 수 있다. 이 논…
문제: 이해와 생성을 하나의 표현으로 합치기 어려운 이유 이미지 이해와 이미지 생성을 한 모델로 합치려는 시도는 많다. 그러나 대부분은 두 능력을 서로 다른 표현 공간에서 따로 최적화한다. 텍스트는 토큰 분류 문제로, 이미지는 연속 벡터에 대한 확산·플로우 목표로 학습하면, 한 백본 안에서 두 목표가 서…
TokenRouter: 토큰 단위 LLM 라우팅을 위한 효율적 서빙 시스템 TL;DR — LLM을 세션·쿼리 단위가 아니라 토큰 단위로 라우팅하면 비용-품질 파레토 프론티어를 크게 끌어올릴 수 있지만, 단일 LLM 가정에 묶인 기존 서빙 스택(vLLM, SGLang)에서는 스텝 탈동기화·배치 수용 지연·…
TRACE: 롤아웃을 따라가는 FP4 양자화 인식 학습 — MoE LLM의 강화학습을 BF16 성능 그대로, 최대 5.4배 빠르게 한 줄 요약 (TL;DR) MoE LLM의 강화학습(RL)에서 롤아웃 생성을 FP4(W4A4 + FP4 KV) 로 양자화하면 생성 속도가 최대 5.4배 빨라지지만, 학습 경로…
DeepSeek-V4.1-Flash: KV 캐시를 1/4로 줄이면서 성능은 더 끌어올린 멀티모달 MoE 한 줄 요약 (TL;DR). DeepSeek-AI가 공개한 DeepSeek-V4.1-Flash 는 552B 백본 파라미터의 멀티모달 MoE로, 최대 1M 토큰 컨텍스트를 지원한다. Causal…
SSD에 산 MoE를 깨우다: 24 GB 데스크톱에서 35B MoE를 20 tok/s로 서빙하는 Edge0 한 줄 요약 (TL;DR) 35B급 MoE는 4-bit로도 19.5 GB 를 차지해 24 GB 머신에 상주하지 못한다 (근거: §1). Edge0는 엑스퍼트 가중치를 SSD에 두고 mmap 스트리밍…
Miles v0.1: 프론티어 RL 사후학습을 위한 "검증·청결·확장 가능"한 풀스택 시스템 TL;DR : Miles는 rolluout 생성과 트레이닝이 서로 다른 엔진·커널·정밀도로 돌아가며 발생하는 train-rollout mismatch를 시스템 차원에서 해결하는 풀스택 RL 사후학습 프레임워크다.…
캐시를 배우는 라우터 : 메모리-제약 MoE 추론을 위한 Cache-Aware Joint Router Adaptation 한 줄 요약 (TL;DR) MoE의 진짜 병목은 연산량이 아니라 전문가 가중치 이동량이다 라는 문제의식에서 출발해, 네이티브 Top- $K$ 선택 규칙은 그대로 두면서 캐시 상주 우선…
SMELT: 계산량을 맞춘 MoE 루프 트랜스포머의 스케일링 법칙 한 줄 요약 (TL;DR) 루프 트랜스포머는 레이어 블록을 반복 실행해 깊이를 늘리지만, 기존 연구는 대부분 파라미터 수만 고정한 채 FLOPs를 늘려 "공짜 점수"를 얻고 있었다. SMELT는 per-token FLOPs·총 파라미터…

Engram: 조건부 연산(MoE) 이후의 두 번째 희소성 축, 조건부 메모리(Conditional Memory) 한 줄 요약 (TL;DR) Engram은 Transformer에 “지식 조회(lookup) primitive”를 추가해, 표준 모델이 early layer에서 수행하던 정적 지식/로컬 패턴…

NVIDIA Nemotron 3: 하이브리드 Mamba–Transformer MoE로 “정확도/처리량” 프런티어를 당기다 Nemotron 3 는 MoE 하이브리드 Mamba–Transformer, LatentMoE , MTP , NVFP4 학습, 멀티-환경 RL 을 결합해 “정확도 대비 추론 처리량…

Qwen 3: 생각량을 조절하는 거대 MoE 언어모델의 진화 한 줄 요약 (TL;DR) Qwen 3는 “얼마나 깊게 생각할지”를 토큰 수치로 직접 제어할 수 있는 Thinking Budget과 128-전문가 MoE 설계를 결합해, 활성 파라미터 22 B 만으로도 기존 100 B+ 밀집 모델을 넘어서는 성…
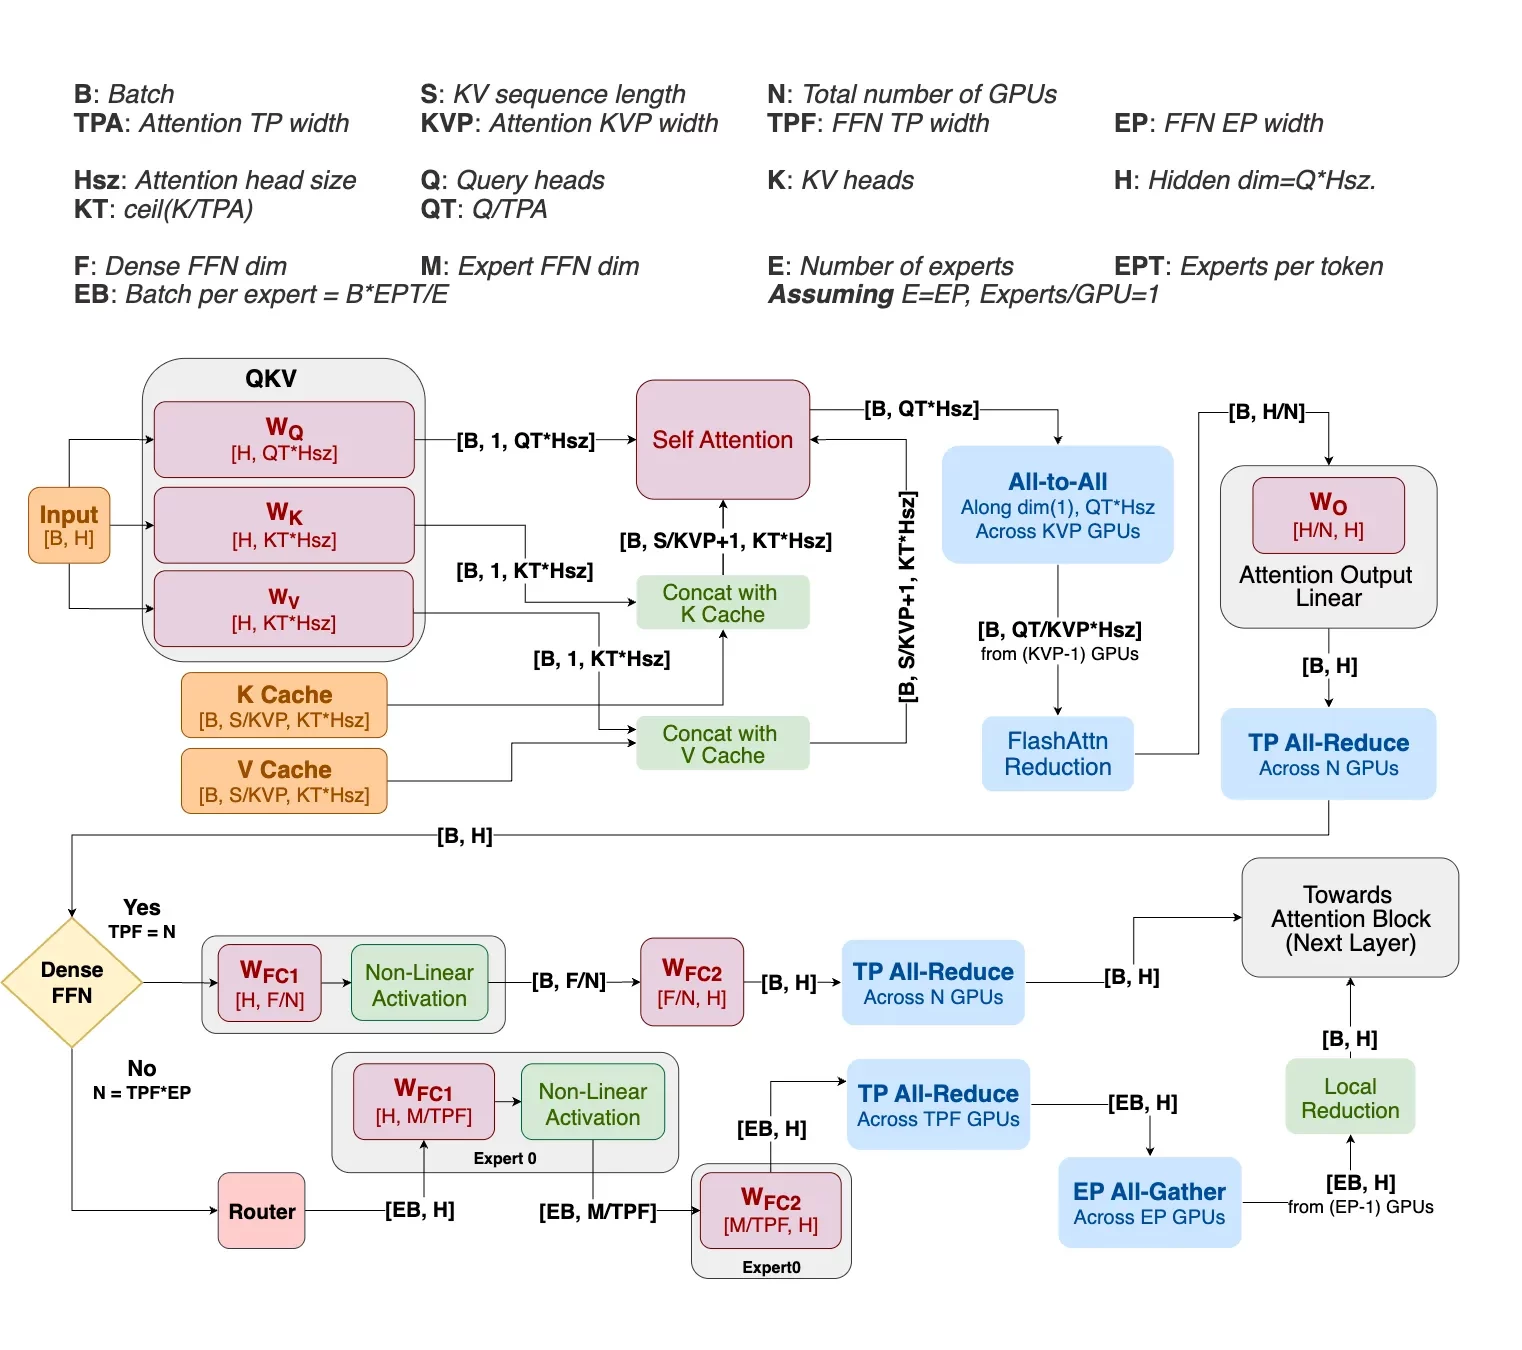
Helix Parallelism: 초장기 LLM 디코딩의 지연-처리량 벽을 깨다 한 줄 요약 (TL;DR) Helix Parallelism은 Attention과 FFN을 서로 다른 병렬화 전략으로 스케줄링해 KV 캐시 중복과 FFN 가중치 로드 병목을 동시에 해소—1 M 토큰 컨텍스트에서 토큰 지연을 최…
한 줄 요약 (TL;DR) Loss-Free Balancing(LFB)은 auxiliary loss를 완전히 제거한 채, 전문가별 bias 한 줄 업데이트만으로 Mixture-of-Experts(MoE) 모델의 ‘로드 밸런스 ↔ 성능’ 딜레마를 깨고 Perplexity ≈ 0.5↓, MaxVio ≥ 90…
MoE 추론의 패딩·마스크 비용을 줄이는 dynamic gating과 expert buffering, 부하 균형을 살펴봅니다. 처리량과 메모리 감소의 측정 조건을 구분합니다.