MemT-1.0: Towards Memory-Native Evolution
대화 이력을 고정 크기 행렬 상태에 기록하는 MemT-1.0의 구조를 살펴봅니다. 전체 문맥·검색 기반 접근과 비교해 기억의 갱신 방식과 정보 손실의 한계를 정리합니다.
대화 이력을 고정 크기 행렬 상태에 기록하는 MemT-1.0의 구조를 살펴봅니다. 전체 문맥·검색 기반 접근과 비교해 기억의 갱신 방식과 정보 손실의 한계를 정리합니다.
온폴리시는 만능이 아니다: 증류 동역학에서 롤아웃 정책·KL 방향·학습률의 진짜 주인공 TL;DR — 강-약 증류(strong-to-weak distillation)에서 온폴리시(OnPD)와 오프폴리시(OffPD)를 분리해 보면, 최종 성능·망각·업데이트 희소성을 좌우하는 것은 롤아웃 정책이 아니라 KL…
ActionPiece: 재구성 오차 너머, 물리적 순위로 액션 토크나이제이션을 다시 생각하다 TL;DR — 자율회귀(autoregressive) VLA(vision-language-action) 모델에서 액션 토크나이저는 연속적인 로봇 명령을 이산 토큰으로 압축하고, 예측된 토큰을 다시 실행 가능한 명령…
Programmable World Model — 생성형 월드에 "실행 가능한 상태"를 심다 한 줄 요약 (TL;DR) 비디오 월드 모델은 점점 더 사실적인 인터랙티브 환경을 만들어내지만, 화면에 잠깐 스친 픽셀만 기억할 뿐 "세상이 지금 실제로 어떤 상태인지"는 알지 못한다. Alaya Lab의…
Marigold V2: 이미지 편집 확산 트랜스포머(DiT)를 단안 깊이 추정기로 되살리기 한 줄 요약 (TL;DR) Qwen-Image-Edit-2509라는 이미지 편집용 확산 트랜스포머(DiT)를 4-bit QLoRA로 파인튜닝해, 단일 32GB GPU에서 약 1주일 만에 단안 깊이 추정 SOTA를…
SQS: 가지치기와 양자화를 하나의 베이지안 학습으로 — 스파이크-앤-슬랩과 GMM의 만남 TL;DR — 프루닝(pruning)과 저비트 양자화(quantization)를 따로 하면 남는 잉여가 생긴다. SQS는 스파이크-앤-슬랩 사전분포와 가우시안 혼합 모델(GMM)을 하나의 변분…
X-AuT: 행동 프로브와 크로스스케일 증류로 음성 LLM의 오디오 인코더를 깎아내는 방법 한 줄 요약 (TL;DR) 음성 LLM의 오디오 인코더(오디오 Transformer)를 18→16→14 레이어로 점진적으로 프루닝 하면서, 짧은 행동 프로브(behavioral probe) 로 회복 가능한 레이어…
VestigeKV: 퇴화한 RoPE 가지가 스스로 캐시 축출 신호를 품고 있다 한 줄 요약 (TL;DR) NoPE-MLA 모델(Kimi Linear 48B)에서, 훈련이 샐리언스 채널 로 재용도한 64차원 decoupled branch — RoPE의 "퇴화 기관(vestige)" — 를 행의 11% 만…
Uno: AR과 Diffusion을 하나의 모델에 — 무손실 병렬 생성을 통한 LLM 가속 TL;DR — LLM이 느린 이유는 next-token prediction(NTP)이 한 번에 토큰 하나씩만 내놓는 순차 구조 때문이다. Uno는 하나의 아키텍처에 품질을 책임지는 AR 가중치 와 속도를 책임지는…
모델이 '생각을 다시 꺼내 보는' 순간을 잡아라: BeaconKV가 비콘 쿼리로 추론 KV 캐시를 5.8배 압축하는 법 TL;DR — Large Reasoning Model(LRM)은 긴 Chain-of-Thought(CoT)를 생성할수록 KV 캐시가 선형으로 불어나, Qwen3-4B가 32K 토큰을 배…
FP4 텐서 코어가 빨라도 어텐션은 왜 안 빨라지는가: Direct-P와 양자화된 역전파로 푼 Blackwell FlashAttention-4 TL;DR — Blackwell의 FP4 텐서 코어는 행렬곱을 BF16보다 훨씬 빨리 처리하지만, 어텐션은 행렬곱 두 개 사이에 softmax 라는 "중간 작업"…

NVIDIA Nemotron 3: 하이브리드 Mamba–Transformer MoE로 “정확도/처리량” 프런티어를 당기다 Nemotron 3 는 MoE 하이브리드 Mamba–Transformer, LatentMoE , MTP , NVFP4 학습, 멀티-환경 RL 을 결합해 “정확도 대비 추론 처리량…
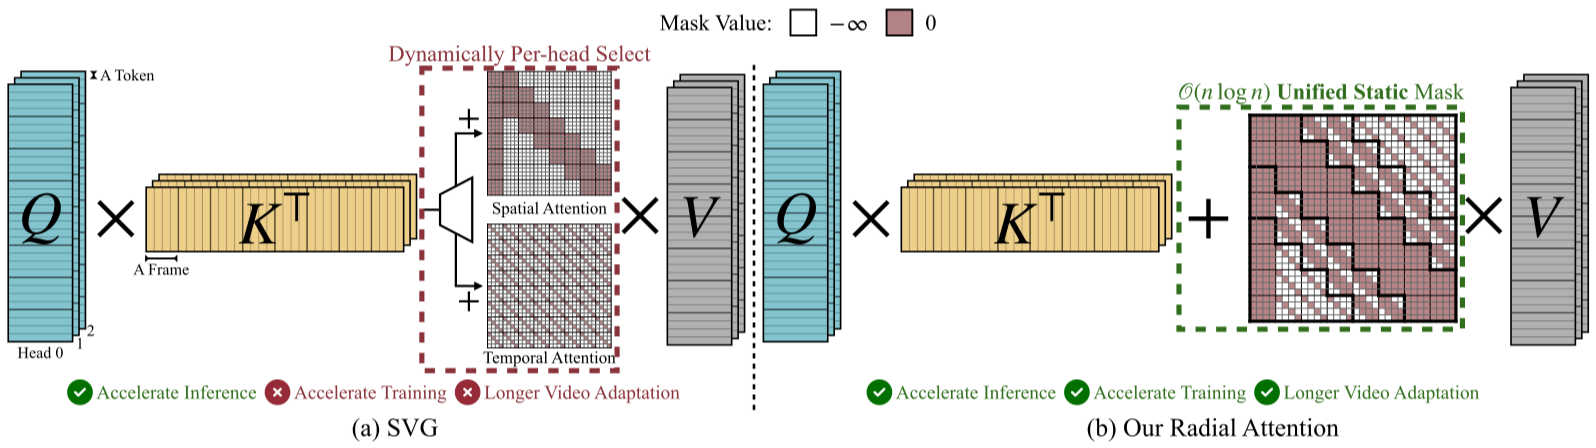
Radial Attention: O(n log n) Sparse Attention with Energy Decay로 “긴 비디오”를 싸게 뽑기 한 줄 요약 (TL;DR) 사후(softmax 이후) attention 에너지가 거리(시간/공간)와 함께 지수적으로 감쇠 한다는 관찰을 바탕으로, 계산 밀도도 같…

NVFP4로 4-bit 프리트레이닝을 실전으로: 12B를 10T 토큰까지, FP8과 사실상 동급 TL;DR 12B 하이브리드 Mamba-Transformer를 10T tokens 에서 NVFP4(4-bit) 로 프리트레이닝하면 안정 구간 손실차 <1% , 말기 1.5% 로 FP8을 근접 추종 하고, 다운…

Dynamic Memory Sparsification(DMS): KV 캐시 8× 압축으로 LLM 하이퍼-스케일링을 현실로 한 줄 요약 (TL;DR) 1 K 스텝만의 경량 재적합과 지연 퇴출 전략을 결합한 DMS는 KV 캐시를 최대 8× 압축하면서도 Qwen-R1 32B 기준 AIME 24 +9.1 pt…
LLM 추론 가속화를 위한 비동기식 KV 캐시 프리페칭 논문 상세 분석 제공된 논문 "Accelerating LLM Inference Throughput via Asynchronous KV Cache Prefetching"은 대규모 언어 모델(LLM) 추론 시 발생하는 메모리 병목 현상을 해결하기 위한…
Hogwild! Inference 논문 심층 분석 제공해주신 "Hogwild! Inference: Parallel LLM Generation via Concurrent Attention" 논문을 자세히 분석하여 강점과 독창성, 핵심 알고리즘, 그리고 한계점을 설명해 드리겠습니다. 논문의 강점 및 독창적인…
MMInference 논문 리뷰: VLM의 긴 컨텍스트 추론, '순열'로 속도의 벽을 넘다 최근 Vision Language Model(VLM)은 이미지와 텍스트를 넘어 긴 비디오까지 이해하는 능력으로 무한한 가능성을 보여주고 있습니다. [cite\start]하지만 수백만 개의 토큰으로 이루어진 긴 비디…
Slim Attention 논문 심층 분석 제공해주신 "Slim attention: cut your context memory in half without loss" 논문을 정독하고 요청하신 내용에 따라 상세하게 분석해 드리겠습니다. 논문의 강점 및 독창적인 지점 이 논문은 트랜스포머 모델의 오랜 골칫거…
네, TransMLA 논문(arXiv:2502.07864v5)을 심도 있게 분석하여 강점과 독창성, 핵심 알고리즘, 그리고 한계점을 상세히 설명해 드리겠습니다. 논문의 강점과 독창성 TransMLA 논문은 기존의 대규모 언어 모델(LLM)이 가진 실질적인 문제, 즉 추론 시 발생하는 KV 캐시 병목 현상…
제공해주신 논문 "Accelerating MoE Model Inference with Expert Sharding" (MOESHARD)에 대한 자세한 분석은 다음과 같습니다. 이 논문은 Mixture of Experts (MoE) 모델의 추론 속도를 높이기 위한 새로운 시스템인 MOESHARD를 제안합니…
✅ 결론 요약 Qwen3의 정밀한 사전학습 덕분에 고성능을 보이나, 3bit 이하의 ultra-low-bit quantization에 매우 민감하여 기존 모델보다 성능 저하가 크다. 4bit 이상에서는 GPTQ와 AWQ가 최상의 trade-off를 제공하며, BiLLM은 1bit에서도 유의미한 결과를 보…
📌 결론 요약 논문 "MELODI: Exploring Memory Compression for Long Contexts"는 Transformer의 긴 문맥 처리 문제를 해결하기 위해 계층적 메모리 압축(hierarchical memory compression) 구조를 제안합니다. 핵심은 다층 반복 압축…
논문 "Comet: Fine-grained Computation-communication Overlapping for Mixture-of-Experts"는 MoE 모델의 핵심 병목인 GPU 간 통신 지연을 fine-grained 수준에서 컴퓨팅과 통신을 정교하게 겹치도록 설계함으로써 실행 성능을 크게 개…
📌 결론 요약 (핵심 기여 및 성능) MegaScale-Infer는 대규모 Mixture-of-Experts (MoE) 모델 서빙을 위한 효율적 시스템으로, Attention과 FFN 모듈을 분리(disaggregate) 하여 GPU 활용률을 극대화하고 최대 1.9×의 GPU throughput 개선 및…
논문 「SwitchHead: Accelerating Transformers with Mixture-of-Experts Attention」을 매우 자세하게 읽고 분석한 내용을 바탕으로, 논문의 강점과 독창적인 지점, 핵심 알고리즘의 상세한 설명과 함께 예시 입력을 이용한 동작 과정을 소개하고, 마지막으로…
📌 결론 요약 논문 "Duplex: A Device for Large Language Models with Mixture of Experts, Grouped Query Attention, and Continuous Batching"은 저연산량(Op/B)이 지배적인 MoE 및 GQA 기반 LLM 추론을 위…
논문 『Mirage: A Multi-Level Superoptimizer for Tensor Programs』를 자세히 분석한 내용을 정리하여 설명합니다. 📌 결론 압축 정리 『Mirage』는 GPU에서 실행되는 텐서 프로그램을 위한 최초의 다계층 슈퍼 옵티마이저로, 커널(kernel), 블록…
✅ 결론 요약 (핵심 강점, 독창성, 핵심 메커니즘) MoEUT는 Universal Transformer(UT)의 구조적 강점(레이어 파라미터 공유 기반의 recurrence)을 유지하면서도 기존 한계였던 parameter-compute ratio 문제를 해결한 구조다. 핵심은 다음 세 가지다:…
📌 논문 요약 및 분석 (FlexAttention: A Programming Model for Generating Optimized Attention Kernels) ✅ 논문의 강점 및 독창적인 지점 유연성 (Flexibility) 기존의 FlashAttention과 달리, FlexAttention은 다…
논문 『LeanAttention: Hardware-Aware Scalable Attention Mechanism for the Decode-Phase of Transformers』에 대한 상세한 분석을 다음과 같이 제시합니다. ✅ 결론 (요약) 이 논문은 Transformer 모델의 디코딩 단계에서 긴…
논문 『SparseTransX: Efficient Training of Translation-Based Knowledge Graph Embeddings Using Sparse Matrix Operations』의 강점, 독창적인 지점, 핵심 알고리즘의 예시와 전체적인 과정, 그리고 한계점을 정리하여 전달드…
📌 논문 제목: NEO: Saving GPU Memory Crisis with CPU Offloading for Online LLM Inference 📌 저자: Xuanlin Jiang, Yang Zhou, Shiyi Cao, Ion Stoica, Minlan Yu 1. 결론 요약 (강점 & 독창적인 지…
논문『PipeFill: Using GPUs During Bubbles in Pipeline-parallel LLM Training』의 핵심 내용을 상세히 분석하여, 논문의 강점, 독창적인 지점, 핵심 알고리즘의 전체적인 과정 및 한계점을 요약하였습니다. 📌 결론 (요약) 『PipeFill』은 파이프라인…
논문의 핵심을 정리하여 결론부터 간략히 제시한 후, 구체적인 수치를 통해 강점 및 독창적인 지점을 설명하고, 논문에서 제안한 핵심 알고리즘을 예시와 함께 설명하며, 논문의 한계점을 논의하겠습니다. 📌 논문의 요약된 결론: 이 논문은 구조적 프루닝(structured pruning)을 수행한 대형 언어 모…
✅ 결론 요약 이 논문은 "메모리 용량을 초과하는 대규모 데이터셋에서 대표적인 subset을 효율적으로 선택"하는 문제를 다룬다. 기존 방법들은 중앙 서버가 전체 subset을 메모리에 올릴 수 있어야 한다는 제약이 있었지만, 이 논문은 중앙 서버 없이도 분산 환경에서 고품질 subset을 선택할 수 있…
✅ 결론 요약 SampleAttention은 기존 LLM의 attention을 거의 정확도 손실 없이 대체하면서, 최대 2.42배 TTFT(Time-to-First-Token) 지연을 줄이는 구조화된 adaptive sparse attention 기법이다. 핵심은 두 가지 sparse 패턴인 local…
✅ 결론 요약 이 논문은 초장문(long-context) LLM을 저렴한 하드웨어(예: 4 GPU) 상에서 효율적으로 훈련할 수 있게 하는 FPDT (Fully Pipelined Distributed Transformer) 구조를 제안함. 기존 대비 최대 16배 더 긴 시퀀스(예: 2M tokens)를…
논문의 강점과 독창적인 지점 1. 강점 저비트 정량화(Quantization)의 실용적 개선: 기존 INT4 정량화 기법들이 클라우드 기반 LLM 서빙에서 성능 개선을 보이지 못하는 문제를 해결. QoQ(W4A8KV4) 알고리즘 제안: 4비트 가중치(W4), 8비트 활성화(A8), 4비트 KV 캐시…
논문의 강점과 독창적인 지점 이 논문은 연합 학습(Federated Learning, FL)의 리소스 관리 문제를 다루며, 특히 다수의 FL 작업이 동일한 디바이스 풀에서 실행될 때 발생하는 자원 경쟁(Resource Contention) 을 해결하는 Venn이라는 새로운 리소스 관리 시스템을 제안합니다…
논문『AI Metropolis: Scaling Large Language Model-based Multi-Agent Simulation with Out-of-order Execution』의 주요 강점과 독창적인 지점, 핵심 알고리즘 및 한계점을 압축하여 설명하면 다음과 같습니다. 📌 결론 (요약) 강점…
SwiGLU MLP의 입력을 동적으로 고르고, DRAM에 있는 가중치를 재사용하는 DIP를 설명합니다. 시뮬레이션 결과와 행렬곱 계산 예시의 조건을 구분합니다.
논문의 핵심 요약 및 평가 논문 제목: Marconi: Prefix Caching for the Era of Hybrid LLMs 핵심 기여: Marconi는 Hybrid LLM(Attention + State Space Model, SSM)에서 효율적인 Prefix Caching을 지원하는 최초의 시스…
논문 『TurboAttention: Efficient Attention Approximation for High Throughputs LLMs』는 기존의 Attention 연산의 속도와 메모리 효율성을 동시에 개선한 통합적인 접근 방법을 제안하고 있으며, 이는 두 가지 핵심 알고리즘인 FlashQ와…
논문의 강점 및 독창적인 지점 이 논문은 대규모 데이터 센터에서 기계 학습(ML)을 활용한 저장소 배치(Storage Placement) 문제를 다루며, 기존 접근법의 한계를 극복하기 위해 크로스-레이어(Cross-Layer) 접근 방식을 제안했다. 주요 강점과 독창적인 점은 다음과 같다. 기존 단일 계…
본 논문은 JaxPP라는 시스템을 제안하여, 기존의 Single-Program Multiple-Data (SPMD) 방식의 한계를 극복하고 Multiple-Program Multiple-Data (MPMD) 파이프라인 병렬화를 통해 대규모 딥러닝 모델 학습의 확장성과 성능을 향상한 연구이다. 특히,…
논문의 핵심 내용을 먼저 간략히 요약한 후, 강점과 독창적인 지점을 자세히 설명하고, 핵심 알고리즘의 동작 원리를 예시와 함께 제시한 뒤, 논문의 한계점을 마지막으로 정리하겠습니다. 🔑 논문의 핵심 내용 요약 이 논문은 긴 시퀀스를 처리하는 Large Language Model(LLM) 서빙 시스템에서…
논문의 핵심 내용 요약 및 강점 이 논문은 Model Folding이라는 새로운 데이터 프리 모델 압축 기법을 제안한다. 기존의 압축 방법(가지치기, 양자화)과 달리, Model Folding은 층(layer) 간 유사한 뉴런을 병합하여 모델 크기를 줄인다. 특히, 데이터 없이(data-free), 파인…
논문의 핵심 요약 논문 "FLASHMASK: Efficient and Rich Mask Extension of FlashAttention"는 기존 FlashAttention이 지원하는 마스크 타입을 확장하고, 메모리 복잡도를 O(N²)에서 O(N)으로 줄이면서 성능을 향상시킨 새로운 column-wise…
논문의 강점 및 독창적인 지점 1. 기존 Sequence Parallelism (SP)의 한계 개선 기존 SP 기법(LASP-1, Ring Attention 등)은 Right-product-first 특징을 제대로 활용하지 못하고, 링 스타일(Ring-style) 통신 방식을 사용해 통신-연산 병렬성이…
논문의 핵심 요약 이 논문은 RoSeMary라는 새로운 코드 워터마킹 프레임워크를 제안한다. 기존의 코드 워터마킹 기법들이 검출 가능성(detectability), 충실도(fidelity), 그리고 강건성(robustness) 간의 균형을 맞추지 못하거나, 서명을 검증하는 과정에서 보안 문제가 발생하는…
논문의 강점과 독창성 1. 순수 강화학습 기반 모델 개발: DeepSeek-R1-Zero는 Supervised Fine-Tuning (SFT) 없이 순수 강화학습(RL) 만으로 훈련된 최초의 공개 연구 모델입니다. 기존의 LLM 개발이 대부분 대규모 감독 데이터에 의존했던 것과는 다르게, 이 모델은 RL…
논문의 강점 및 독창적인 지점 문제 인식 및 대응: 이 논문은 기존 벤치마크(MMLU 등)가 LLM(대형 언어 모델)에 의해 거의 90% 이상의 정확도를 기록하며 포화 상태에 도달한 문제를 지적하고 있습니다. 이를 해결하기 위해 Humanity's Last Exam (HLE)이라는 새로운 벤치마크를 제안…
논문의 개요 및 강점 논문 제목: DeepSeek-Coder-V2: Breaking the Barrier of Closed-Source Models in Code Intelligence DeepSeek-Coder-V2는 오픈소스 코드 언어 모델로서 GPT-4 Turbo, Claude 3 Opus,…
논문의 강점 및 독창성 강화 학습과 증명 보조기 피드백의 통합 DeepSeek-Prover-V1.5는 증명 보조기(Lean 4)의 피드백을 활용한 강화 학습(RLPAF)을 통해 모델의 성능을 개선했습니다. 기존 모델들은 단순한 감독 학습에 의존했으나, 이 모델은 증명 검증 결과를 직접적으로 학습에 반영함…
논문의 강점 및 독창성 논문 제목: Let the Expert Stick to His Last: Expert-Specialized Fine-Tuning for Sparse Architectural Large Language Models 강점 Sparse Architecture LLM에 대한 최초의 체계적…
논문 개요: “How to Train Data-Efficient LLMs” 이 논문은 대규모 언어 모델(LLM) 훈련의 높은 비용 문제를 해결하기 위해 데이터 효율적 사전 훈련 방법론을 탐구합니다. 저자들은 데이터 품질 및 커버리지 기반 샘플링 기법을 활용하여 모델 성능과 훈련 자원 소모 사이의 최적 균…
논문 요약: “DeepSeek-Coder: When the Large Language Model Meets Programming - The Rise of Code Intelligence” 논문의 강점 및 독창성 강점: 오픈 소스 코드 모델: DeepSeek-Coder 시리즈는 1.3B부터 33B까지 다양…
논문의 개요 및 강점 논문 제목: DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models 저자: Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song 외.…
논문의 강점과 독창적인 지점 논문 "DeepSeek LLM: Scaling Open-Source Language Models with Longtermism" 은 대규모 오픈소스 언어 모델 개발과 스케일링 법칙(scaling laws)에 대한 연구를 다루고 있습니다. 주요 강점과 독창적인 지점을 정리하면…
논문 요약 및 핵심 내용 이 논문 "Qwen-Audio: Advancing Universal Audio Understanding via Unified Large-Scale Audio-Language Models"에서는 다양한 오디오 유형과 태스크를 다룰 수 있는 대규모 오디오-언어 모델…
논문의 강점 및 독창적인 지점 빠르고 정확한 하드웨어 평가 프레임워크 (LLMCompass) 제공 기존의 Roofline 모델이 빠르지만 부정확하고, 사이클 수준의 시뮬레이션이 정확하지만 느린 단점을 보완. 평균 10.4%의 연산자 오류율과 LLM 추론에 대한 4.1%의 오류율을 기록하며 빠른 평가 가능…
논문의 강점과 독창적인 지점 압축된 컨텍스트 메모리(CCM) 도입: 온라인 언어 모델 추론 시 지속적으로 증가하는 컨텍스트를 압축하여, 기존보다 5배 적은 메모리로 유사한 성능을 달성. 슬라이딩 윈도우 방식보다 뛰어난 성능을 발휘하며, 무제한 길이의 스트리밍 설정에서도 효과적임. 경량 LoRA(LoRA:…
논문 요약 이 논문은 Taipan이라는 새로운 하이브리드 모델을 제시합니다. Taipan은 Mamba-2와 Selective Attention Layers(SALs)를 결합하여 긴 문맥을 효과적으로 처리하면서도 계산 효율성을 유지하는 모델입니다. 주요 아이디어는 모든 토큰에 대해 동일한 계산 자원을 할당…
논문의 강점과 독창적 지점 강점: 효율적 성능 개선: Block Transformer는 기존 Transformer의 가장 큰 병목 현상인 Key-Value(KV) 캐시 관련 I/O 부담을 크게 완화하여, 최대 1020배 높은 추론 처리량을 달성합니다. 효율적인 글로벌-로컬 구조: 하위 계층은 글로벌 문맥…
요약 및 강점 논문 "Rethinking Optimization and Architecture for Tiny Language Models"은 경량 언어 모델(LM)을 모바일 디바이스에서도 실행 가능하도록 최적화하는 데 초점을 맞춥니다. 이를 위해 신경망 아키텍처 설계, 파라미터 초기화, 최적화 전략에…
결론 요약 논문 "Cascade Speculative Drafting for Even Faster LLM Inference"는 대형 언어 모델(LLM)의 추론 속도를 향상시키기 위해 제안된 CS Drafting 알고리즘을 다룹니다. 이는 기존의 Speculative Decoding의 성능을 개선하여 최대…
논문의 강점과 독창적인 지점 독창적인 분산 시스템 설계: 이 논문은 분산된 신뢰성이 낮은 기기들로 대규모 언어 모델(50B+ 파라미터)을 실행하기 위한 결함 허용 알고리즘을 제안합니다. 이는 기존의 고성능 서버에 의존하지 않고, 일반 사용자 장비를 활용하여 LLM을 실행할 수 있도록 설계되었습니다.…
논문의 주요 강점과 독창성 효율적인 대규모 LLM 훈련 및 추론: EE-LLM은 Early-Exit LLM의 대규모 훈련 및 추론을 지원하는 첫 번째 프레임워크 중 하나로, 3D 병렬 처리를 기반으로 설계되어 대규모 모델 훈련에서 높은 효율성을 제공합니다. Early-Exit 층을 추가하면서도 훈련 시간…
결론 요약 이 논문은 Gated Linear Attention Transformer (GLA Transformer)라는 새로운 변형을 제안하며, 이를 통해 기존의 Linear Attention의 한계를 극복하고 하드웨어 효율성을 크게 개선했습니다. 특히, FLASHLINEARATTENTION 알고리즘을…
논문의 주요 내용 및 독창성 이 논문은 대용량 언어 모델(LLM)을 제한된 DRAM 환경에서도 효과적으로 실행할 수 있는 방법을 제안합니다. 이 방법은 플래시 메모리를 사용해 모델 파라미터를 저장하고, 필요할 때 DRAM으로 불러오는 구조를 제안하며, 다음과 같은 주요 기법들을 포함합니다:…
논문의 강점, 독창성, 핵심 알고리즘, 그리고 한계점 결론 요약 이 논문은 대규모 언어 모델(LLM)을 엣지 디바이스에서 효과적으로 실행하기 위한 새로운 양자화 프레임워크인 Agile-Quant을 제안합니다. 기존의 가중치 중심 양자화와 달리, 활성화 값까지 4비트 정밀도로 양자화하여 성능 손실 없이 최…
논문의 강점과 독창적인 지점 강점: 강화 학습 기반 정렬: "Sparrow"는 인간 피드백을 활용한 강화 학습(RLHF)을 통해 규칙 기반 평가와 선호도 평가를 결합하여 높은 수준의 성능을 달성함. 모델의 응답 선호도가 향상되는 동시에 규칙 위반율이 8%로 낮아짐. 증거 기반 응답: 질문에 대한 응답 시…
논문의 강점과 독창적인 지점 논문 "OPT: Open Pre-trained Transformer Language Models"는 다음과 같은 강점과 독창적인 지점을 지니고 있습니다. 효율적인 학습: OPT-175B는 GPT-3과 성능이 유사하지만, 훈련 과정에서 약 1/7의 탄소 배출로 동일한 규모의 모…
논문 요약 및 강점, 독창성, 한계점 분석 요약 "SparQ Attention: Bandwidth-Efficient LLM Inference" 논문은 대형 언어 모델(LLM) 추론 시 발생하는 메모리 대역폭 병목 현상을 해결하기 위한 SparQ Attention 기법을 제안합니다. 이 기법은…
결론 및 주요 결과 논문 "CBQ: Cross-Block Quantization for Large Language Models"의 주요 기여와 성과를 요약하면 다음과 같습니다: 강점 및 독창성: Cross-Block Dependency (CBD): 기존 Block 기반 PTQ(Post-Training…
논문의 강점과 독창적인 지점 메모리 효율성: GaLore는 Gradient Low-Rank Projection이라는 독창적인 방식을 통해 기존의 Low-Rank Adaptation (LoRA)보다 메모리 효율성을 크게 개선하였습니다. 특히, Optimizer 상태 메모리를 최대 65.5% 감소시키고,…
논문의 강점 및 독창성 1. 주요 기여점: LayerSkip 방법: 이 논문은 Layer Dropout과 Early Exit Loss를 통합하여 모델의 계산량을 줄이면서도 성능 저하를 최소화하는 혁신적인 방법을 제안합니다. Layer Dropout: 초기 레이어의 dropout 비율은 낮고, 마지막 레이…
논문의 강점 및 독창적인 지점 핵심 요약: 이 논문은 Transformer 기반 대형 언어 모델(LLM)의 특정 층에서 랭크 감소(LASER) 기법을 통해 성능을 개선할 수 있음을 발견했습니다. 특히, 훈련이 끝난 모델에 적용 가능한 후처리 방법으로, 특정 층의 고차 요소(작은 특이값에 해당하는 성분)를…
논문의 강점 및 독창적인 지점 효율적이고 정확한 INT8 양자화 기반 주의 메커니즘(SageAttention): SageAttention은 INT8 양자화를 적용하여 기존 FlashAttention2 및 xformers보다 약 2.1배, 2.7배 빠른 성능을 제공합니다. 이는 효율성과 정확성을 모두 확보…
강점과 독창성 강력한 이론적 연결: 논문은 Transformer와 Structured State Space Models(SSMs)을 연결하는 "State Space Duality" (SSD)를 제안했습니다. 이는 SSM을 Attention 기반 모델의 한 변형으로 새롭게 해석할 수 있게 하며, 이를 통해…
논문의 강점 및 독창성 이 논문은 대규모 언어 모델(LLM)의 Tensor Parallel 전략에서 발생하는 통신 병목 현상을 해결하기 위해 정교한 양자화 기술을 사용하여 통신 압축을 제안한 점에서 독창적입니다. 주요 강점은 다음과 같습니다: 효율적인 통신 압축: 부분 결과를 양자화하여 3.54.5배 데…
강점 및 독창적 기여 이 논문은 Context Parallelism (CP)라는 기법을 통해 대규모 언어 모델(LLM)에서의 긴 문맥 길이(최대 1M 토큰) 추론 효율성을 대폭 향상시키는 방법을 제안합니다. 주요 강점과 독창적인 기여는 다음과 같습니다: 긴 문맥 길이에서의 추론 효율성: 기존의 방법보다…
결론 요약 논문 "FastAttention: Extend FlashAttention2 to NPUs and Low-resource GPUs for Efficient Inference"은 FlashAttention 시리즈의 성능을 NPU와 저자원 GPU로 확장하며, 초저자원 환경에서 Transformer…
논문 요약: ClusterKV: Semantic Space에서 KV Cache를 관리하는 효율적인 압축 기법 주요 강점과 독창적인 점 • 효율성과 정확성의 균형: • 기존 방식인 “비-회수 가능 KV 압축” 및 “페이지 단위 회수”는 정확성 및 자원 효율성을 저하시켰으나, ClusterKV는 토큰의 의미…
논문의 핵심 요약 이 논문은 대형 언어 모델(LLM) 추론 시 CPU-GPU 간의 데이터 전송 병목 현상을 해결하기 위해 I/O를 고려한 부분 KV 캐시 재계산 기법을 제안합니다. 기존의 GPU 메모리 부족 문제를 CPU 메모리로 오프로드하여 해결하려는 접근법의 단점을 보완하며, GPU 계산과 PCIe…
논문의 강점 및 독창성 효율성 증가: • SageAttention2는 4비트 정밀도(INT4)와 FP8(8비트 부동소수점)을 활용하여 기존 FlashAttention2 대비 약 3.1배 빠른 연산 속도를 제공함. • RTX4090에서 최대 485 TOPS 성능을 달성하며, FlashAttention2와…
논문의 강점 및 독창적인 지점 Global Prefix Sharing의 명시적 적용 기존의 LLM 추론 엔진은 LRU 기반 캐시를 사용해 접두사(prefix)를 공유했지만, 이는 대규모 배치에서 최적화를 달성하지 못했습니다. BatchLLM은 전역적으로 접두사를 명시적으로 식별하고 관리하여 공유 접두사를…
결론 요약 논문은 긴 시퀀스에 대한 Transformer 기반 대형 언어 모델(LLM)의 추론 효율성을 크게 개선하는 Star Attention이라는 알고리즘을 제안했습니다. 기존 Ring Attention 대비 최대 11배의 추론 속도를 제공하면서도 정확도를 95100% 수준으로 유지합니다. Star…
결론 및 핵심 요약 이 논문은 LLM(대규모 언어 모델)의 효율적인 메모리 관리와 고성능 서빙을 위해 PagedAttention이라는 새로운 주의 알고리즘을 제안하며, 이를 기반으로 한 vLLM 시스템을 설계했습니다. 기존 시스템 대비 24배의 처리량 향상을 제공하며, 특히 메모리 낭비를 줄이고, 다양한…
논문의 강점과 독창성 스케일링 접근 방식의 혁신성: GShard는 6000억 개 이상의 파라미터를 가진 모델을 분산 TPU 클러스터에서 효과적으로 학습할 수 있도록 설계되었으며, 이를 통해 비용 효율적인 방식으로 초대형 신경망 모델을 학습할 수 있음을 입증했습니다. 6000억 파라미터 모델을 2048개의…
논문의 강점과 독창적인 지점 1. 강점 일반화된 병렬화 시스템: GSPMD는 다양한 병렬화 패턴(데이터 병렬화, 모델 병렬화, 파이프라인 병렬화)을 단일 프레임워크로 통합하여 모든 유형의 머신러닝 모델에서 사용할 수 있음. 사용자 주석(annotation)을 최소화하면서 모델을 대규모 장치 클러스터로 확…
논문의 주요 내용을 요약하자면, Orca 모델은 GPT-4와 같은 대형 언어 모델(LFM)의 복잡한 설명 과정(Reasoning Process)을 학습하여, 기존의 Instruction-tuning 모델들에 비해 뛰어난 성능을 보이는 13B 파라미터 모델입니다. Orca의 주요 혁신은 설명 튜닝…
논문의 핵심 요약 이 논문은 Mixture-of-Experts (MoE) 기반 대형 언어 모델(Mixtral-8x7B)을 제한된 GPU 메모리 환경에서 효율적으로 추론할 수 있는 방법을 제안합니다. 주요 기여는 다음과 같습니다: LRU 캐싱 및 Speculative Expert Loading 알고리즘을…
논문 분석: FlashAttention-2 FlashAttention-2는 기존 FlashAttention의 성능 병목을 개선하여 Transformer 모델의 Attention 연산에서 효율성을 극대화한 알고리즘입니다. 특히, GPU의 병렬성 활용을 최적화하여 긴 시퀀스를 다루는 데 있어 탁월한 성능을…
FlashAttention-3 논문 분석 FlashAttention-3는 Transformer의 Attention 연산을 최적화하여 성능과 메모리 효율성을 크게 향상시킨 알고리즘입니다. 이 논문은 기존 FlashAttention-2의 한계를 극복하며, NVIDIA Hopper GPU의 특화된 하드웨어 기…
요약 및 결론 이 논문, "FlashAttention", 은 Transformer 모델의 self-attention 모듈에서 메모리 및 계산 효율성을 극대화하기 위한 새로운 알고리즘을 제안합니다. 이를 통해 긴 시퀀스를 다루는 Transformer의 병목을 해소하며 기존 방법 대비 속도와 메모리 사용에서…
논문 요약 및 분석 논문의 강점 문제 정의의 명확성: 예측 불가능하고 폭발적인 워크로드 하에서 ML 추론 시스템이 지연(SLO)을 만족하면서 높은 정확도를 유지해야 하는 문제를 효과적으로 다룸. 독창적인 접근 방식 - SubNetAct: SubNetAct는 SuperNet을 활용하여 메모리 효율성과 지연…
논문의 강점과 독창적인 지점 효율적이고 정확한 Weight Update 논문은 Alternating Direction Method of Multipliers (ADMM) 기반의 효율적인 Layer-wise Weight Update 알고리즘을 제안합니다. 기존 Gradient Descent 기반 방법들…
논문의 강점과 독창적 지점 혁신적 구조: 이 논문은 State Space Models (SSMs) 기반인 Mamba와 Mixture of Experts (MoE) 방식을 결합한 MoE-Mamba 모델을 제안합니다. 이를 통해 SSM의 선형 시간 복잡도와 MoE의 효율적 확장성을 동시에 확보했습니다. 학습…
요약 논문의 제목: DeepSpeed-FastGen: High-throughput Text Generation for LLMs via MII and DeepSpeed-Inference 핵심 기여: Dynamic SplitFuse라는 새로운 방법론을 통해 긴 프롬프트 처리와 텍스트 생성 작업을 동적으로 결…
핵심 요약 논문의 제목: "MEDUSA: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads" 논문의 주요 기여: LLM의 추론 속도를 높이기 위해 추가적인 Decoding Head를 도입해 병렬적으로 다수의 토큰을 예측.…
논문의 강점 및 독창적인 지점 효율적인 병렬 디코딩: LOOKAHEAD DECODING은 기존의 자동회귀 디코딩의 한계를 극복하기 위해 설계되었으며, 여러 토큰을 병렬로 생성하면서도 정확성을 유지하는 점이 강점입니다. 이는 계산 자원을 효율적으로 활용하여 디코딩 속도를 최대 1.8배(단일 GPU 기준),…
강점과 독창성 효율적인 추론 가속화 이 논문은 대규모 언어 모델(LLM)의 추론 속도를 높이기 위해 Speculative Decoding 방식을 체계적으로 분석하고 최적화하는 데 초점을 맞추고 있습니다. 기존의 초안 모델 설계는 정확성 위주였으나, 이 논문은 초안 모델의 설계 방향을 폭넓고 얕은 구조로…
논문의 강점과 독창적인 지점 강점: 효율적인 프롬프트 캐싱 문제 해결: LLM의 높은 자원 소모 문제를 완화하기 위해 프롬프트 캐싱을 도입하고, 기존 임베딩 기반 접근법을 개선함. 기존 모델(Wang et al., 2022)의 AUC가 0.51인 데이터셋에서 이를 0.81로 향상. 정량적 성능 개선:…
논문의 강점과 독창적인 지점 FP6 기반의 효율적인 양자화 지원: 논문은 FP6(6-bit 부동소수점) 양자화의 중요성을 부각하며, 기존 4-bit 또는 8-bit 양자화보다 품질과 성능 간의 우수한 균형을 제공한다고 주장합니다. 이는 LLaMA-70B 모델과 같은 대규모 언어 모델에서 특히 두드러집니다…
논문 요약과 분석 핵심 요약 이 논문에서는 TP-Aware Dequantization이라는 새로운 방법을 제안하여 대형 언어 모델(LLM)의 분산 추론 과정에서 지연(latency)을 줄이는 최적화를 소개합니다. 이 방법은 텐서 병렬(Tensor Parallel, TP) 환경에서 데이터 국지성(data…
논문의 요약 논문 "Get More with LESS: Synthesizing Recurrence with KV Cache Compression for Efficient LLM Inference"는 대규모 언어 모델(LLM)의 추론에서 발생하는 키-값(KV) 캐시 메모리 병목 문제를 해결하기 위해…
논문의 핵심 요약 이 논문은 Hydragen이라는 새로운 방법을 소개하여, 공통 프리픽스를 공유하는 텍스트 배치에 대한 대규모 언어 모델(LLM) 추론을 최적화합니다. 이 방법은 특히 프리픽스와 서픽스에 대한 어텐션 계산을 분리하고, 인터-시퀀스 배칭을 통해 하드웨어 효율성을 극대화하여 GPU 메모리 대…
논문 요약 및 강점, 독창성 강점과 독창성: 주요 기여: 이 논문은 대규모 언어 모델(LLM) 추론에서 혼합 정밀도 General Matrix Multiplication (GEMM) 커널의 효율성을 높이기 위해 QUICK라는 새로운 CUDA 커널을 제안했습니다. - 기존 혼합 정밀도 커널의 병목 현상(특…
강점 및 독창성 요약 이 논문 TeraPipe는 Transformer 기반 언어 모델(Large Language Models, LLMs)의 훈련을 가속화하기 위한 Token-Level Pipeline Parallelism을 제안합니다. 주요 강점은 다음과 같습니다: 토큰 단위 병렬화: 기존의 마이크로배치…
강점 및 독창성 동적 맥락 정리 (Dynamic Context Pruning): 본 논문은 Transformer 기반 모델의 맥락 정보를 동적으로 삭제하는 새로운 접근 방식을 제안합니다. 이는 단순히 고정된 컨텍스트 창(window) 크기나 정적 토큰 압축 방식에 의존하지 않고, 학습된 메커니즘을 통해…
논문의 강점과 독창적인 지점 독창적인 접근법: Multi-query Attention 이 논문은 Transformer 모델의 효율성을 높이기 위해 기존 Multi-head Attention을 Multi-query Attention으로 대체하는 혁신적인 방식을 제안합니다. Multi-query…
논문 "GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints"를 분석한 내용을 아래에 정리하였습니다. 논문의 강점 효율성 향상: Multi-Query Attention (MQA)를 활용하여 메모리 대역폭 병…
논문의 강점 및 독창성 효율적인 KV 캐시 관리: H2O(H2 Heavy-Hitter Oracle)라는 새로운 캐시 제거 정책을 통해, LLM의 KV 캐시 크기를 줄이면서도 성능을 유지할 수 있는 방법을 제안합니다. 이는 기존 LRU 또는 LFU와는 차별화된 접근법으로, 중요한 토큰(Heavy…
논문의 강점 효율적인 메모리 관리: SCISSORHANDS는 KV 캐시 메모리를 최대 5배까지 압축하여 대규모 언어 모델(LLM)의 배치를 확장하는 데 유리합니다. 이 방법은 모델을 재학습하지 않고도 메모리 사용량을 감소시켜 기존 하드웨어에서 모델 효율성을 향상시킵니다. 이론적 정당성 및 실험적 검증:…
논문의 강점과 독창성 이 논문 H2O (Heavy-Hitter Oracle)는 대형 언어 모델(LLM)의 추론 과정에서 발생하는 KV 캐시 메모리 문제를 효율적으로 해결하기 위해 새로운 접근법을 제안합니다. 주요 강점과 독창성은 다음과 같습니다: 문제 해결의 중요성: 대형 언어 모델은 메모리 사용량이 높…
논문 "GLM-130B: An Open Bilingual Pre-Trained Model"에 대한 분석은 아래와 같습니다: 논문의 강점 및 독창성 대규모 공개 모델: GLM-130B는 1300억 개의 매개변수를 가진 대규모 언어 모델로, 영어와 중국어를 모두 다룹니다. 이 모델은 GPT-3(175B)와…
논문의 강점과 독창성 강점: 효율적인 압축 알고리즘: LLMLingua는 대형 언어 모델(LLM)의 프롬프트를 최대 20배까지 압축하면서도 성능 저하를 최소화했습니다. 이는 기존 연구와 비교하여 압축 비율과 성능 유지 면에서 큰 향상을 보여줍니다. 체계적인 프레임워크: Budget Controller:…
논문의 상세 분석 1. 요약과 강점 "No Token Left Behind: Reliable KV Cache Compression via Importance-Aware Mixed Precision Quantization"라는 제목의 이 논문은 Mixed-precision KV cache (MiKV)라는…
논문 요약과 분석 이 논문은 구글 연구팀이 작성한 "Scaling Instruction-Finetuned Language Models"로, 대규모 언어 모델(예: PaLM, T5)을 Instruction Fine-Tuning 기법으로 미세조정하여 새로운 작업에 대한 일반화 능력을 크게 향상시키는 방법을…
논문 "CacheGen: KV Cache Compression and Streaming for Fast Large Language Model Serving"에 대한 분석을 아래와 같이 제공합니다. 강점 및 독창성 강점 효율적인 KV 캐시 전송 및 로딩: CacheGen은 LLM의 KV 캐시를 압축하여 전…
논문의 제목: CHAI: Clustered Head Attention for Efficient LLM Inference 논문의 주요 내용 요약 이 논문은 대규모 언어 모델(LLM)의 추론 시 발생하는 메모리 및 계산 병목현상을 줄이기 위해 Clustered Head Attention (CHAI)를 제안합…
논문에서 다루는 내용인 "Galactica: A Large Language Model for Science"를 바탕으로 요청하신 논문 분석을 다음과 같이 수행했습니다: 논문의 강점 과학 데이터에 특화된 대규모 언어 모델 개발 Galactica는 과학적 지식과 데이터를 효율적으로 저장, 결합, 추론할 수…
논문의 주요 내용, 강점, 독창성, 알고리즘 예시, 한계점 논문의 개요 논문 "LongLLMLingua: Accelerating and Enhancing LLMs in Long Context Scenarios via Prompt Compression"은 대규모 언어 모델(LLM)이 긴 문맥을 처리할 때…
논문 제목은 "Get More with LESS: Synthesizing Recurrence with KV Cache Compression for Efficient LLM Inference"입니다. 논문에서 제안된 LESS(Low-rank Embedding Sidekick with Sparse…
강점과 독창성 효율적이고 튜닝이 필요 없는 2비트 양자화 알고리즘: KIVI는 LLM의 키-값 캐시(KV Cache)를 튜닝 없이 2비트로 양자화하여 최대 2.6배 메모리 감소와 최대 3.47배 처리량 증가를 달성합니다. 기존 연구와 달리 키 캐시는 채널별로, 값 캐시는 토큰별로 양자화하는 새로운 방식을…
논문 "KVQuant: Towards 10 Million Context Length LLM Inference with KV Cache Quantization"은 초대형 문맥 창 길이를 가진 대규모 언어 모델(LLM)에서 효율적인 추론을 가능하게 하는 방법론을 제안합니다. 아래는 논문의 강점, 독창적인 지…
논문 요약: "No Token Left Behind: Reliable KV Cache Compression via Importance-Aware Mixed Precision Quantization"는 대규모 언어 모델(LLM)의 추론 시 발생하는 메모리 병목 현상을 해결하기 위한 Key-Value(KV)…
강점과 독창적인 지점 WKVQuant은 대규모 언어 모델(LLM)의 메모리 사용 문제를 해결하기 위해 설계된 Post-Training Quantization (PTQ) 프레임워크입니다. 주요 강점과 독창적 특징은 다음과 같습니다: 효율성과 정확성의 균형: 기존 방식(Weight-Only…
논문의 요약 PowerInfer는 소비자용 GPU로 대형 언어 모델(LLM)을 빠르게 추론할 수 있도록 설계된 시스템입니다. LLM 추론에서 고도 국소성을 활용하여 GPU와 CPU의 협력을 통해 효율성을 극대화합니다. 주요 기여 Hot & Cold Neuron 분리: 자주 활성화되는 "hot…
논문 요약: ALISA: 대규모 언어 모델 추론 가속화를 위한 희소성 기반 KV 캐싱 이 논문은 대규모 언어 모델(LLM)의 추론 속도를 개선하기 위해 ALISA라는 새로운 알고리즘-시스템 공동 설계 방안을 제시합니다. 특히, GPU 메모리가 제한된 환경에서 LLM 추론 효율을 극대화하기 위한 다양한 방…
논문 분석: Fast Inference from Transformers via Speculative Decoding 논문의 강점 속도 향상: Speculative Decoding 기법을 통해 기존의 T5-XXL과 같은 대규모 모델보다 2배에서 3배 빠른 추론 속도를 달성. 모델 수정 불필요: 모델 아키텍…
논문의 강점과 독창성 강점: 과제 무관 압축(Task-Agnostic Compression): LLMLingua-2는 특정 과제에 의존하지 않는 프롬프트 압축 모델로, 다양한 도메인과 과제에 일반화할 수 있는 능력을 갖추고 있습니다. 효율성: 모델은 적은 크기의 데이터로 훈련되고 작은 모델…
논문은 Direct Preference Optimization (DPO)라는 새로운 방법을 제안하며, 인간 선호 데이터 기반으로 대규모 언어 모델(LLM)을 효율적으로 미세 조정(fine-tuning)하는 과정을 크게 간소화합니다. 아래는 논문의 주요 기여점, 강점, 핵심 알고리즘 설명, 한계점에 대한…
논문 요약 및 분석 논문 제목: Hierarchical Context Merging: Better Long Context Understanding for Pre-Trained LLMs 핵심 내용: 이 논문은 대형 언어 모델(LLMs)의 문맥 길이 제한 문제를 해결하기 위해…
논문 요약 및 평가 논문의 주요 내용 및 독창성 이 논문은 "MELTing Point: Mobile Evaluation of Language Transformers"로, 모바일 및 엣지 디바이스에서 대형 언어 모델(LLM)의 실행 가능성을 평가하는 것을 목표로 합니다. 이를 위해 MELT라는 자동화된 벤…
논문의 주요 강점 및 독창성 논문은 Google Research의 Flan-T5 및 Flan 2022 데이터를 중심으로, 지시 조정(instruction tuning)의 방법론적 개선을 제시하며 이를 통해 상당한 성능 향상을 입증합니다. 주요 강점과 독창성을 다음과 같이 요약할 수 있습니다. 효율적인 지…
논문 "Tree of Thoughts: Deliberate Problem Solving with Large Language Models"는 대형 언어 모델(LLM)을 활용한 문제 해결 능력을 향상시키기 위해 "사고의 나무(Tree of Thoughts, ToT)"라는 새로운 프레임워크를 제안합니다. 아래…
논문의 강점, 독창성, 핵심 알고리즘, 그리고 한계점에 대한 분석 논문의 강점 효율적인 메모리 사용: LLM 추론 과정에서 가장 큰 병목 중 하나인 키-값(KV) 캐시 메모리를 최적화하여 최대 70%까지 메모리 사용을 줄였습니다. 기존 모델 성능을 거의 유지하면서도 메모리 효율성을 대폭 향상했습니다. 추…
논문의 주요 내용 분석 논문의 강점 무한 컨텍스트 처리 능력: Infini-attention은 Transformer 모델의 기존 한계를 극복하며, 무한 길이의 입력을 효율적으로 처리할 수 있도록 설계되었습니다. 이는 긴 문맥의 언어 모델링과 책 요약 작업에서 우수한 성능을 보입니다. 효율성:…
논문 요약: Mistral 7B Mistral 7B는 70억 개의 매개변수를 가진 언어 모델로, 효율성과 성능을 모두 갖춘 모델을 목표로 설계되었습니다. 이 모델은 OpenAI의 Llama 2와 같은 기존 모델을 다양한 벤치마크에서 능가하며, 특히 수학, 코드 생성, 논리 추론에서 탁월한 성능을 보입니다…
논문의 강점 및 독창적인 지점 이 논문은 SqueezeAttention이라는 2D KV-캐시 압축 알고리즘을 제안하여 대형 언어 모델(LLM)의 추론 효율성을 개선하는 방법을 소개합니다. 주요 강점과 독창적인 지점은 다음과 같습니다: 레이어별 중요도 반영: 기존 방법들은 모든 레이어에 동일한 캐시 예산을…
논문의 강점 및 독창적 기여 이 논문, "Toward Inference-optimal Mixture-of-Expert Large Language Models", 은 대규모 언어 모델에서 Mixture-of-Experts (MoE) 접근법을 연구하며, 주요 기여는 다음과 같습니다: MoE 모델 확장성에 대…
이 논문 "MobileAIBench: Benchmarking LLMs and LMMs for On-Device Use Cases"의 주요 내용을 자세히 분석하고 요약하겠습니다. 또한 논문의 강점, 독창적인 점, 알고리즘 설명, 한계점 등을 정리하겠습니다. 논문의 주요 내용 이 논문은 모바일 기기에서…
논문 "PowerInfer-2: Fast Large Language Model Inference on a Smartphone"은 스마트폰에서 대형 언어 모델(LLM)을 효과적으로 실행하기 위한 혁신적인 프레임워크인 PowerInfer-2를 소개합니다. 아래는 논문에 대한 상세 분석입니다: 강점과 주요 기…
논문 "RAGCache: Efficient Knowledge Caching for Retrieval-Augmented Generation"는 Retrieval-Augmented Generation (RAG) 시스템의 효율성을 높이기 위해 제안된 다단계 캐싱 시스템을 소개합니다. 이 시스템은 외부 지식을…
논문의 주요 내용 및 독창적인 점 논문의 강점과 독창적인 점 트리 기반 추측적 추론 (Tree-based Speculative Inference): 기존의 순차적 디코딩 또는 단일 시퀀스 기반 추측적 추론과 달리, SpecInfer는 트리 구조를 활용하여 여러 후보 토큰을 동시에 추론합니다. 이는…
논문 "SKVQ: Sliding-window Key and Value Cache Quantization for Large Language Models"는 대규모 언어 모델(LLMs)이 긴 문맥을 처리할 때 발생하는 메모리와 계산 부담을 줄이기 위해 새로운 양자화(Quantization) 전략을 제안하고…
논문의 강점과 독창적인 지점 강점: 효율적인 메모리 사용: LoCoCo는 고정된 크기의 Key-Value (KV) 캐시를 활용하여, 긴 문맥에서도 메모리 사용량을 크게 줄입니다. 기존 방법들과 달리, 문맥 손실을 최소화하며 효율적으로 작동합니다. 데이터 기반 융합 기법: 기존의 경험적 KV 제거 방식 대…
논문 "Loki: Low-rank Keys for Efficient Sparse Attention"에 대한 상세한 분석을 제공하겠습니다. 이 논문은 자가회귀 기반의 대규모 언어 모델(LLM)에서 사용되는 자가주의 메커니즘의 계산 및 메모리 병목 현상을 개선하기 위한 새로운 방법론을 제안합니다. 강점과 독…
강점 및 독창성 논문 MiniCache: KV Cache Compression in Depth Dimension for Large Language Models는 대형 언어 모델(LLM)에서의 메모리 효율성을 향상시키기 위한 혁신적인 접근 방식을 제시합니다. 이 논문의 주요 강점과 독창성은 다음과 같습니다…
논문의 강점과 독창성 1. 독창적인 기여: Cross-Layer Attention (CLA): 기존의 Multi-Query Attention (MQA)와 Grouped-Query Attention (GQA)이 개별 레이어에서 키-값(KV)을 공유했던 방식과 달리, CLA는 인접 레이어 간에 키-값을 공유…
논문의 주요 강점 및 독창성 강점: 효율성 증대: 기존의 KV 캐시 감소 방법들은 주로 attention score에 의존했으나, 본 논문은 value vector의 ℓ1 노름을 추가적으로 고려함으로써 더 효과적인 pruning을 구현했습니다. 이는 기존 방법 대비 여러 과제에서 더 나은 성능을 보였습니…
논문의 요약 이 논문은 MLKV (Multi-Layer Key-Value Sharing)라는 새로운 방법을 제안하여 Transformer 모델에서 KV(Key-Value) 캐시 메모리 사용량을 효율적으로 줄이는 방안을 탐구합니다. 기존 MQA(Multi-Query Attention) 및…
논문의 분석: LazyLLM - DYNAMIC TOKEN PRUNING FOR EFFICIENT LONG CONTEXT LLM INFERENCE 강점 및 독창적인 지점 효율적 인퍼런스: LazyLLM은 긴 문맥을 처리하는 LLM의 효율성을 향상시키는 새로운 토큰 제거 방법을 제안합니다. 특히, 첫 번째…
논문 분석: "PQCache: Product Quantization-based KVCache for Long Context LLM Inference" 1. 강점 및 독창성 강점 메모리 효율성: - KVCache의 메모리 사용 문제를 해결하기 위해 Product Quantization(PQ)를 활용하여 메…
논문의 주요 내용 및 강점 강점 및 독창성: 기존 문제점 개선: 기존 Accumulative Attention Score (A2S) 기반 토큰 정리 방법은 Transformer Decoder 구조에서 공정하지 못한 토큰 비교 문제를 야기했습니다. 논문은 이를 Masked Self-Attention의…
논문을 분석하고 요청하신 내용을 세부적으로 정리해보겠습니다. 논문의 강점 및 독창성 주요 강점: 효율적인 KV-Cache 압축: 기존의 키-값 캐시(KV-Cache) 압축 방식(토큰 샘플링, 양자화)보다 잠재적 차원에서의 중복을 활용하여 효율적으로 캐시를 압축합니다. 최대 50%의 메모리 절감과 1.89…
논문의 주요 내용 분석 및 평가 논문의 강점과 독창성 이 논문은 Double Sparsity라는 새로운 방식의 사후 훈련 희소화 기법을 제안하며, 다음과 같은 독창적인 요소를 포함합니다: 이중 희소화 (Double Sparsity) 기법: Token Sparsity: 중요한 토큰만 선택하여 연산을 수행해…
논문의 주요 내용 및 강점 논문의 목적 RetrievalAttention은 대규모 언어 모델(LLM)의 긴 문맥 처리에서 발생하는 연산 복잡성과 GPU 메모리 사용량 문제를 해결하기 위해 제안된 방법입니다. 이 방법은 주의 메커니즘의 동적 희소성을 활용하여, CPU 메모리에 있는 키-값(KV) 벡터를 근…
논문 "Discovering the Gems in Early Layers: Accelerating Long-Context LLMs with 1000x Input Token Reduction"은 대규모 언어 모델(LLMs)에서 긴 문맥 입력 처리 시 발생하는 계산 및 메모리 문제를 해결하기 위해 새로운 접…
논문 개요 InfiniPot는 메모리 제약 환경에서 기존의 대규모 언어 모델(LLM)이 긴 문맥을 처리할 수 있도록 설계된 새로운 Key-Value(KV) 캐시 제어 프레임워크입니다. 추가적인 훈련 없이, InfiniPot은 긴 문맥에서도 핵심 정보를 유지하며 효과적으로 처리할 수 있는 Continual…
논문 "TACO-RL: Task Aware Prompt Compression Optimization with Reinforcement Learning"의 주요 내용을 분석한 결과, 강점, 독창성, 핵심 알고리즘, 그리고 한계점을 아래와 같이 정리했습니다. 논문의 강점 문제 해결의 중요성: LLM…
논문의 강점 및 독창적인 지점 강점: 실제 활용 가능성: LORC(Low-Rank Compression for LLMs KV Cache)는 미리 훈련된 대형 언어 모델(LLM)에 바로 적용할 수 있어 재훈련이나 세부적인 튜닝 없이 사용할 수 있습니다. 이는 배포 과정에서의 복잡성을 크게 줄여줍니다. 이론…
논문의 분석: "SWIFTKV: FAST PREFILL-OPTIMIZED INFERENCE WITH KNOWLEDGE-PRESERVING MODEL TRANSFORMATION" 논문의 주요 강점과 독창성 독창적인 구조 최적화: SingleInputKV: 초기 입력 토큰에 대해 마지막 레이어 일부를 스킵하…
강점 및 독창성 TidalDecode의 주요 강점과 독창성은 다음과 같습니다: 위치 지속 희소 주의(Position Persistent Sparse Attention, PPSA): 기존 희소 주의(sparse attention) 메커니즘에서 각 층마다 독립적으로 선택했던 중요한 토큰을 사용하지 않고, 여…
논문 제목: TorchTitan: One-stop PyTorch native solution for production ready LLM pre-training 논문의 강점과 독창성 PyTorch 기반 통합 솔루션: TorchTitan은 PyTorch-native 분산 훈련 시스템으로, 대규모 언어 모델…
논문의 강점 및 독창성 문제의 명확성: 대규모 언어 모델(LLM)에서 KV-Cache가 메모리 및 계산 병목 현상을 유발한다는 문제를 잘 정의하고 있습니다. 이는 대규모 모델과 긴 컨텍스트 쿼리를 처리할 때 중요한 병목 요소로 작용합니다. 독창적인 접근: Attention-Gate (AG) 메커니즘은 학…
논문 제목: Scaling Laws for Neural Language Models 강점 및 독창성: 스케일링 법칙 발견: 모델 성능이 매개변수 수(N), 데이터 크기(D), 학습에 사용된 계산량(C)에 따라 일정한 파워 법칙을 따른다는 점을 체계적으로 분석. 이러한 법칙은 7개 이상의 크기 차수에 걸쳐…
논문의 강점 효율성 및 간결성: SimLayerKV는 7줄의 코드로 구현 가능하며 기존의 복잡한 알고리즘들과 달리 간단하면서도 강력한 성능을 제공합니다. 이는 모델 최적화를 쉽게 수행할 수 있는 실용적인 솔루션으로서 주목받을 만합니다. 훈련 불필요: 추가적인 모델 훈련 없이 기존의 사전 훈련된 모델에서…
논문의 주요 내용 분석 및 설명 이 논문에서는 코드 생성 작업을 위한 phi-1이라는 소형 대규모 언어 모델(LLM)을 제안합니다. 이 모델은 1.3억 개의 파라미터를 가진 Transformer 기반 모델로, 제한된 리소스(8개의 A100 GPU에서 4일간 훈련)를 활용해 높은 성능을 달성했습니다. 주요…
논문 요약: "MagicPIG: LSH Sampling for Efficient LLM Generation" 논문의 배경 및 문제 정의 최근 GPT, Llama 등과 같은 대형 언어 모델(LLM)은 긴 문맥을 활용한 응용에서 주목받고 있습니다. 하지만, 이 모델들은 키-값(KV) 캐시로 인한 병목 현상…
논문 "TokenSelect: Efficient Long-Context Inference and Length Extrapolation for LLMs via Dynamic Token-Level KV Cache Selection"에 대해 분석한 내용을 아래와 같이 정리하겠습니다. 논문의 강점 및 독창성 이…
논문의 강점 및 독창적인 지점 이 논문은 Hybrid Autoregressive Transformer (HART)라는 새로운 이미지 생성 모델을 제안하며, 이 모델은 특히 높은 효율성을 자랑합니다. HART는 1024x1024 해상도의 이미지를 직접 생성할 수 있으며, 기존의 확산 모델과 비교하여 다음과…
이 논문은 "Learning Transferable Visual Models From Natural Language Supervision"이라는 제목을 가진 CLIP (Contrastive Language-Image Pre-training) 모델에 대한 연구입니다. 논문의 핵심 내용 및 강점 기존 접근…
논문 분석: The COT Collection: Improving Zero-shot and Few-shot Learning of Language Models via Chain-of-Thought Fine-Tuning 논문의 강점 및 독창적인 지점 (1) 문제 정의 및 기여 이 논문은 소형 언어 모델…
논문 요약 및 강점 분석 논문 제목: VILA-U: A Unified Foundation Model Integrating Visual Understanding and Generation 논문의 주요 목표 및 독창적인 접근 방식 VILA-U는 텍스트와 비주얼(이미지/비디오)의 이해 및 생성 작업을 단일 모…
논문의 강점과 독창적인 지점 이 논문은 Batch Calibration (BC)이라는 새로운 기법을 제안하여 대형 언어 모델(LLMs)에서 In-Context Learning (ICL)과 프롬프트 엔지니어링에서 발생하는 다양한 바이어스 문제를 해결합니다. 이 방법은 기존의 교정 기법들이 가지는 한계를 극…
논문 분석: 강점, 독창적인 지점, 핵심 알고리즘 설명 및 한계점 이 논문은 Correlation Clustering 문제를 다루며, 특히 노이즈가 있는 환경에서의 효율적인 쿼리 방식을 제안합니다. 논문에서 제안된 접근법은 다중 무장 밴딧(Combinatorial Multi-Armed Bandits,…
논문의 강점 및 독창적인 지점 ShadowKV는 긴 문맥을 가진 대형 언어 모델(LLM)에서 고속 추론을 가능하게 하는 시스템으로, 다음과 같은 강점과 독창적인 요소를 갖추고 있습니다: 메모리 사용 최적화: ShadowKV는 로우랭크(low-rank) 접근 방식을 활용하여 GPU 메모리 사용량을 크게 줄…
논문 "COMET: Towards Practical W4A4KV4 LLMs Serving"는 대형 언어 모델(LLMs)을 효과적으로 배포하기 위해 양자화(quantization) 기법을 활용하여 GPU 성능을 최적화하는 방법을 제안합니다. 특히 INT4 텐서 코어를 활용해 모델의 메모리 사용량과 계산 효…
이 논문 "Epic: Efficient Position-Independent Context Caching for Serving Large Language Models"는 대형 언어 모델(LLM) 추론 속도를 높이기 위한 위치 독립적 컨텍스트 캐싱(Position-Independent Context…
논문 분석 강점과 독창적인 지점 이 논문 "ALPINE: Unveiling the Planning Capability of Autoregressive Learning in Language Models"에서는 Transformer 기반 언어 모델의 경로 탐색 및 계획 능력을 분석하고 확장 가능한 알고리즘을…
논문 분석: "Can Graph Learning Improve Planning in LLM-based Agents?" 강점과 독창적인 지점 언어 모델과 그래프 학습의 통합: 이 논문은 대형 언어 모델(LLM)과 그래프 신경망(GNN)을 결합하여 복잡한 작업 계획(task planning)을 개선하려는 시…
논문 분석: "MInference 1.0: Accelerating Pre-filling for Long-Context LLMs via Dynamic Sparse Attention" 강점과 독창적인 지점 효율적인 긴 문맥 처리: 이 논문은 긴 문맥을 처리하는 대형 언어 모델(LLM)의 추론 속도를 개선하는…
물론입니다. 논문의 주요 내용과 강점, 알고리즘 과정, 한계점에 대해 한국어로 설명드리겠습니다. 강점 및 독창성 향상된 통신 중첩: Flux는 GPU에서 종속 계산과 통신 작업을 매우 세밀한 단위로 분해하고 결합하여 최대 96%까지 통신 지연을 숨깁니다. 이 방식은 대규모 언어 모델의 분산 학습 및 추론…
논문의 강점과 독창성 1. 독창적인 KVSharer 방식: 이 논문은 LLM(대형 언어 모델)에서 메모리 사용량을 줄이기 위해 KVSharer라는 새로운 계층 단위의 KV(키-값) 캐시 공유 기법을 제안합니다. 기존 방식은 유사한 KV 캐시를 공유하여 메모리를 절약하려고 했지만, KVSharer는 비유사…
업로드된 논문은 DNN(딥 뉴럴 네트워크)의 성능을 개선하기 위해 커널 오케스트레이션을 최적화하는 텐서 프로그램 최적화 도구인 Korch에 대해 다루고 있습니다. 아래는 논문의 강점, 독창성, 핵심 알고리즘 예시와 한계점에 대한 설명입니다. 강점 및 독창성 운영자 분해와 세밀한 최적화: Korch는 "운…
논문 "SpotServe: Serving Generative Large Language Models on Preemptible Instances"는 대형 언어 모델(LLM)을 경제적인 프리엠티브 인스턴스에서 효율적으로 서빙할 수 있는 새로운 분산 시스템 SpotServe를 제안합니다. 이 논문의 주요 강…
개인의견 : pipeline Parallelism에 관련된 논문을 몇개 봤는데 그 중에서 가장 재밋는 논문인것 같네요. graph의 toplogy-aware Pipeline Parallelism이라는 당연한 개념을 포함하여 효과적인 결과를 내는것 같습니다. 다만 구현에 대한 오버헤드는 쫌 있을꺼같군요 논…
논문에서는 Helix라는 시스템을 소개하며, 이 시스템은 이기종(heterogeneous) GPU 클러스터 상에서 대규모 언어 모델(LLM)을 분산적으로 제공하기 위해 설계되었습니다. Helix의 주요 강점과 독창성, 핵심 알고리즘 예시, 한계점을 다음과 같이 정리해드립니다. 강점과 독창적인 지점 이기종…
이 논문, "Memory Bounds for the Experts Problem"는 전문가 조언을 이용한 온라인 학습 문제에 대한 메모리 제약을 다루고 있습니다. 전통적으로 전문가 예측에 기반한 알고리즘은 매일 예측을 처리하고, 최고의 전문가와 비교하여 손실을 최소화하도록 설계됩니다. 본 논문에서는 이러…
개인의견 : 패치 기반의 병렬 연산과 Cross-Attention을 통한 글로벌-로컬 상호작용, 그리고 토크나이저 free? 한 신기한 논문으로 보인다. 논문 요약: MEGABYTE의 강점과 독창성 이 논문은 MEGABYTE라는 모델을 소개하며, 기존의 Transformer 모델이 긴 시퀀스(수백만 바이…
개인의견 : 타겟은 다르지만 deepspeed(zero) 오프로딩을 한다는 측면에서는 비슷한 느낌을 받았다 그리고 정말 높은 throughtput을 위해서 quantization과 선형계획법으로 효율적으로 디바이스 사용을 가능하게 하는 방법으로 보인다. 다만 한계점으로 말하듯 TTFT(Time to…
개인의견 : 역시 songhan.. KV cache는 항상 볼때마다 압축을 하거나 줄이고 싶지만 그 특성상 query와 관계를 알아야 이게 중요한 KV였다는걸 알 수 있어 고육지책으로 들고다녀야하는 부담이라고 생각이 드는데 이걸 참 재밋게 풀어 경량화를 하는거 같아서 흥미롭게 읽었습니다. 논문의 강점과…
개인의견 : 내가 잘 이해를 한건지는 모르겠지만 결국 입력/출력의 cosine similarity를 보고 attention layer를 pruning 하겠다는것 같은데 이게 데이터셋의 분포 혹은 성향이 달라졌을때 잘 동작할지는 납득이 쉽게 되지 았았다. 하지만 최근LLM의 크기가 점점 커져가고 있는 가운…
개인의견 : rag가 앞으로 정말 많이 사용될거 같은데 어떻게보면 이러한 방법론을 사용하여 kv cache를 partial하게 사용하고 update를 하는 방법에 대한 논문이군요 논문의 강점과 독창성 논문 "CacheBlend: Fast Large Language Model Serving for RAG…
개인의견 : 예전부터 KV cache중에 핵심이 되는 내용만 잘 선택하면 오버헤드를 줄일수 있지 않을까라고 생각했는데 핵심 토큰만 가지고 이러한 방법을 구현한 논문입니다. 이러한 논문을 볼때 마다 항상 과연 정확도에 얼마나 영향을 줄까라는 의심이 생길수 밖에 없지만 이렇게 알고리즘쪽에서 경량화를 많이 해…
개인의견 : 서비스를 하는 수준에서 생각하면 continuous batching같은 테크닉을 사용하면 prefill을 스케줄을 어떠한 방식으로 할지가 궁금했는데 이러한 방법으로 stall을 줄이다니 재밋는 논문이네요. 다만 prefill의 stall을 줄이기 위해서 decode는 불필요하게…
제목 Fast and Effective Orchestration of Compiler Optimizations 저자 Zhelong Pan,Rudolf Eigenmann Motivation compile-time optimizations 은 전반적으로 프로그램 성능을 향상시키지만 일부 기법은 성능 하락을…
제목 TVM: An Automated End-to-End Optimizing Compiler for Deep Learning TVM? 해당논문은 머신러닝용 컴파일러중에 대표적인 TVM에 대한 paper입니다. 현재는 apache에서 관리 하고 있으며 graph level IR 을 통한…
제목 NeuroVectorizer: End-to-End Vectorization with Deep Reinforcement Learning 저자 Ameer Haj-Ali, Nesreen K. Ahmed, Ted Willke, Sophia Shao, Krste Asanovic, Ion Stoica…