FlashMask-3: Efficient and Expressive Mask-Aware Distributed Attention
FlashMask-3의 Hopper 커널과 마스크 국소화, 부하 균형, 통신 중첩을 분석하고 장문 훈련 실험의 조건과 한계를 짚습니다.
FlashMask-3의 Hopper 커널과 마스크 국소화, 부하 균형, 통신 중첩을 분석하고 장문 훈련 실험의 조건과 한계를 짚습니다.
Flash-dLLM: I/O를 먼저 본 Diffusion LLM 가속, 퓨즈드 캐시와 셀프 검증으로 210.6 tokens/s 를 열다 한 줄 요약 (TL;DR) Diffusion LLM(dLLM)은 병렬 디노이징이 가능하지만 KV 캐시 재사용과 병렬 디코딩을 함께 쓰면 GPU 메모리 I/O가 병목이 된…
VC-Attention은 비디오 Diffusion Transformer의 저비트 어텐션에서 값 양자화 오차와 softmax 병목을 함께 줄여 B200에서 어텐션을 최대 1.59배 가속한 학습-프리 커널이다.
FP4 텐서 코어가 빨라도 어텐션은 왜 안 빨라지는가: Direct-P와 양자화된 역전파로 푼 Blackwell FlashAttention-4 TL;DR — Blackwell의 FP4 텐서 코어는 행렬곱을 BF16보다 훨씬 빨리 처리하지만, 어텐션은 행렬곱 두 개 사이에 softmax 라는 "중간 작업"…

Structured State Space Duality: Mamba-2로 본 SSM↔Attention 통일과 2–8× 가속 한 줄 요약 (TL;DR) SSD(Structured State-Space Duality) 는 SSM과 마스킹 어텐션이 동일 함수를 서로 다른 수축 순서로 계산한다는 통찰을 제시하고…

Hydragen: 공유 프리픽스가 있는 대규모 배치를 32 × 빠르게 디코딩하는 비밀 병기 한 줄 요약 (TL;DR) Softmax 분모 재스케일링으로 프리픽스-서픽스를 분해해 Code-Llama-13 B 기준 vLLM보다 최대 32배 빠르게, 동일 출력을 보장하며 장문·대규모 배치 디코딩을 가속한다.…
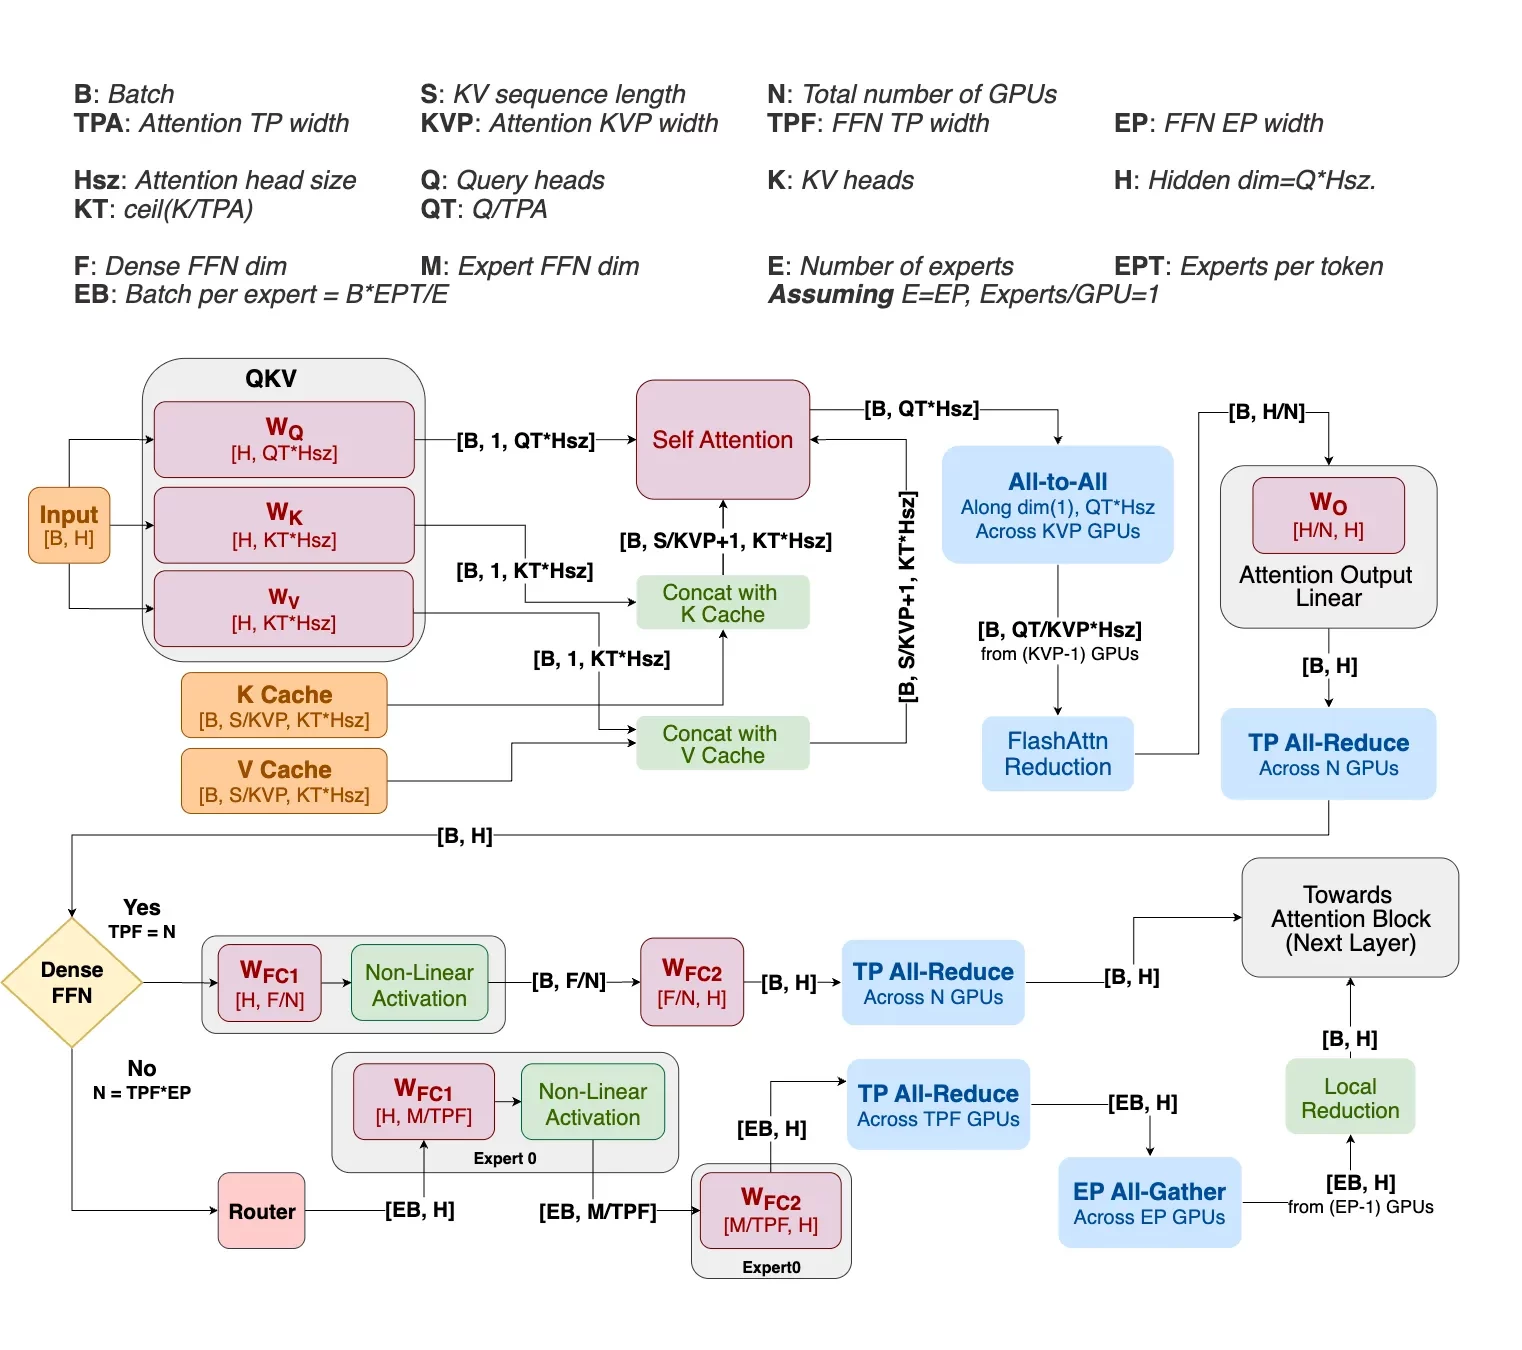
Helix Parallelism: 초장기 LLM 디코딩의 지연-처리량 벽을 깨다 한 줄 요약 (TL;DR) Helix Parallelism은 Attention과 FFN을 서로 다른 병렬화 전략으로 스케줄링해 KV 캐시 중복과 FFN 가중치 로드 병목을 동시에 해소—1 M 토큰 컨텍스트에서 토큰 지연을 최…
Native Sparse Attention (NSA) — 64 k 토큰도 11× 빠르게, 정확도는 그대로 한 줄 요약 (TL;DR) NSA는 ‘압축 → 선택 → 슬라이딩’ 3 분기 희소 어텐션과 GQA/MQA-친화 커널을 결합해 64 k 컨텍스트에서 디코딩 속도를 11.6 배, 학습 속도를 최대 9 배…
⚡️TL;DR KVzip는 LLM의 KV 캐시를 한 번 압축해도 이후 모든 질의 · 세션에서 재사용할 수 있도록 설계된 query-agnostic 캐시 컴프레서다. 그 결과 정확도 손실 ≤ 3 pp를 유지하면서 레이턴시 2 × ↓, 메모리 60–394 × ↓를 동시에 달성한다. 핵심 아이디어 “프리필은…