MC-Sparse: 확산 모델의 희소 어텐션이 느려지는 세 가지 이유
MC-Sparse가 DiT의 희소 어텐션에서 품질과 속도 손실을 분리하는 방법을 살펴봅니다. 토큰 선택뿐 아니라 커널 실행 비용을 함께 줄여야 하는 이유를 정리합니다.
MC-Sparse가 DiT의 희소 어텐션에서 품질과 속도 손실을 분리하는 방법을 살펴봅니다. 토큰 선택뿐 아니라 커널 실행 비용을 함께 줄여야 하는 이유를 정리합니다.
VC-Attention은 비디오 Diffusion Transformer의 저비트 어텐션에서 값 양자화 오차와 softmax 병목을 함께 줄여 B200에서 어텐션을 최대 1.59배 가속한 학습-프리 커널이다.
Programmable World Model — 생성형 월드에 "실행 가능한 상태"를 심다 한 줄 요약 (TL;DR) 비디오 월드 모델은 점점 더 사실적인 인터랙티브 환경을 만들어내지만, 화면에 잠깐 스친 픽셀만 기억할 뿐 "세상이 지금 실제로 어떤 상태인지"는 알지 못한다. Alaya Lab의…
CoVeR: 지오메트리만으로 멀티뷰 3D 추론의 비주얼 토큰을 92%까지 덜어내는 커버리지 기반 프루닝 한 줄 요약 (TL;DR) 3D 장면을 여러 시점 이미지로 렌더링해 2D VLM에 넣으면 토큰이 시점 수에 비례해 폭증한다. CoVeR는 학습 없이 오직 토큰의 3D 좌표만 사용해 장면 전체를 균등하게…
Marigold V2: 이미지 편집 확산 트랜스포머(DiT)를 단안 깊이 추정기로 되살리기 한 줄 요약 (TL;DR) Qwen-Image-Edit-2509라는 이미지 편집용 확산 트랜스포머(DiT)를 4-bit QLoRA로 파인튜닝해, 단일 32GB GPU에서 약 1주일 만에 단안 깊이 추정 SOTA를…
ShallowStream: 얕게 인덱싱하고, 깊게 답하라 — 스트리밍 비디오 이해의 계산 병목을 푸는 방법 TL;DR — 스트리밍 비디오 이해에서 가장 비싼 비용은 매 프레임을 MLLM의 전체 깊이(2832개 레이어) 로 prefill하는 것이다. ShallowStream은 얕은 레이어 45개 만으로 프…
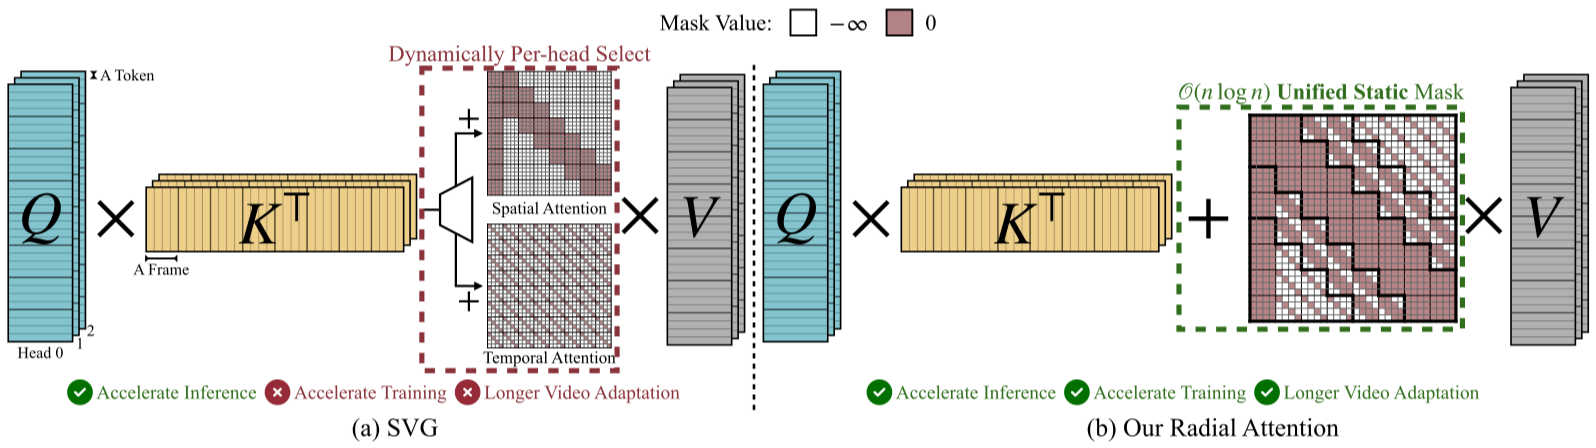
Radial Attention: O(n log n) Sparse Attention with Energy Decay로 “긴 비디오”를 싸게 뽑기 한 줄 요약 (TL;DR) 사후(softmax 이후) attention 에너지가 거리(시간/공간)와 함께 지수적으로 감쇠 한다는 관찰을 바탕으로, 계산 밀도도 같…
MMInference 논문 리뷰: VLM의 긴 컨텍스트 추론, '순열'로 속도의 벽을 넘다 최근 Vision Language Model(VLM)은 이미지와 텍스트를 넘어 긴 비디오까지 이해하는 능력으로 무한한 가능성을 보여주고 있습니다. [cite\start]하지만 수백만 개의 토큰으로 이루어진 긴 비디…
✅ 결론 요약 (핵심 강점 및 독창성) Seedream 2.0은 중국어와 영어 모두를 native하게 이해하고 시각화하는 최초 수준의 이중언어 텍스트-이미지 생성 모델이다. 주요 강점은 다음과 같다: 🔍 핵심 알고리즘 및 전체 파이프라인 (예시 기반 설명) 입력 프롬프트 예시: 전체 파이프라인 흐름 핵심…
✅ 결론 요약 이 논문은 "메모리 용량을 초과하는 대규모 데이터셋에서 대표적인 subset을 효율적으로 선택"하는 문제를 다룬다. 기존 방법들은 중앙 서버가 전체 subset을 메모리에 올릴 수 있어야 한다는 제약이 있었지만, 이 논문은 중앙 서버 없이도 분산 환경에서 고품질 subset을 선택할 수 있…
논문 『VoLUT: Efficient Volumetric Streaming Enhanced by LUT-based Super-resolution』을 분석하여 핵심 사항을 아래와 같이 압축하여 전달하고, 강점과 독창성, 알고리즘의 동작 과정, 한계점을 차례로 제시합니다. 📌 결론 압축 요약: 본 논문은…
논문의 핵심 요약 이 논문은 Dynamic Diffusion Transformer (DyDiT)라는 새로운 모델을 제안하며, 기존 Diffusion Transformer (DiT)의 과도한 연산량 문제를 해결하는 것을 목표로 한다. DyDiT는 시간축(Timestep)과 공간축(Spatial)에서 동적으…
논문 개요 및 강점 논문 제목: DeepSeek-VL2: Mixture-of-Experts Vision-Language Models for Advanced Multimodal Understanding 강점 및 독창성: 동적 타일링 전략 (Dynamic Tiling Strategy): 기존…
논문의 강점과 독창적인 지점 동적 해상도 처리 (Naive Dynamic Resolution): Qwen2-VL은 고정된 해상도에서 이미지를 처리하는 기존 LVLM과 달리, 다양한 해상도의 이미지를 동적으로 처리할 수 있는 메커니즘을 도입했습니다. 이를 통해 고해상도 이미지의 세부 정보를 보존하며,…
논문의 핵심 요약 및 평가 1. 논문의 강점과 독창적인 지점 이 논문은 Qwen-VL 시리즈라는 대규모 Vision-Language Model (LVLM) 을 소개하며, 기존 모델 대비 다양한 시각적 이해 및 언어적 응용 능력을 향상시킨 것이 핵심이다. 다음과 같은 주요 강점과 차별점이 있다: 2. 핵심…
논문 요약 및 분석: Janus - Decoupling Visual Encoding for Unified Multimodal Understanding and Generation 1. 연구의 주요 기여 Janus는 멀티모달 이해(Understanding)와 생성(Generation)을 통합한 자율회귀…
논문의 강점, 독창적 지점, 그리고 핵심 내용 강점: 효율성과 고해상도: Sana는 최대 4096x4096 해상도의 이미지를 효율적으로 생성하며, 경쟁 모델 대비 최대 100배 이상의 처리량을 제공합니다. 경량화된 모델: Sana-0.6B는 0.6B 파라미터로 FLUX(12B)와 유사한 성능을 내면서도,…
논문의 강점 및 독창적인 지점 핵심 요약: 이 논문은 Transformer 기반 대형 언어 모델(LLM)의 특정 층에서 랭크 감소(LASER) 기법을 통해 성능을 개선할 수 있음을 발견했습니다. 특히, 훈련이 끝난 모델에 적용 가능한 후처리 방법으로, 특정 층의 고차 요소(작은 특이값에 해당하는 성분)를…
논문의 강점, 독창성, 핵심 알고리즘, 그리고 한계점 요약 결론 요약 이 논문은 Meta의 최신 언어 모델 Llama 3의 개발, 구조, 학습, 성능 평가, 그리고 안전성을 다룹니다. 405B 매개변수를 가지며 128K 토큰의 긴 문맥 처리, 멀티모달 확장, 다국어 지원, 툴 사용을 기본적으로 지원하는…
논문의 강점 및 독창성 효율성 증가: • SageAttention2는 4비트 정밀도(INT4)와 FP8(8비트 부동소수점)을 활용하여 기존 FlashAttention2 대비 약 3.1배 빠른 연산 속도를 제공함. • RTX4090에서 최대 485 TOPS 성능을 달성하며, FlashAttention2와…
논문의 주요 내용과 분석을 다음과 같이 요약하겠습니다: 논문의 강점 및 독창성 독창적 아이디어: 기존 Vision Transformer(ViT) 모델의 토큰 처리 속도를 향상시키기 위해 "토큰 병합(Token Merging, ToMe)" 기법을 제안했습니다. 이는 토큰을 단순히 제거하는 것이 아니라 병합…
논문의 강점과 독창성 강점: 훈련 불필요한 가속화 방법: 기존의 모델 압축이나 속도 향상 방법은 대규모 재학습이 필요한 경우가 많지만, 이 논문에서는 훈련 없이 모델의 속도를 개선할 수 있는 혁신적인 접근법을 제시했습니다. U-Net 구조 활용: U-Net의 구조적 특성을 활용하여 고레벨 특징…
논문의 강점 및 독창성 문제 정의의 명확성: 기존 연구가 다루지 않은 멀티모달 대규모 언어 모델(MLLMs)의 장문 컨텍스트 문제를 타겟으로 하여, 멀티모달 키-값(KV) 캐시 관리의 효율성을 개선하려는 명확한 목표를 설정함. 효율적인 KV 캐시 압축: LOOK-M은 KV 캐시 크기를 최대 80% 줄이면…
강점 및 독창적인 지점 논문의 강점: 효율성 향상: SparseVLM은 추가적인 훈련 없이 비전-언어 모델(VLM)의 효율성을 크게 향상시키는 방식을 제안합니다. 이는 기존의 많은 방법이 추가 데이터와 훈련이 필요했던 점에서 차별화됩니다. FLOPs(연산 복잡도)를 최대 67%까지 줄이면서도 93%의 정…
논문 요약 및 분석 논문 제목: VL-CACHE: Sparsity and Modality-Aware KV Cache Compression for Vision-Language Model Inference Acceleration 논문의 주요 내용 및 기여점 이 논문은 Vision-Language Models…
논문 분석 및 요약: "Deep Compression Autoencoder for Efficient High-Resolution Diffusion Models" 논문의 개요 및 주요 내용 이 논문은 고해상도 이미지 생성을 위한 효율적인 오토인코더인 Deep Compression Autoencoder…
논문의 강점 및 독창적인 지점 이 논문은 Hybrid Autoregressive Transformer (HART)라는 새로운 이미지 생성 모델을 제안하며, 이 모델은 특히 높은 효율성을 자랑합니다. HART는 1024x1024 해상도의 이미지를 직접 생성할 수 있으며, 기존의 확산 모델과 비교하여 다음과…
이 논문은 "Learning Transferable Visual Models From Natural Language Supervision"이라는 제목을 가진 CLIP (Contrastive Language-Image Pre-training) 모델에 대한 연구입니다. 논문의 핵심 내용 및 강점 기존 접근…
논문의 요약 및 분석 논문의 개요 논문 "Condition-Aware Neural Network (CAN)"은 이미지 생성 모델에 제어 기능을 추가하기 위해 새로운 접근 방식을 제안합니다. 이 모델은 기존의 조건 제어 방법과는 달리, 조건에 따라 동적으로 네트워크의 가중치를 조정하여 이미지 생성 과정을…
논문의 개요 및 독창성 논문 "DistriFusion: Distributed Parallel Inference for High-Resolution Diffusion Models"은 고해상도 이미지 생성에서 발생하는 연산 병목을 해결하기 위해 다중 GPU를 활용하여 Diffusion 모델의 추론 속도를 대…
논문 요약 및 주요 내용 분석 논문 제목: "FastComposer: Tuning-Free Multi-Subject Image Generation with Localized Attention" 저자: Guangxuan Xiao, Tianwei Yin, William T. Freeman, Frédo…
논문 분석: VILA: On Pre-training for Visual Language Models 1. 논문의 배경 및 목표 이 논문은 Visual Language Model (VLM)을 개선하기 위한 사전 학습(pre-training) 기법을 연구합니다. 최근 대규모 언어 모델(LLM)의 성공을 기반…
논문 요약 및 강점 분석 논문 제목: VILA-U: A Unified Foundation Model Integrating Visual Understanding and Generation 논문의 주요 목표 및 독창적인 접근 방식 VILA-U는 텍스트와 비주얼(이미지/비디오)의 이해 및 생성 작업을 단일 모…