Programmable World Model — 생성형 월드에 “실행 가능한 상태"를 심다
한 줄 요약 (TL;DR)
비디오 월드 모델은 점점 더 사실적인 인터랙티브 환경을 만들어내지만, 화면에 잠깐 스친 픽셀만 기억할 뿐 “세상이 지금 실제로 어떤 상태인지"는 알지 못한다. Alaya Lab의 Programmable World Model (PWM) 은 세계의 상태를 관리하는 경량 엔진 과 그 상태를 영상으로 그려주는 생성형 렌더러 를 분리한다. 상태는 프로그래밍 가능하고 검증 가능하게 유지하면서, 외형과 동작의 섬세한 디테일은 사전학습된 비디오 생성 모델에 맡긴다. 자체 벤치마크 CombatStateBench 에서 카운트 정확도 94% , 상태 정확도 98% 를 달성해 기존 인터랙티브 비디오 월드 모델을 큰 폭으로 앞선다.
핵심 아이디어
논문의 중심 가설은 한 문장으로 요약할 수 있다.
저자들은 세계 상태의 유지·진화를 시각 관측 생성으로부터 분리함으로써, 생성형 월드가 장기 상호작용 동안 상태 일관성을 잃는 기존의 한계를 극복하고, 여전히 개방형(open-domain) 영상 생성의 유연성을 유지할 수 있다고 가정한다.
이 한 문장 뒤에는 아주 단순하지만 무거운 질문이 놓여 있다. 생성 모델은 “그럴듯한 다음 프레임"을 만드는 데 탁월하지만, “참인 사실"을 기억하는 데는 취약하다. 가령 전투 장면에서 NPC 하나가 쓰러지면, 모델은 그 프레임을 그럴듯하게 그릴 수는 있어도 다음 10초 동안 그 NPC가 죽은 상태로 남아 있어야 한다는 사실을 보장하지 못한다. 화면 밖으로 나간 적, 보이지 않는 체력 수치, 인벤토리, 세력 관계 같은 “보이지 않는 사실"은 픽셀 예측만으로는 유지되지 않는다.
PWM의 답은 명확하다. 사실을 유지하는 책임을 생성 모델에게서 빼앗아, 명시적이고 실행 가능한 상태를 관리하는 별도의 엔진에게 넘기자 는 것이다. 생성 모델은 그 상태를 “렌더링"하는 역할만 담당한다. 마치 게임 엔진이 게임 로직과 상태를 관리하고, 그래픽스 파이프라인이 그것을 화면에 그리는 것과 같은 분업이다.
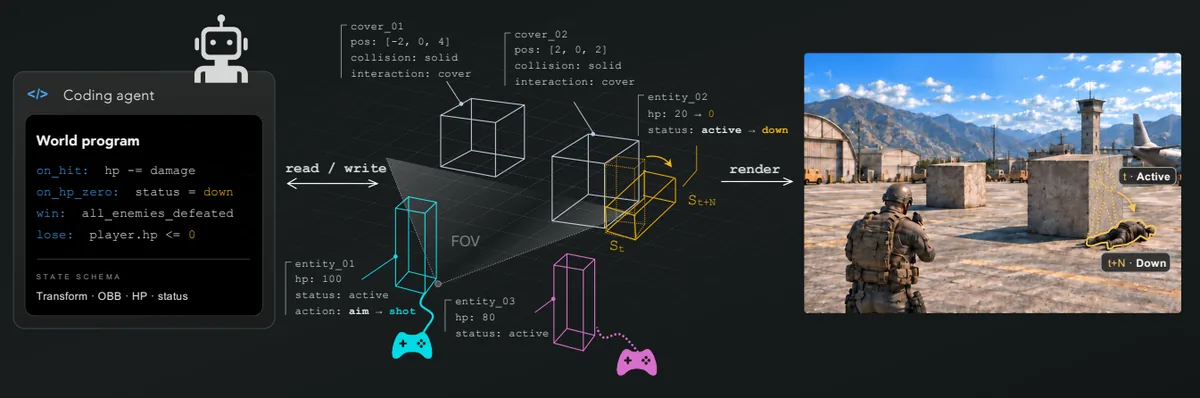
이 분업의 핵심 연결 고리는 상태 표현(representation) 이다. 엔진이 관리하는 구조화된 상태를, 생성 모델이 이해할 수 있는 조건 신호로 어떻게 옮길 것인가? 저자들은 여기서 “상태 증강 3D 방향 경계 상자(State-augmented 3D Oriented Bounding Box, OBB)“라는 중간 표현을 도입한다. 그리고 이 표현을 결정적(deterministic) 상태 컴파일러 가 카메라 궤적에 맞춰 픽셀 정렬된 제어 맵으로 투영한다. 이 컴파일러가 학습되지 않은 결정적 함수라는 점이 이 논문의 가장 중요한 설계 선택이다.
배경: 그들이 해결한 문제
최근의 비디오 월드 모델(Genie 3, WorldPlay, AlayaWorld, Matrix-Game 3.0 등)은 생성형 비디오 모델 위에 인터랙티브 월드 엔진을 세우려는 시도다. 비주얼 히스토리와 사용자 행동으로부터 다음 관측을 예측함으로써, 점점 더 현실적이고 반응적인 환경을 합성해낸다.
하지만 저자들은 “그럴듯한 관측 생성"이 곧 “인터랙티브 월드 엔진"이 되기에는 부족하다고 지적하며, 세 가지 구조적 한계를 짚는다.
- 엔티티 단위 제어의 부재. 기존 제어 인터페이스는 주로 카메라, 행동, 또는 상위 수준 프롬프트를 지정한다. 특정 개별 엔티티를 직접 지목하고 조작하는 수단이 없다.
- 영속적 전역 상태의 부재. 현재 시점(view)과 무관하게 접근·갱신할 수 있는 명시적 전역 상태가 없다. 화면 밖의 엔티티, 인벤토리, 작업 진행도, 상호작용 이력 같은 비시각적 정보는 멀티플레이어 월드 엔진에 필수적인데도 유지되지 않는다.
- 세계 규칙의 프로그래밍 불가. “문이 언제 열리는가”, “상호작용이 다른 엔티티에 어떤 영향을 주는가” 같은 진화 규칙을 사용자가 정의할 수 없다. 프롬프트로 원하는 결과를 유도하는 것은, 이후 상호작용을 일관되게 지배하는 실행 가능한 규칙을 확립하는 것과는 다르다.
관련 연구를 보면 이 문제에 대한 두 갈래의 접근이 있었다. StatePlay나 MASS 같은 “명시적 상태 월드 모델” 계열은 상태를 명시적으로 예측하지만, 상태 전이 자체를 학습된 모델이 예측 한다. 그 결과 상태 예측 오류가 곧바로 잘못된 세계 갱신으로 이어지고, 장기 롤아웃에서 오류가 누적된다. PWM의 차별점은 상태 전이를 학습된 전이 모델이 아니라 명시적 규칙을 실행하는 결정적 엔진 이 수행한다는 데 있다.
한편 생성형 렌더링 계열(DiffusionRenderer, AlayaRenderer, Coarse-to-Real 등)은 구조화된 조건으로부터 사실적인 영상을 합성할 수 있음을 보여주었다. 이들은 “더 풍부한 구조 표현을 주면 더 정밀한 제어가 가능하다"는 스펙트럼을 열었다. PWM은 이 스펙트럼의 중간 지점을 골라, 표현이 너무 가볍지도 무겁지도 않은 지점을 찾는다.
새로운 접근법: Programmable World Model
PWM의 기술적 핵심은 표현의 선택 이다. 저자들은 표현 선택이 다음 세 가지를 결정한다고 본다. (1) 명시적으로 제어할 수 있는 범위, (2) 상태를 만들고 진화시키는 비용, (3) 학습 시 표현과 추론 시 표현 간의 불일치 가능성.
여기서 논문이 제기하는 가장 흥미로운 통찰은 학습-추론 비대칭성(training–inference asymmetry) 이다. 학습 데이터에서는 역학(dynamics)이 이미 실현된 뒤에 구조 표현이 추출된다.
$$ \text{Training: 실현된 역학} \longrightarrow \text{구조 표현} $$반면 추론에서는 방향이 정반대다. 시스템은 먼저 상위 수준 상태 전이를 받고, 그에 맞는 시변 구조 표현을 능동적으로 생성해야 한다.
$$ \text{Inference: 상태 전이} \longrightarrow \text{구조 표현} \longrightarrow \text{생성된 역학} $$이 비대칭성의 의미는 크다. 학습 때는 얻을 수 있었던 표현이라도, 추론 때 똑같이 쉽게 만들고 진화시킬 수 있는 것은 아니다. “캐릭터가 쓰러진다"라고 지정하는 것은 쉽지만, 그 캐릭터의 상세한 신체 포즈와 팔다리 궤적을 일일이 생성하는 것은 고차원의 역학 실현 문제가 된다. 표현이 정밀할수록 시스템은 저수준 기하·동역학 디테일을 더 많이 스스로 결정해야 한다.
이 관점에서 표현 선택은 곧 “명시적 구조 제어"와 “생성적 동작 완성” 사이의 경계선 을 긋는 일이다.
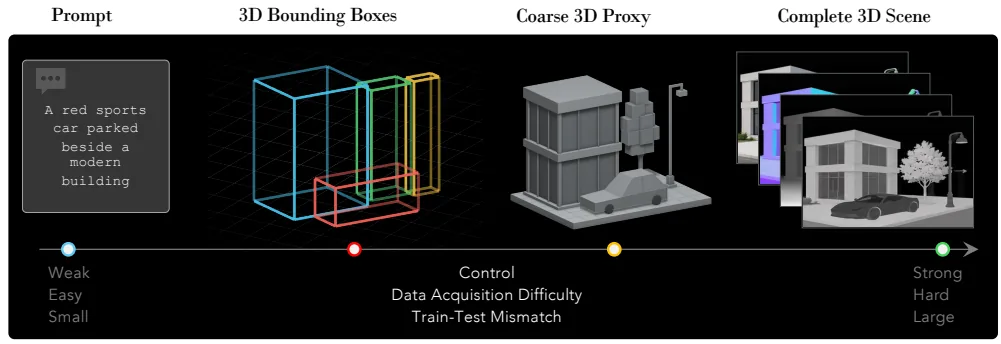
저자들이 택한 중간 지점이 상태 증강 3D OBB 다. 각 OBB는 공유 세계 좌표계에서 엔티티의 위치·크기·방향을 소수의 고정 파라미터로 표현하며, 여기에 영속적 정체성(identity), 의미 범주(semantic category), 동적 상태, 외형 정보를 부착한다. 텍스트나 2D 박스·마스크보다는 세계 공간에서 뷰(view)와 무관하게 재투영 가능한 골격을 제공하고, G-buffer나 완전한 3D 장면보다는 명시적으로 진화시켜야 할 구조를 엔티티 수준의 컴팩트한 공간으로 제한한다. 팔다리 관절, 국소 변형, 옷감 같은 미세한 디테일은 생성형 렌더러가 이 제약 아래에서 완성한다.
이 원리 위에 세워진 전체 프레임워크는 크게 네 구성요소로 나뉜다.
- 코딩 에이전트(VLM 기반). 참조 이미지와 자연어 설명을 받아 실행 가능한 세계 프로그램을 작성한다. 감지된 엔티티의 초기 상태와 속성, 관계, 지원하는 행동, 행동·이벤트가 세계를 갱신하는 규칙, 전역 제약, 이벤트 트리거, 목표를 정의한다.
- 경량 엔진. 이 프로그램을 실행해 정규(canonical) 세계 상태를 유지하고, 플레이어 행동에 따라 상태 전이를 수행한다. 엔진이 진리의 원천(single source of truth)이다.
- 결정적 상태 컴파일러. 갱신된 상태를 목표 카메라 아래 투영해 픽셀 정렬된 시공간 제어 신호로 변환한다.
- 생성형 렌더러. 이 제어 신호와 비주얼 히스토리를 조건으로 다음 비디오 청크를 합성한다.
작동 원리: 구체적인 예시로 살펴보기
전체 파이프라인을 먼저 한눈에 보자.
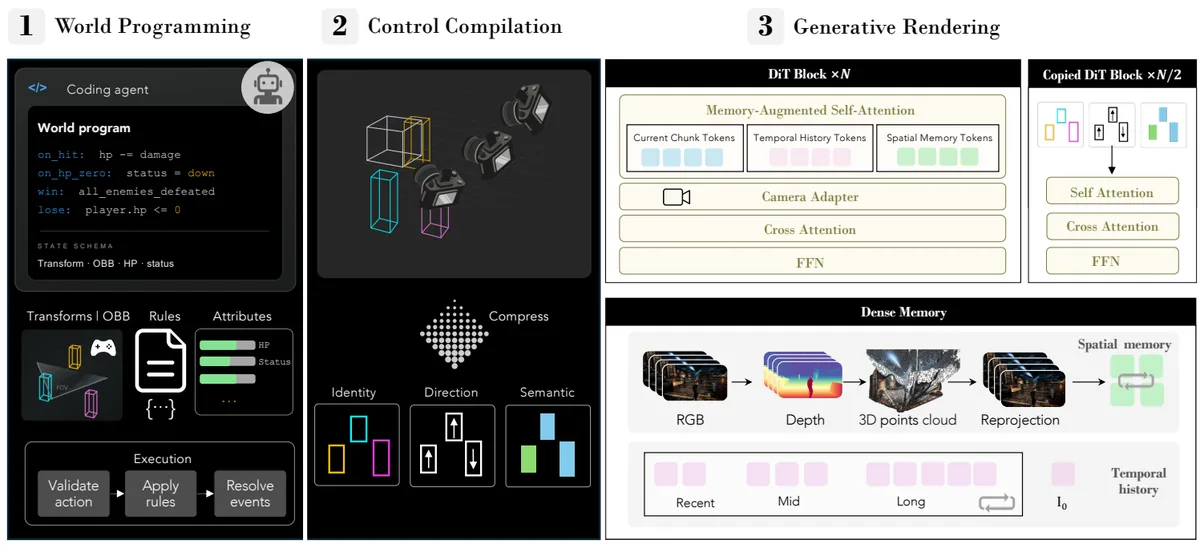
이제 아주 단순한 예시로 각 단계를 따라가 보자. 두 명의 캐릭터 A(플레이어) 와 B(적) 가 있는 전투 장면을 상상하자.
상태 표현: 정규 세계 상태
엔진이 유지하는 정규 세계 상태는 다음과 같은 구조다.
$$ s_t = (\mathcal{E}_t,\ \mathcal{A}_t,\ \mathcal{Q}_t;\ \mathcal{R}_t) $$- $\mathcal{E}_t$: 영속적 엔티티들과 그 3D 포즈 (A, B 각각의 OBB 위치·크기·방향)
- $\mathcal{A}_t$: 의미·기능 속성 (A의 체력 100, B의 체력 20, 세력 라벨 등)
- $\mathcal{Q}_t$: 엔티티 간 관계 (A와 B는 서로 적대)
- $\mathcal{R}_t$: 실행 가능한 세계 규칙 (“공격은 대상이 적대이고 생존해 있으며 사거리 내일 때만 유효”, “체력이 0 이하가 되면 death 이벤트 발생”)
여기서 체력, 세력 소속 같은 값은 화면에 직접 보이지 않지만, 이후 상태 전이를 결정짓는 잠재 세계 사실 이다. 엔진이 이를 명시적으로 보관한다.
상태 전이: 엔진 실행
플레이어가 “A가 B를 공격"이라는 행동 $a_t$를 선택하면, 엔진은 규칙 $\mathcal{R}_t$에 따라 상태를 갱신한다.
$$ s_{t+1} = F(s_t, a_t) $$이 행동이 유효한지(적대? 생존? 사거리 내?)를 검증하고, 유효하면 B의 체력을 20에서 −10으로 낮춘다. 체력이 0 이하가 되었으므로 death 이벤트가 트리거되고, B는 dead 상태로 전이한다. 이 상태는 이후 모든 프레임에서 엔진이 보장하는 사실 이 된다. 이 지점이 바로 프롬프트 기반 방식과의 결정적 차이다. 프롬프트 방식은 “B가 쓰러졌다"고 텍스트로 알려줄 뿐, 모델이 이를 계속 기억할 책임을 지지 않는다.
제어 컴파일: 상태를 픽셀 정렬 제어로
갱신된 상태 $s_{t+1}$은 여전히 세계 좌표계의 구조화된 데이터일 뿐, 렌더러가 쓸 수 있는 형태가 아니다. 결정적 컴파일러 $P$가 이를 목표 카메라 $C_{t+1}$ 아래 투영한다.
$$ M_{t+1}^{\text{ctrl}} = P(s_{t+1}, C_{t+1}) $$컴파일러는 각 엔티티의 OBB를 카메라 아래 투영하고, 그 투영 영역에 세 종류의 정렬된 제어 맵을 채워 넣는다.
$$ M_t^{\text{ctrl}} = \operatorname{Concat}\left(M_t^{\text{id}},\ M_t^{\text{sem}},\ M_t^{\text{dir}}\right) $$- 정체성 맵 $M_t^{\text{id}}$: 각 영속 엔티티를 $K$ 개의 학습 가능한 정체성 슬롯 중 하나에 고정 배정한다. 엔티티가 가려졌다가 다시 등장하거나 화면 밖으로 나갔다 돌아와도, 동일한 슬롯이 외형 참조와 연결되어 정체성이 유지된다. 학습 때는 샘플마다 슬롯 배정을 무작위화해 특정 슬롯이 특정 카테고리나 시점에 편향되는 것을 막는다.
- 의미 맵 $M_t^{\text{sem}}$: 범주 수준 정보를 담는다. 의미 라벨 $y_i$를 사전학습된 텍스트 인코더로 임베딩해 $q_i^{\text{sem}} = E_{\text{text}}(y_i)$ 를 만들고, 해당 OBB의 가시 투영 영역에 브로드캐스트한다. 같은 범주의 엔티티는 같은 의미 표현을 공유하되 정체성 슬롯으로 구분된다. 초기 관측에 없는 엔티티나 외형 참조가 부족한 엔티티에 특히 유용하다.
- 방향 맵 $M_t^{\text{dir}}$: 객체 자신의 이동을 카메라 상대적으로 표현한다. 엔진이 유지하는 세계 좌표 속도를 목표 카메라 좌표계로 회전시킨 뒤, 7가지 상태(전진·후진·좌·우·정지·상·하) 중 하나로 양자화한다. 핵심은 이 방향이 이미지 공간 변위가 아니라 세계 좌표 속도 로부터 계산된다는 점이다. 카메라가 움직여 투영 위치가 바뀌어도 정지한 객체는 여전히
정지로 표기된다.
이 마지막 방향 맵이 PWM의 조용한 “비밀 병기"다. 카메라 움직임과 객체 움직임이 화면에서는 구분 불가능하게 섞이는데, 이를 분리해 줌으로써 렌더러가 “카메라가 돈 건지, 객체가 움직인 건지"라는 모호성을 해소하게 된다. 저자들은 LooseControlVideo 같은 지시형 비디오 제어에서도 정체성 교환이나 배치 오류가 관찰된다고 언급하며, 이 모호성 제거가 배치 정확도의 핵심이라고 본다.
생성형 렌더링
렌더러는 LingBot-World-v1의 사전학습된 카메라 제어 비디오 생성 백본 위에, 학습 가능한 Structured Spatial ControlNet 을 부착한다. 제어 맵 시퀀스 $M_{1:T}^{\text{ctrl}}$ 은 비디오 잠재 공간 해상도에서 인코딩되어, 레이어별 제어 피처 $r^{(\ell)}$ 를 백본의 해당 블록 은닉 상태에 더한다.
$$ h_{\text{main}}^{(\ell)} \leftarrow h_{\text{main}}^{(\ell)} + r^{(\ell)} $$학습 때는 사전학습된 메인 브랜치(카메라 조건 경로 포함)를 동결 하고 새로 도입된 ControlNet만 최적화한다. 즉 카메라 모듈은 전역 시점 궤적을, ControlNet은 그 시점 아래에서 각 엔티티가 어디에 나타나고 어떤 정체성·의미를 가지며 어떻게 움직이는지를 제약한다.
고정 윈도우 렌더링은 다음과 같이 쓸 수 있다.
$$ I_{1:T} = G_{\theta,\phi}\left(I_0,\ \mathcal{C},\ M_{1:T}^{\text{ctrl}}\right) $$장기 생성을 위해 이 렌더러는 청크 자기회귀(chunk-autoregressive) 방식으로 확장된다. 청크 내부에서는 양방향 디노이징을, 청크 경계에서는 인과성을 유지한다. 이전 청크의 완성된 프레임은 두 갈래의 메모리로 전달된다. 시간적 히스토리 는 최근·중간·장거리 잠재를 다중 스케일로 압축해 전달하고(초기 프레임 $I_0$ 의 잠재는 영속적 앵커로 유지), 기하 정렬 공간 메모리 는 AlayaWorld에서 가져온 것으로, 완성된 RGB 프레임을 추정 깊이와 카메라 파라미터로 세계 공간에 들어 올려 큰 카메라 회전이나 재방문 시 이전 시각 콘텐츠를 복원한다.
여기서 중요한 원칙 하나. 이 메모리들은 렌더러 측의 비주얼 컨텍스트일 뿐, 상태 전이를 결정하지 않는다. 엔진이 여전히 유일한 진리의 원천 이며, 컴파일된 제어 $M_{t+1}^{\text{ctrl}}$ 이 매 청크에서 무엇을 렌더링할지 결정한다.
학습 데이터: 자동 데이터 파이프라인
이 구조화된 제어를 학습하려면 카메라 기하, 영속 정체성, 의미, 객체 이동이라는 어노테이션이 필요한데, 실세계 비디오에는 이런 것이 없다. 저자들은 비라벨 게임플레이 비디오(Cyberpunk 2077, Forza Horizon 6, GTA V)에서 이를 자동 복원하는 데이터 엔진을 만든다.
- ViPE 로 카메라 내부 파라미터·포즈·메트릭 깊이를 추정해 공유 세계 좌표계를 확립한다.
- Qwen3-VL 에이전트가 장면의 이산적·가산적 객체 범주를 발견한다.
- SAM3 가 비디오 인스턴스 분할·추적으로 시간적으로 일관된 마스크와 영속 트랙 ID를 만든다.
- WildDet3D 가 RGB·깊이·내부 파라미터로부터 프레임별 3D OBB를 추정하고, 이를 세계 좌표계로 변환해 트랙 단위 궤적으로 묶는다.
- 객체 이동은 연속 프레임의 세계 좌표 박스 중심 변위로 계산해 카메라 유발 변위를 제거하고, 카메라 좌표계로 회전해 7방향으로 양자화한다.
- 마지막으로 3D OBB를 투영·래스터화해 정체성·의미·방향 제어 맵을 생성한다(z-buffer로 가림 해결).
이 파이프라인이 중요한 이유는, 논문이 주장하는 “학습 데이터 확장 경로"를 제공한다는 점이다. 구조화된 월드 모델 학습의 병목은 항상 어노테이션 비용인데, 이를 자동화함으로써 지원 가능한 월드의 범위를 늘릴 수 있다는 논리다.
성능 검증: 주요 결과
저자들은 CombatStateBench 라는 통제된 벤치마크를 만든다. 50개 클립으로 구성되며, 다양한 카메라·엔티티 이동이 섞인 전투 시나리오에서 생성된 비디오가 엔진이 유지하는 세계 상태와 얼마나 일치하는지 측정한다. 첫 프레임에는 없었다가 나중에 등장하는 화면 밖 엔티티와의 상호작용도 포함한다. 각 시퀀스는 동기화된 3D 박스, 엔티티 상태, 카메라 파라미터, 투영 제어, 인스턴스 마스크를 가지며, 자동 검증기가 재투영·깊이·기하·시간 연속성·상태 전이 영속성 등을 검사해 통과한 시퀀스만 평가에 쓴다.
평가에는 두 개의 관대한(permissive) 전역 지표를 쓴다. 기존 월드 모델은 인스턴스 수준 제어를 노출하지 않으므로, 객체 단위 대응이나 박스 정렬로는 공정 비교가 불가능하기 때문이다.
- Count Accuracy: 각 비디오에서 8개 프레임을 무작위 샘플링하고, VLM이 보이는 생존 캐릭터 수를 세어 엔진 기록과 비교한다. $\text{CountAcc} = \frac{1}{N}\sum_{i=1}^{N}\mathbf{1}[\hat{n}_i = n_i^{\text{eng}}]$
- State Accuracy: 엔진이 기록한 각 death 이벤트 이후 3개 프레임을 샘플링해, VLM이 죽은 캐릭터가 시각적으로 표현되었는지 판별한다.
판정에는 Qwen3.6-27B VLM을 쓰며, GT 박스나 정체성 같은 특권 정보는 주지 않고 RGB 프레임만 보여준다. 베이스라인은 LingBot-World-V2와 YUME 두 대표 인터랙티브 비디오 월드 모델로, 상태 전이를 프롬프트 전환({환경 설명}. {행동 설명})으로 전달한다.
결과는 표 1과 같다.
| Method | Imaging | Subject Cons. | Background Cons. | Temporal Stability | Count Acc. | State Acc. |
|---|---|---|---|---|---|---|
| LingBot-World-V2 | 67.46 | 81.87 | 91.89 | 96.85 | 40.75 | 8.00 |
| YUME | 64.10 | 92.35 | 93.63 | 98.76 | 32.00 | 58.00 |
| Ours | 67.62 | 94.74 | 96.98 | 99.00 | 94.00 | 98.00 |
세 가지 관찰이 두드러진다.
첫째, 상태 일관성에서 압도적 격차 가 난다. Count Accuracy는 94.00 으로 LingBot-World-V2(+53.25pp)와 YUME(+62.00pp)를 크게 앞서고, State Accuracy는 98.00 으로 LingBot-World-V2(+90.00pp), YUME(+40.00pp)를 앞선다. 특히 LingBot-World-V2의 State Accuracy가 8.00이라는 점은, 프롬프트 기반 방식이 death 이벤트의 시각적 실현을 사실상 보장하지 못함을 보여준다.
둘째, 이 지표들이 “인스턴스 수준 대응"을 직접 보상하지 않는 관대한 지표임에도 개선이 크다는 점이다. 저자들이 강조하듯, 이는 명시적 엔진 상태가 프롬프트 전환보다 훨씬 신뢰할 수 있는 제어라는 뜻이다.
셋째, 화질을 희생하지 않았다 는 점. VBench 네 지표 모두에서 Ours가 최고를 기록한다. Subject Consistency는 94.74로 YUME보다 2.39pp 높아 엔티티 외형·구조 보존이 강화됐고, Background Consistency 96.98, Temporal Stability 99.00, Imaging Quality 67.62 역시 최고다. 구조화된 제어가 엔티티·배경 일관성을 끌어올리면서도 프레임 품질과 시간 안정성은 유지했다는 해석이다.
정성 결과도 같은 이야기를 한다. 아래 그림은 정적 카메라(a)와 동적 카메라·이동 엔티티(b) 두 조건에서의 death 이벤트를 비교한다.
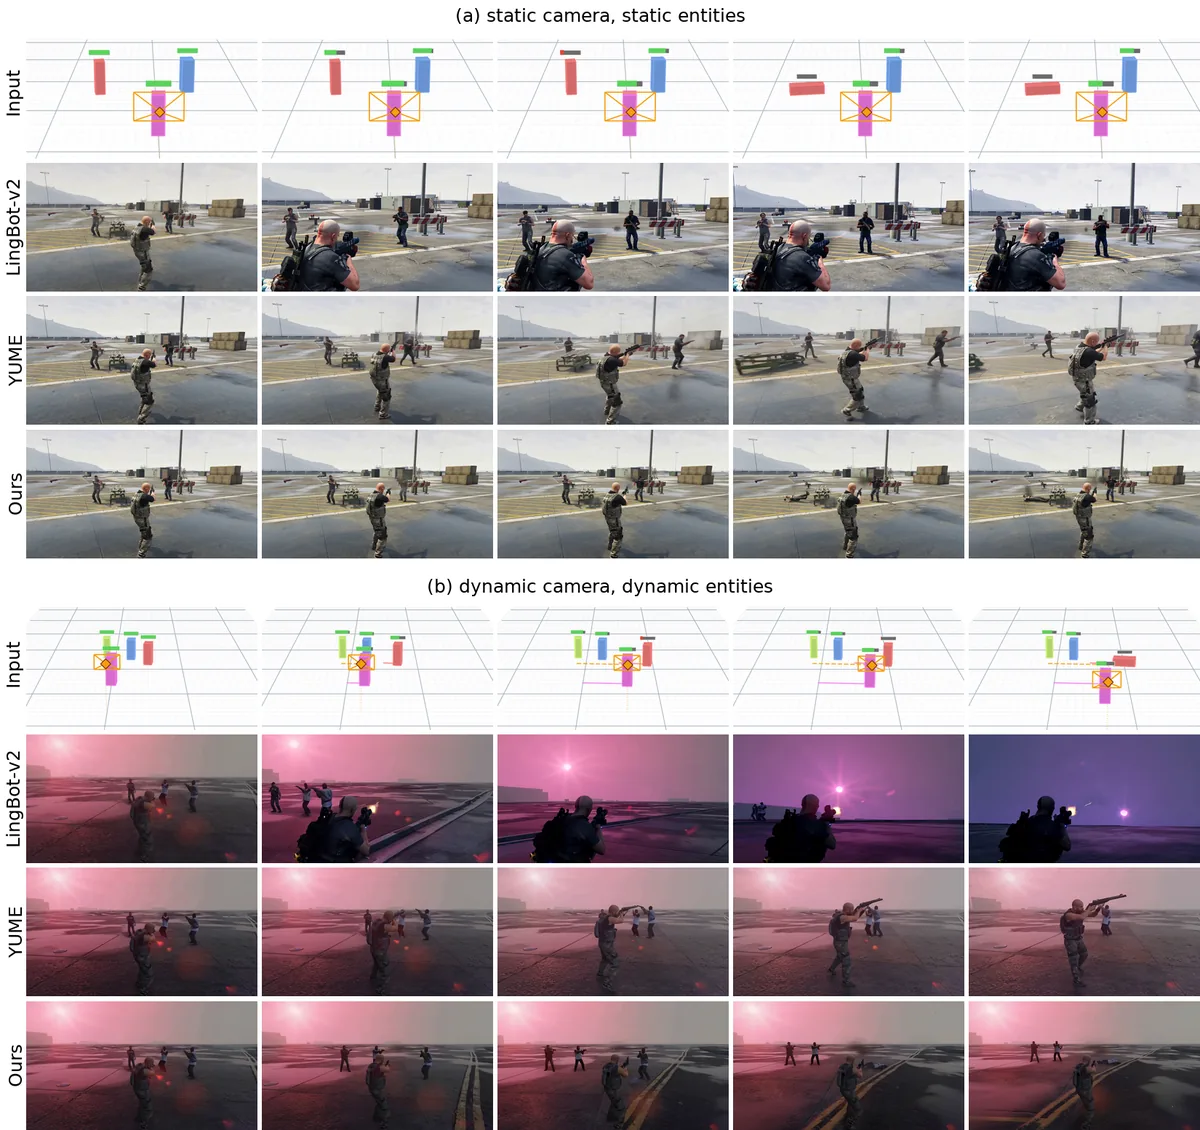
베이스라인은 행동 프롬프트에 그럴듯하게 반응하는 영상은 만들지만 결과 상태를 신뢰성 있게 유지하지 못한다. 살아남아야 할 캐릭터가 사라지고, 죽은 캐릭터가 계속 움직이고, 엔진 이벤트 없이 보이는 캐릭터 수가 변한다. PWM은 엔진이 유지하는 상태를 더 충실히 반영하면서 기반 비디오 생성기의 시각적 현실감을 유지한다.
그 외에도 저자들은 (a) GPT Image 2로 생성한 새로운 미노타우로스 장면으로의 일반화, (b) 큰 각도 카메라 회전 시 첫 프레임 뒤에 있던 캐릭터 3명을 올바르게 등장시키는 것, (c) 레이싱 게임이라는 다른 장르로의 확장, (d) 인간과 차량 같은 이종 범주 동시 렌더링, (e) 897프레임 자기회귀 시퀀스에서 NPC가 점진적으로 등장하는 장면 등을 보여준다.
우리의 관점: 강점, 한계, 그리고 이 연구가 중요한 이유
강점
가장 큰 강점은 설계의 명확성과 책임의 분리 다. “상태는 엔진이, 외형은 생성 모델이"라는 분업은 개념적으로 단순하지만, 지금까지의 월드 모델이 픽셀 예측 목적 함수에 상태 유지 책임을 암묵적으로 끼워 넣으려다 겪은 문제를 정면으로 돌파한다. 생성 모델에게 “참인 사실을 기억하라"고 요구하지 않음으로써, 상태 일관성을 확률적 보장이 아니라 결정적 보장으로 격상시킨다.
결정적 상태 컴파일러 는 특히 주목할 만하다. 학습된 매핑이 아니라 결정적 함수이므로, 상태→제어 변환에 환각(hallucination)이 개입할 여지가 없다. 엔진이 “B는 죽었다"고 말하면, 컴파일러는 항상 그에 대응하는 제어를 산출한다. 이는 상태의 검증 가능성(verifiability)으로 이어진다. 학습된 전이 모델을 쓰는 StatePlay·MASS가 상태 예측 오류의 누적에 노출된 것과 대비된다.
세 번째 강점은 표현 선택을 이론적으로 정당화했다는 점 이다. “학습은 실현된 역학→구조, 추론은 상태 전이→구조→생성"이라는 방향성 비대칭을 명시함으로써, 왜 더 정밀한 3D 표현이 항상 더 좋은 답이 아닌지를 설득력 있게 설명한다. 이는 단순한 공학적 선택이 아니라, 표현 연구에 재사용 가능한 프레임워크다. 특히 방향 맵이 세계 좌표 속도로부터 계산된다는 설계는, 카메라 운동과 객체 운동의 모호성을 푸는 구체적이고 우아한 해법이다.
마지막으로, 자동 데이터 파이프라인 이 실용적 확장 경로를 제시한다. 구조화된 월드 모델의 진짜 병목은 어노테이션이며, 이를 ViPE+Qwen3-VL+SAM3+WildDet3D로 자동화한 점은 향후 데이터 규모 확장의 토대다.
한계와 비판적 시각
논문이 공개한 근거만으로 보면, 몇 가지 한계가 뚜렷하다.
첫째, 평가 지표가 지나치게 관대하고 거칠다. Count Accuracy와 State Accuracy는 저자들도 인정하듯 “조잡하고 전역적으로 관측 가능한 속성"만 측정하며, 이 연구의 핵심 기여인 인스턴스 수준 대응을 직접 보상하지 않는다. “몇 명이 보이는가”, “죽은 사람이 하나라도 보이는가"는 OBB가 주는 정밀한 정체성·위치 제어의 가치를 제대로 증명하지 못한다. 더구나 VLM 판정(Qwen3.6-27B) 자체가 오차를 가질 수 있어, 지표의 신뢰성에 추가적인 잡음이 끼어든다.
둘째, 어블레이션의 부재가 아쉽다. 논문 본문에는 핵심 구성요소(예: 방향 맵 제거, 결정적 컴파일러 vs 학습 매핑, 정체성 맵 유무)의 기여를 분리하는 어블레이션 표가 보이지 않는다. “비밀 병기"인 방향 맵의 메커니즘 설명은 설득력 있지만, 그것이 실제로 얼마나 성능에 기여하는지는 정량적으로 뒷받침되지 않았다. 독자 입장에서는 “방향 맵을 빼면 Count Acc가 몇 포인트 떨어지는가"를 알고 싶다.
셋째, 벤치마크의 범위가 좁다. 50개 클립, 3개 게임, 전투 중심 시나리오다. “죽음"이라는 극단적이고 이산적인 상태 전이는 이 표현이 잘 맞는 케이스이지만, 손짓·표정·섬세한 신체 접촉 같은 연속적이고 미세한 상호작용은 OBB로 표현하기 어렵다. 표현이 거칠수록 그런 디테일은 전부 생성 모델의 몫이 되고, 그 몫이 커질수록 상태 일관성 보장의 범위는 좁아진다. 논문의 결론이 주장하는 “다양한 도메인으로의 일반화"는 레이싱 장면 하나로 대표되며, 보다 체계적인 도메인 확장 실험은 부족하다.
넷째, 시스템 전체가 오프더쉘프 모델에 의존한다. 초기 3D 레이아웃 복원(ViPE·WildDet3D)과 세계 프로그램 작성(VLM 에이전트)이 잘못되면, 아무리 엔진이 결정적이어도 그릇된 상태를 충실히 유지할 뿐이다. “엔진이 진리의 원천"이라는 주장은 그 진리가 처음에 어떻게 만들어지는가에 대해서는 침묵한다. VLM이 잘못된 규칙을 작성하면, 시스템은 일관되게 잘못된 세계를 렌더링한다.
다섯째, 실시간성·연산 비용이 다뤄지지 않았다. 청크 자기회귀 + 공간 메모리 + 3D 어노테이션 파이프라인을 합치면 실제 인터랙티브 플레이 수준의 지연(latency)을 맞출 수 있을지가 불분명하다. 논문은 정확도에는 집중하지만, 월드 모델의 실용성에서 중요한 처리량·지연 지표는 보고하지 않는다.
이 연구가 중요한 이유
그럼에도 이 논문이 중요한 이유는, 월드 모델의 연구 방향을 “픽셀 예측"에서 “실행 가능한 상태"로 옮기는 선명한 기준점 을 제시하기 때문이다. 결론의 한 문장이 이 방향성을 요약한다. “생성형 월드는 무엇이 참인지 기억하는 일을 시각 생성에만 의존해서는 안 된다.” 상태는 실행 가능하고 검증 가능해야 하며, 외형만 생성적이면 된다.
이는 단순한 프레임워크 제안을 넘어, “표현의 세밀함과 학습-추론 정합성 사이의 트레이드오프"라는 재사용 가능한 문제 설정을 제공한다. 생성형 렌더링과 명시적 상태 모델링이라는 두 흐름이 만나는 지점에서, PWM은 이들이 상호 보완적으로 결합될 수 있음을 보여준다.
다음 단계는?: 앞으로의 길
논문이 명시적으로 제시한 방향과, 위의 한계를 감안한 합리적 후속 단계를 함께 정리하면 다음과 같다.
- 더 엄격한 인스턴스 수준 평가. “몇 명"이 아니라 “누가 어디에 어떤 상태로” 있는지를 측정하는 지표(정체성 보존율, 박스 정렬 정확도, 상태 전이 국소화 등)가 필요하다. 특히 결정적 컴파일러가 주는 인스턴스 대응의 가치를 정량화할 지표가 있어야 이 접근의 우위가 완전히 증명된다.
- 어블레이션과 오류 분석. 방향 맵, 정체성 맵, 의미 맵, 결정적 vs 학습 컴파일러 각각의 기여를 분리하고, 실패 사례(예: 미세 상호작용, 급격한 가림, 초기 3D 복원 오류의 전파)를 체계적으로 분석해야 한다.
- 표현 스펙트럼의 확장. OBB보다 정밀한 계층적 표현(엔티티 내부의 관절 골격, 손·얼굴 수준의 국소 구조)을 상태 전이의 필요에 따라 선택적으로 활성화하는 적응적 표현이 자연스러운 다음 단계다. “넘어짐” 같은 전이에는 OBB로 충분하고, “악수” 같은 전이에는 더 세밀한 표현이 필요하다.
- 초기 상태 구축의 강건화. VLM 에이전트가 작성하는 세계 프로그램의 정확성 검증, 오프더쉘프 3D 복원 오류에 대한 견고성, 그리고 사용자가 실행 중에 규칙을 수정하는 루프의 품질을 높이는 연구가 필요하다.
- 실시간성과 규모. 지연·처리량을 실측하고, 더 많은 게임 장르와 실세계 영상으로 데이터 파이프라인을 확장해 “개방형 프로그래머블 월드"라는 약속이 실제로 어디까지 지켜지는지 보여야 한다.
- 멀티플레이어로의 확장. 논문이 화면 밖 엔티티·비시각 속성·관계가 멀티플레이어 월드 엔진에 필수적이라고 언급한 만큼, 다중 플레이어가 공유 정규 상태를 함께 조작하는 시나리오는 이 프레임워크의 가장 자연스러운 응용처다.
궁극적으로 PWM이 던지는 질문은 단순하다. 생성 모델에게 세상을 그리게 하되, 세상이 무엇인지는 우리가 아는 구조로 유지하자. 이 분업이 어디까지 확장될 수 있을지가, 이 논문이 남긴 가장 흥미로운 미해결 질문이다.
논문 원문의 표
arXiv e-print 의 LaTeX 원본에서 기계적으로 옮긴 표입니다. 숫자는 논문의 값이며 모델을 거치지 않았습니다.
표 1. Video quality and world-state evaluation on 50 CombatStateBench clips. All values are reported as percentages. Count Accuracy is evaluated over 400 sampled frames (eight per clip), and State Accuracy over 50 death events, with three post-transition frames sampled per event.
| Method | Imaging | Subject Cons. | Background Cons. | Temporal Stability | Count Acc. | State Acc. |
|---|---|---|---|---|---|---|
| LingBot-World-V2 | 67.46 | 81.87 | 91.89 | 96.85 | 40.75 | 8.00 |
| YUME | 64.10 | 92.35 | 93.63 | 98.76 | 32.00 | 58.00 |
| Ours | 67.62 | 94.74 | 96.98 | 99.00 | 94.00 | 98.00 |
이 글의 그림은 arXiv:2609.10540 원본에서 가져왔습니다 (CC BY 4.0). 크기와 형식만 바꿨습니다.
댓글