도입
대화형 서비스처럼 배치 크기가 1에 가까운 상황에서, 전문가 혼합 언어 모델의 지연 시간은 대부분 라우팅된 전문가 가중치를 GPU 메모리에서 읽는 데서 생긴다. 전문가 안의 중간 차원 대부분은 한 토큰에 거의 기여하지 않으므로, 어느 채널을 읽을지 먼저 고르면 읽는 양을 크게 줄일 수 있다. 이 논문은 기존 채널 선택기가 보정 데이터로 맞추려던 두 목적이 실제로는 달성되지 않음을 보이고, 보정 없이 모델 가중치만으로 만든 선택기를 제시한다.
배경: 채널과 유지 규칙
MoE 레이어에서 라우터는 토큰을 소수 전문가로 보낸다. 전문가 하나는 gated MLP다. 이 전문가의 중간 차원을 하나하나 채널이라 부른다. 채널 $j$는 gate 행렬 $G_e$와 up 행렬 $V_e$의 $j$번째 행, 그리고 down 행렬 $D_e$의 $j$번째 열을 각각 소유한다.
입력 $x$가 들어오면 채널 $j$는 다음을 계산한다.
- 게이트 활성: $\phi(g_j^\top x)$
- up 출력: $(v_j^\top x)$
- 채널 활성: $a_j = \phi(g_j^\top x)(v_j^\top x)$
전체 라우팅 출력은 각 채널이 만든 $a_j d_j$를 전문가의 라우터 가중치로 스케일해 모두 더한 값이다.
설명용으로 Qwen3-Thinking을 보자(§2의 실제 구조). 토큰 하나는 8개 전문가로 가고, 각 전문가는 768개 채널을 가진다. 그래서 레이어마다 선택기는 $8 \times 768 = 6144$개 후보 채널 가운데 읽을 것을 골라야 한다. 채널 $j$를 계산하기로 정하면, gate/up의 $j$행과 down의 $j$열을 읽어 $a_j d_j$를 정확히 계산한 뒤 출력에 더한다. 버린 채널은 가중치를 아예 읽지 않는다(뒤에서 보듯 reader는 이를 근사로 채운다).
채널 선택기의 핵심 갈림길은 유지 규칙이다. 점수는 같아도, 어떤 채널을 남길지 정하는 방식이 다르면 읽는 양과 정확도가 달라진다.
| 규칙 | 입력 | 상태 | 변경 | 출력 |
|---|---|---|---|---|
| 임계값 $\tau$ | 토큰 A와 B에 같은 점수 | 점수 $\ge \tau$인 채널 통과 | A는 6개 유지, B는 2개 유지 | 토큰마다 읽는 양이 바뀜 |
| top-k ($k=4$) | 같은 점수 | 점수 상위 4개 통과 | A·B 모두 4개 유지 | 토큰마다 읽는 양이 고정됨 |
임계값은 토큰마다 필요한 만큼 주려는 의도를 갖지만, 실제 읽는 양이 입력을 따라 움직인다. top-k는 양을 미리 고정하지만, 토큰의 실제 필요와 무관하게 $k$개를 남긴다.
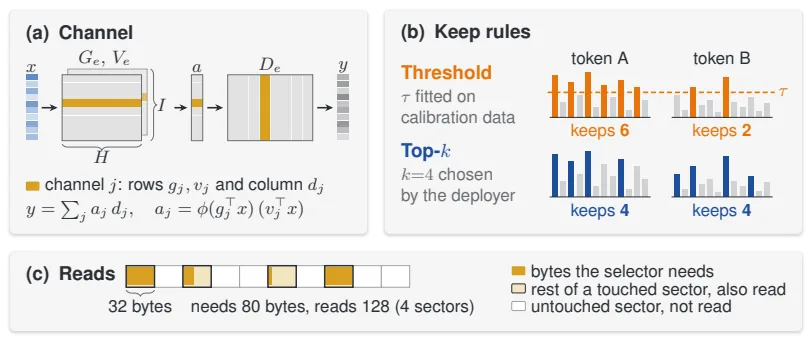
원문 Fig. 2를 보자. (a)는 채널 $j$가 gate/up의 $j$행과 down의 $j$열을 소유한다는 구조를 그린다. (b)는 같은 점수에서 임계값이 유지 수를 토큰마다 바꾸고 top-k가 고정한다는 차이를 보여준다. (c)는 비용을 계산하는 방식을 보여준다. 최신 NVIDIA GPU는 메모리를 32바이트 섹터 단위로 가져오므로, 필요한 바이트가 흩어져 있으면 접촉한 섹터를 통째로 청구한다.
| 작은 예시 (c) | 값 |
|---|---|
| 셀렉터가 실제로 필요한 양 | 80바이트 |
| 그 바이트가 놓인 섹터 | 4개(흩어져 있음) |
| 하드웨어가 접촉한 섹터 | 4개 모두 |
| 청구되는 읽기 | $4 \times 32 = 128$바이트 |
이 비용을 논문은 읽기(reads)라 부른다. 토큰당 읽는 바이트를 전체 모델의 라우팅 전문가 읽기 대비 백분율로 잰 것이다. 집계가 실제 하드웨어 전송과 맞는지도 프로파일러로 확인했다. 배치 1 Qwen3-Thinking에서 냉캐시 DRAM 읽기는 18.3%로, 집계한 17.8%에 가깝다(Appendix C).
읽기 절감은 계산량(FLOPs) 절감이 아니다. 메모리 대역폭이 병목인 상황에서 가중치를 덜 읽어 생기는 이득이다.
보정이 두 가지 약속을 모두 지키지 못한다
채널 선택기가 보정된 임계값을 쓰는 이유는 두 가지다. 읽는 양을 미리 안다는 것, 그리고 그 양에서 토큰이 필요한 채널을 줘 정확도를 올린다는 것. 저자는 이 둘을 하나씩 실험으로 깬다.
임계값은 읽는 양을 고정하지 못한다
임계값 $\tau$는 고정이지만, 그 위를 지나는 채널 수는 입력마다 다르다.
채널 점수를 출력에 대한 실제 기여로 정확히 계산하고, UltraChat에서 약 12%가 되도록 $\tau$를 보정한 실험을 보자. 보정에 쓰지 않은 별도의 대화 데이터에서는 평균 유지 수가 목표에 맞았다. 그런데 같은 대화 데이터에서도 Qwen3-Thinking 토큰의 중간 90%는 9.0~16.2%만 유지해 폭이 크고, 벤치마크 답변(GPQA-Diamond, IFEval, MMLU-Pro)에서는 점수가 더 작아져 중앙값이 10.0%로 떨어진다.
유지 수는 답변이 길어질수록 줄어든다. 답변 6,000토큰쯤에서 Qwen3-Thinking은 보정 수의 71%만 유지하고, Gemma 4는 92%, Qwen3.5는 88%만 유지한다.
실제 배포에서는 더 단순하다. 보정된 임계값을 쓰는 선택기는 우리가 돌린 72개 벤치마크 실행 전부에서 목표보다 적게 읽었다. Prox는 18%로 보정했는데 실제로는 평균 12.9%, 가장 적게는 9.9%만 읽는다. reader의 임계값 버전도 보정 데이터에서는 목표를 맞추지만 벤치마크에서는 0.4~5.8%p 적게 읽는다(§4.1).
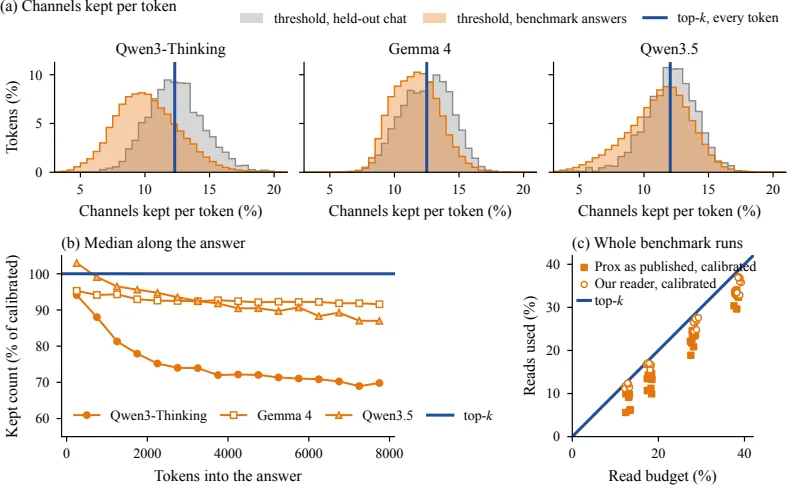
원문 Fig. 4를 읽자. (a)는 토큰당 채널 유지 비율의 분포다. 주황색 임계값 곡선은 보정에 쓴 챗 데이터에서 목표에 맞지만, 벤치마크 답변에서는 중앙값이 10%로 내려간다. 굵은 선은 top-k로, 모든 토큰에서 같은 비율을 유지한다. (b)는 답변 길이별 유지 수가 보정값 대비 몇 %인지를 500토큰 창의 중앙값으로 그린 것이다. (c)는 가로축 예산 대비 실제 읽은 양이다. 점은 전부 대각선 아래, 즉 목표 미달에 놓인다.
왜 줄어드는지도 확인했다. 유지 수는 토큰이 얼마나 필요한지보다 앞서 쓴 답변을 따라간다. Prox가 13%로 보정한 임계값에서, Qwen3-Thinking의 GPQA-Diamond 답변 6,000번째 위치에 놓인 256토큰 창을 앞 문맥과 떼어 질문 바로 뒤에 두면, 같은 토큰이 57% 더 많은 채널을 유지한다. 어려운 토큰이 채널을 더 받지도 않는다. 유지 수와 전체 모델의 다음 토큰 손실의 상관은 −0.29~+0.14에 그친다(§4.1, Appendix E).
보정은 top-k 대비 일관된 정확도 이득을 주지 않는다
두 유지 규칙을 비교하려면 점수를 고정해야 한다. 저자는 같은 채널 점수로 각 선택기를 두 번 돌렸다. 한 번은 보정된 임계값으로, 한 번은 top-k로. 13%와 18% 예산에서 4개 MoE 모델의 생성 과제와 OLMoE의 우도 과제, 그리고 3가지 점수(Prox, TEAL, Prox를 출력 단위로 스케일한 것)로 총 43개 비교를 만들었다.
| 같은 점수, 두 유지 규칙 비교 (§4.2) | 결과 |
|---|---|
| 동률(2 표준오차 이내) | 30개 |
| top-k 우위 | 10개 |
| 임계값 우위 | 3개, 그 폭도 최대 2.8점 |
즉 43개 중 40개에서 top-k가 맞먹거나 이긴다. 여기서 동률은 차이가 탐지되지 않았다는 뜻이지 등가가 아니다. 모델별로 묶어도 보정 예산에서 임계값을 선호하는 모델은 없다(Appendix Table 14).
임계값 버전이 실제로 읽은 양에 맞춰 top-k 버전을 다시 돌리는, 임계값에 유리한 검증에서도 top-k는 41개 중 37개에서 맞먹거나 이긴다(Appendix F, Fig. 8).
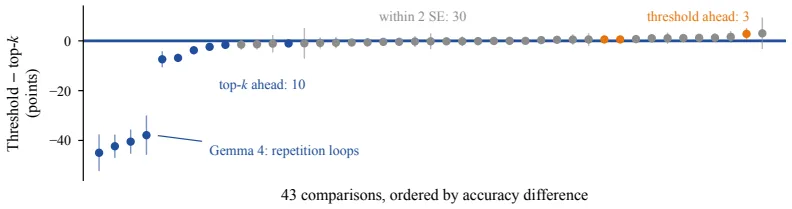
원문 Fig. 5에서 점 하나는 한 비교다. 세로축은 임계값 버전 정확도에서 top-k 버전 정확도를 뺀 값이라, 0 아래(파랑)는 top-k 우위다. 회색은 동률, 파란 점 10개가 top-k 우위(그중 Gemma 4의 네 개가 38~45점), 주황 점 3개만 임계값 우위(최대 2.8점)다. 이 그림은 보정 예산 기준이며, 실제 읽기로 재실행한 버전은 Appendix Fig. 8에 있다.
긴 추론은 보정된 임계값에서 붕괴할 수 있다
Fig. 5의 가장 큰 격차 4개는 모두 Gemma 4에서 나왔다. 13% 예산에서 Prox(및 출력 스케일 변형)의 top-k가 임계값 버전을 38~45점 앞섰다.
보정된 임계값을 쓴 Gemma 4는 문장을 반복하며 32,768토큰 한도까지 도달한다. 읽는 양이 적어서가 아니다.
| 조건 (Gemma 4, GPQA-Diamond) | Prox 임계값(18% 보정) | Prox top-k |
|---|---|---|
| 실제 읽기 | 13.3% | 13.5% |
| 정확도 | 11.7 | 56.3 |
| 792개 답변 중 한도 도달 | 674개 | 145개 |
원인도 좁혔다. Prox의 채널 임계값만 top-k로 바꾸면 붕괴가 사라진다. 입력 임계값만 바꾸면 사라지지 않는다. 채널 최소 유지 수를 4% 깔아도, Gemma 4 자신의 추론으로 재보정해도 붕괴를 막지 못한다(§4.3, Appendix D.1, F.2).
저자들은 이 붕괴가 절벽처럼 작동한다고 추정한다. 희소 모델이 반복을 시작하면 스스로 멈추기 어렵고, 희소화가 토큰마다 더하는 오차가 모델마다 다른 어떤 수준을 넘으면 정확도가 서서히가 아니라 급격히 떨어진다는 것이다. 이 설명은 가설이지 증명이 아니다(§4.3).
가중치만으로 만든 reader
top-k를 유지 규칙으로 쓰면 성능은 두 가지에 달린다. 읽기 전에 채널을 얼마나 잘 순위 매기느냐, 그리고 버린 채널을 어떻게 처리하느냐다. 유지 규칙을 바꾸는 것보다 점수를 바꾸는 것이 KL 발산을 훨씬 크게 움직인다는 관찰이 reader의 설계 방향을 정했다(§5).
reader는 배포 전에 모델 가중치로 한 번만 만든다. 대상 모델에 맞춰 보정하는 값이 없다. 세 가지 설정—128좌표 회전 블록, 80좌표 부분 스캔, rank-32 복구—을 OLMoE 개발 데이터에서 한 번 정해 모든 모델에 재사용한다. 토큰과 레이어마다 reader는 세 단계를 돈다. 모든 후보 채널을 선별하고, 상위 $k$개를 정확히 계산하고, 나머지를 복구한다.
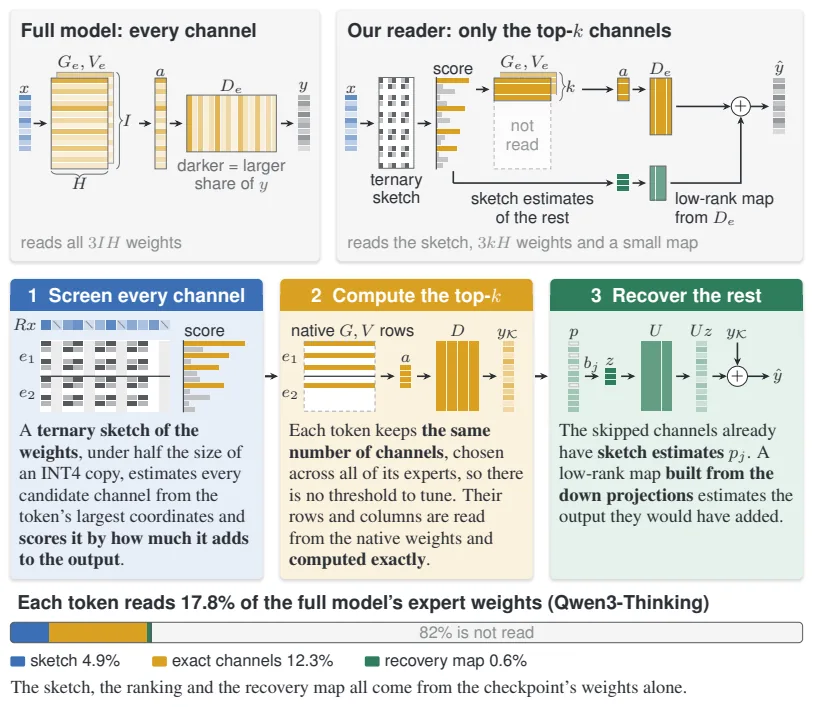
원문 Fig. 6을 보자. 상단은 전체 모델이 라우팅된 전문가의 모든 채널을 읽는 반면, reader는 삼원 스케치를 읽고, 유지한 $k$개 채널의 본 가중치를 읽고, 복구 맵을 읽는다는 대비다. 중단은 세 단계의 동작을 보여준다. 하단은 Qwen3-Thinking에서 17.8% 읽기의 내역이다. 스케치가 4.9%, 정확히 계산한 채널이 12.3%, 복구 맵이 0.6%를 차지하고, 나머지 약 82%는 아예 읽지 않는다.
1단계: 삼원 스케치로 선별한다
가중치와 히든 스테이트에는 이상치가 있어 저비트 코드가 부정확해진다. 그래서 gate 행 $g_j$와 up 행 $v_j$를 무작위 하다마드 변환 $R$로 128좌표 블록 단위로 회전해, 큰 값을 블록 안에 고르게 퍼뜨린다. $R$은 직교라서 회전이 활성을 바꾸지 않는다($g_j^\top x = (Rg_j)^\top(Rx)$).
회전한 블록은 다음처럼 저장한다.
| 저장 항목 | 값 | 역할 |
|---|---|---|
| 삼원 코드 | $\{-1,0,1\}$ | 가중치 대용 |
| FP16 스케일 | 블록 1개당 1개 | 코드를 실제 크기로 복원 |
| $\rho_b$ | 블록의 평균제곱 양자화 오차 | 높은 예산에서 복구 후 남는 오차 기준으로 채널을 순위 매기는 데 사용 |
블록 하나는 BF16 256바이트에서 약 30바이트로 줄어, 스케치가 상주 메모리의 약 7%를 더한다. 디코딩 때는 $x$를 한 번 회전하고 스케치와 곱해 $\hat g_j \approx g_j^\top x$, $\hat v_j \approx v_j^\top x$를 얻는다(§5.1).
12.8%와 17.8% 같은 낮은 예산에서는, 스케치 전체를 읽는 것조차 전체 읽기의 44~61%를 차지한다(OLMoE 기준). 그래서 부분 스캔을 쓴다. 각 블록에서 $|Rx|$가 가장 큰 80개 좌표의 삼원 코드만 읽는다. 이렇게 하면 같은 예산에서 정확히 계산하는 채널을 20~50% 더 늘릴 수 있다(§5.1).
2단계: 출력 단위 점수로 상위 k개를 정확히 계산한다
채널 $j$가 출력에 더하는 크기는 $w_j\,\lVert d_j\rVert\,|a_j|$다. $w_j$는 라우터 가중치, $\lVert d_j\rVert$는 down 열의 노름으로, 로드 시 한 번 계산해 둔다. 활성 $a_j$를 스케치 추정으로 바꾸면 점수는
$$s_j = w_j\,\lVert d_j\rVert\,\bigl|\phi(\hat g_j)\,\hat v_j\bigr|$$가 된다(식 1). 점수가 출력 단위라 서로 다른 전문가의 채널을 직접 비교할 수 있다. 그래서 토큰이 거치는 모든 전문가를 통틀어 상위 $k$개를 고른다. 한 전문가는 채널을 많이 받고, 다른 전문가는 하나도 못 받을 수 있다(§5.2).
선별에서 남은 $k$개 채널은 본 가중치를 읽어 $a_j$를 정확히 계산한다. down 가중치를 연속으로 읽도록, 로드 시 down 투영을 한 번 전치해 두고 prefill과 decode가 같은 레이아웃을 쓴다.
3단계: 버린 채널을 rank-32 맵으로 복구한다
버린 채널 하나의 기여는 작아도, 레이어당 수천 개가 모이면 무시하지 못한다. 선별 단계가 이미 모든 버린 채널의 활성 추정 $p_j = \phi(\hat g_j)\hat v_j$를 계산했으므로, gate/up을 다시 읽지 않고 이를 재사용한다. 남은 문제는 각 버린 채널의 down 열 $d_j$다.
전체 너비의 열을 읽는 대신, 레이어의 모든 down 열을 쌓아 상위 32개 왼쪽 특이벡터 $U \in \mathbb{R}^{H \times 32}$를 구하고, 각 채널의 계수 $b_j = U^\top d_j$를 저장한다. 최종 출력은
$$\hat y = \sum_{j \in K} w_j d_j a_j \;+\; U\sum_{j \in S} w_j b_j p_j.$$첫 항은 유지한 $K$개 채널의 정확한 기여다. 둘째 항은 버린 $S$개 채널의 추정 기여를 rank-32 맵으로 더한 값이다(식 2). 맵은 상주 메모리 약 0.5%, 읽기 0.5~0.8%p를 더한다(§5.3).
정확도와 속도
정확도
정확도는 세 사후학습 모델(Qwen3-Thinking, Gemma 4, Qwen3.5)과 세 벤치마크(GPQA-Diamond, IFEval, MMLU-Pro)의 9개 쌍에서 평가했다. 전체 모델이 프롬프트를 처리하고, 선택기는 이후 디코딩 토큰마다 돈다. 정확도는 전체 모델 정확도의 백분율로 보고한다. 아래 표는 Table 1에서 약 18% 예산에 필요한 행만 재구성한 것이다. 보정된 선택기는 목표와 실제 읽기를 함께 적었다.
| 선택기 (약 18% 예산) | 목표 | 실제 읽기 | 평균 | 최악 |
|---|---|---|---|---|
| Our reader | – | 17.8 | 98.1 | 95.0 |
| Prox 점수, top-k | – | 18.5 | 96.1 | 90.4 |
| Prox 발표, 보정 | 18 | 12.9 | 68.5 | 12.1 |
| WINA 발표, top-k | – | 20 | 28.4 | 1.1 |
| TEAL 발표, 보정 | 20 | 12.6 | 9.9 | 0.0 |
reader는 두 낮은 예산에서 모두 가장 정확하다. 17.8%에서 평균 98.1%, 최악 쌍 95.0%다. 12.8%에서도 평균 94.5%, 최악 쌍 86.9%로, 다른 선택기의 최악 쌍보다 낫다.
눈여겨볼 곳은 Prox다. 18%로 보정했지만 실제로는 12.9%를 읽어 reader의 12.8%와 비슷한데, 평균 정확도는 68.5%에 그친다. 격차의 대부분은 Gemma 4의 반복 루프에서 나왔다. Qwen 두 모델에서는 Prox가 비슷한 읽기에서 reader와 맞먹는다. top-k가 약한 점수를 구원해 주지도 않는다. top-k를 쓰는 WINA는 20% 읽기에서도 28.4%에 그친다(§6.1).
속도
속도는 커널 성능과 전체 시스템 성능을 나눠 봐야 한다. Triton 커널은 17.8% 읽기에서, RTX PRO 6000 Blackwell GPU 한 장으로, 가장 빠른 설정의 unmodified vLLM과 비교했다.
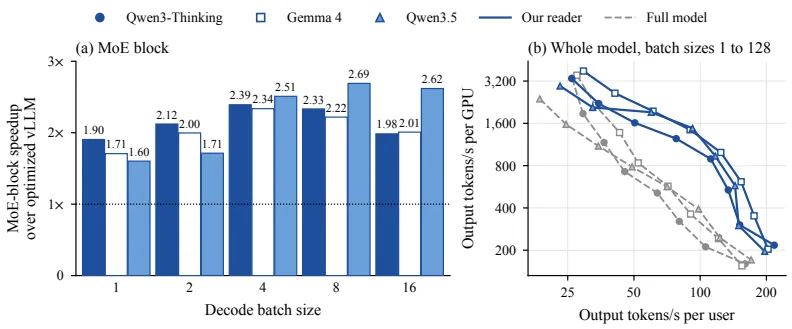
원문 Fig. 7 (a)는 MoE 블록만의 디코드 가속도다. 배치 1에서 Qwen3-Thinking 1.90배, Gemma 4 1.71배, Qwen3.5 1.60배다. 배치 4에서는 2.39/2.34/2.51배, 최대는 Qwen3.5 배치 8의 2.69배다.
(b)는 전체 모델 성능이다. 오른쪽일수록 유저당 빠르고, 위쪽일수록 GPU당 출력량이 많다. 어텐션이 그대로라 이득이 작아, 배치 1에서는 1.15~1.36배, 배치 8~16에서 1.75/1.74/1.88배로 정점을 찍고, 배치 128에서는 1.00~1.24배로 수렴한다(Table 20). 8k~32k 토큰 긴 맥락에서는 1.08~1.54배다.
배치 1에서 이득이 읽기 절감보다 작은 이유는 고정 비용 때문이다. Qwen3-Thinking에서 MoE 블록은 전체 모델 메모리 트래픽의 18.3%만 차지하는데도, 블록은 5배가 아니라 1.90배만 빨라진다. 커널 실행 같은 고정 비용은 읽기 절감으로 줄어들지 않는다. 배치가 커지면 이 고정 비용을 나눠 쓰므로 블록 가속도는 배치 4~8까지 커진다. 다만 배치가 더 커지면, 토큰들이 선택한 채널의 합집합이 다시 늘어 읽어야 할 양이 커지고 이득이 줄어든다(§6.2, Appendix J).
한계와 적용 판단
저자가 인정한 한계는 다섯 가지다(§7).
- 커널은 읽기 절감의 일부만 속도로 바꾼다. 하나의 예산(17.8%)과 하나의 GPU 종류에 맞춰 튜닝됐다.
- 배치 전체의 채널을 한 번에 골라 큰 배치까지 이득을 이어가게 하는 것은 미래 과제다.
- 부분 스캔의 좌표 수(128 중 80)는 OLMoE에서 정했고 Gemma 4에서만 확인했다.
- reader는 디코딩의 라우팅된 전문가만 바꾼다. 스케치와 복구 맵이 BF16 체크포인트의 약 7%와 0.5%를 더하며, 양자화 체크포인트에서는 비중이 더 커진다.
- 테스트한 모델은 최대 35B 파라미터다.
저자가 더 넓게 성립할 것이라 추정한 패턴도 두 가지 있다. 이는 검증된 결과가 아니라 추정이다(§7). 하나는 짧은 우도 평가가 긴 생성의 실패를 가린다는 것, 다른 하나는 KL 발산이 낮다고 정확도가 높은 것은 아니라는 것이다.
리뷰어 관점에서 남는 조건은 이렇다. 결론은 ‘동결된 MoE 전문가의 채널에 보정된 임계값을 쓰는 경우’로 한정된다. 저자 스스로 임계값이 희소 어텐션이나 학습된 라우터 같은 다른 곳에서는 유효할 수 있다고 밝힌다(§3). 절벽 설명도 가설이지 증명이 아니다.
운영에서 쓸 만한 곳은, 작은 배치로 사후학습 MoE 모델을 서빙하면서 프롬프트는 전체 모델로 처리하는 디코드 단계다. 아직 검증되지 않은 조건은 배치 128을 넘는 매우 큰 배치, 다른 GPU 종류, 양자화 체크포인트(OLMoE에서만 확인), 그리고 프리필 단계다.
논문 원문의 표
arXiv e-print 의 LaTeX 원본에서 기계적으로 옮긴 표입니다. 숫자는 논문의 값이며 모델을 거치지 않았습니다.
표 1. Our reader is the most accurate tested selector at the two lowest budgets. Mean and worst accuracy over nine model-benchmark pairs, as a percentage of the full model’s accuracy. Selectors with calibrated thresholds list the budget they were calibrated for (Target) and the reads they used (Realized); WINA as published uses top-$k$ and meets its budget to the precision shown.
| Selector | About 13% of reads Target | About 13% of reads Realized | About 13% of reads Mean | About 13% of reads Worst | About 18% of reads Target | About 18% of reads Realized | About 18% of reads Mean | About 18% of reads Worst |
|---|---|---|---|---|---|---|---|---|
| Our reader | – | 12.8 | 94.5 | 86.9 | – | 17.8 | 98.1 | 95.0 |
| Prox score, top-$k$ | – | 13.5 | 87.0 | 61.1 | – | 18.5 | 96.1 | 90.4 |
| Prox as published, calibrated | 13 | 8.5 | 51.5 | 0.0 | 18 | 12.9 | 68.5 | 12.1 |
| WINA as published, top-$k$ | – | 15 | 2.4 | 0.0 | – | 20 | 28.4 | 1.1 |
| WINA score, calibrated | 15 | 7.8 | 0.2 | 0.0 | 20 | 11.2 | 5.0 | 0.0 |
| TEAL as published, calibrated | 15 | 8.9 | 0.2 | 0.0 | 20 | 12.6 | 9.9 | 0.0 |
표 2. Prior keep-rule comparisons reach opposite conclusions, focus mostly on short tasks on dense models, and none runs top-$k$ at the reads a threshold actually uses. Unlike most prior comparisons, ours holds the channel score fixed (Same score), tests long chain-of-thought reasoning on MoE models (Regime), and runs top-$k$ both at the target budget and at realized reads (Matched).
| Study | Regime | Models | Same score | Matched | Ahead |
|---|---|---|---|---|---|
| La RoSA | dense, PPL | LLaMA2-7B | yes | target | top-$k$ (PPL) |
| Batch-wise pruning | dense, CoT | 2 distilled 7–8B | yes | target | top-$k$ (batch 4) |
| Sparsing Law | dense, short tasks | 0.1B, 0.8B | no | target | threshold |
| Prox | dense, short tasks | Qwen3-8B, 14B | yes | target | threshold (+1.8) |
| TopK-Guided | dense, short tasks | Llama-2/3, 7–8B | no | target | hybrid; top-$k$ vs.\ $\tau$ mixed |
| Sparser-MoE | MoE, short tasks | OLMoE | unclear | target | top-$k$ ($<$1 pt) |
| This paper (\S) | MoE, short + CoT | 4 MoE models | yes | both | tie; top-$k$ on Gemma 4 |
표 3. Evaluated MoE models and the resident memory our reader adds. Each row gives the number of routed experts and how many each token uses, the channels per expert and the hidden width, the number of MoE layers, any module that always runs in full, and the resident memory of our reader’s ternary sketch and recovery map as a percentage of the BF16 checkpoint. OLMoE’s sketch size is computed analytically.
| Model | Routed experts Total | Routed experts Active | Width Expert | Width Hidden | MoE layers | Always full | Added memory (%) Sketch | Added memory (%) Recovery |
|---|---|---|---|---|---|---|---|---|
| Qwen3-Thinking | 128 | 8 | 768 | 2048 | 48 | – | 7.6 | 0.50 |
| Gemma 4 | 128 | 8 | 704 | 2816 | 30 | dense MLP | 7.0 | 0.35 |
| Qwen3.5 | 256 | 8 | 512 | 2048 | 40 | shared expert | 7.0 | 0.47 |
| OLMoE | 64 | 8 | 1024 | 2048 | 16 | – | 7.3 | 0.50 |
표 4. Evaluation protocol on the post-trained models. Each model runs in thinking mode with its model card’s sampling parameters and random seed 20260923. GPQA-Diamond reports accuracy over four samples per question, IFEval reports prompt-level strict accuracy, and MMLU-Pro reports accuracy on a fixed 1,000-question subset.
| Model | Benchmark | Items | Samples | Sampling Temperature | Sampling Top-$p$ | Sampling Top-$k$ | Sampling Max tokens |
|---|---|---|---|---|---|---|---|
| Qwen3-Thinking | GPQA-D | 198 | 4 | 0.6 | 0.95 | 20 | 32,768 |
| IFEval | 541 | 1 | 0.6 | 0.95 | 20 | 32,768 | |
| MMLU-Pro | 1,000 | 1 | 0.6 | 0.95 | 20 | 32,768 | |
| Gemma 4 | GPQA-D | 198 | 4 | 1.0 | 0.95 | 64 | 32,768 |
| IFEval | 541 | 1 | 1.0 | 0.95 | 64 | 32,768 | |
| MMLU-Pro | 1,000 | 1 | 1.0 | 0.95 | 64 | 32,768 | |
| Qwen3.5$^{\dagger}$ | GPQA-D | 198 | 4 | 1.0 | 0.95 | 20 | 81,920 |
| IFEval | 541 | 1 | 1.0 | 0.95 | 20 | 32,768 | |
| MMLU-Pro | 1,000 | 1 | 1.0 | 0.95 | 20 | 32,768 | |
| $^{\dagger}$Presence penalty 1.5. |
표 5. Most of our reader’s reads go to exact channels, and the sketch takes most of the rest. Routed-expert reads per token at batch one, as a percentage of the full model, by component at the four main budgets. At the two smallest budgets, the partial screen reads part of the ternary sketch.
| Model | Sketch read | Routed-expert reads (%) Sketch | Routed-expert reads (%) Exact channels | Routed-expert reads (%) Recovery | Routed-expert reads (%) Metadata | Routed-expert reads (%) Total |
|---|---|---|---|---|---|---|
| Qwen3-Thinking | partial | 4.86 | 7.29 | 0.66 | 0.04 | 12.85 |
| partial | 4.86 | 12.30 | 0.63 | 0.04 | 17.83 | |
| full | 7.99 | 20.00 | 0.59 | 0.10 | 28.68 | |
| full | 7.99 | 30.00 | 0.54 | 0.10 | 38.62 | |
| Gemma 4 | partial | 4.78 | 7.49 | 0.54 | 0.03 | 12.84 |
| partial | 4.78 | 12.50 | 0.52 | 0.03 | 17.83 | |
| full | 7.86 | 19.99 | 0.49 | 0.08 | 28.42 | |
| full | 7.86 | 30.01 | 0.45 | 0.07 | 38.40 | |
| Qwen3.5 | partial | 5.08 | 6.98 | 0.74 | 0.04 | 12.84 |
| partial | 5.08 | 12.04 | 0.72 | 0.04 | 17.87 | |
| full | 8.33 | 20.00 | 0.68 | 0.11 | 29.11 | |
| full | 8.33 | 30.00 | 0.62 | 0.10 | 39.06 |
표 6. Our reader reads part of the sketch at the two smallest budgets and all of it above. Each column is one budget. It gives the share of candidate channels computed exactly across each token’s routed experts and the resulting total reads, which include the ternary sketch, exact channels, recovery map, and metadata, averaged over the three post-trained models and three benchmarks.
| Sketch read | partial | partial | full | full | full | full |
|---|---|---|---|---|---|---|
| Channels computed exactly (%) | 7.0–7.5 | 12.0–12.5 | 20 | 30 | 50 | 70 |
| Reads (% of full model) | 12.8 | 17.8 | 28.7 | 38.7 | 58.6 | 78.5 |
표 7. At batch one, the profiler measures 18.3% of the full model’s DRAM reads, close to the 17.8% we count. Measured DRAM reads per MoE layer on Qwen3-Thinking in MB, averaged over 12 layers, without the router, with a cold cache.
| Batch size | 1 | 4 | 8 |
|---|---|---|---|
| Full model | 75.6 | 229.1 | 359.3 |
| Our reader | 13.9 | 49.9 | 92.3 |
| Share | 18.3% | 21.8% | 25.7% |
표 8. Every calibrated threshold reads less than the budget it was calibrated for. Each row is one selector at one calibrated budget. The columns give the lowest, mean, and highest realized routed-expert reads (%) over the nine model-benchmark pairs.
| Method | Calibrated for (%) | Realized reads (%) Min | Realized reads (%) Mean | Realized reads (%) Max |
|---|---|---|---|---|
| CATS | 53.3 | 51.1 | 52.1 | 53.0 |
| 66.7 | 63.8 | 65.1 | 66.0 | |
| Our reader, calibrated | 12.8 | 11.2 | 11.8 | 12.4 |
| 17.8 | 15.2 | 16.5 | 17.1 | |
| 28.7 | 24.5 | 26.5 | 27.7 | |
| 38.7 | 32.9 | 35.8 | 37.2 | |
| Prox as published, calibrated | 13.0 | 5.6 | 8.5 | 10.1 |
| 18.0 | 9.9 | 12.9 | 14.7 | |
| 28.0 | 18.9 | 22.5 | 24.6 | |
| 38.0 | 29.6 | 32.6 | 34.1 | |
| 58.0 | 47.3 | 49.8 | 51.0 | |
| 78.0 | 67.1 | 70.0 | 71.4 | |
| TEAL as published, calibrated | 15.0 | 6.4 | 8.9 | 11.0 |
| 20.0 | 9.8 | 12.6 | 15.3 | |
| 30.0 | 19.9 | 22.6 | 24.9 | |
| 40.0 | 32.6 | 35.0 | 36.2 | |
| 50.0 | 43.7 | 46.2 | 47.4 | |
| 60.0 | 54.7 | 56.9 | 58.0 | |
| WINA score, calibrated | 15.0 | 5.4 | 7.8 | 9.6 |
| 20.0 | 8.2 | 11.2 | 13.9 | |
| 30.0 | 17.2 | 20.7 | 23.5 | |
| 40.0 | 32.0 | 34.3 | 35.8 | |
| 50.0 | 43.5 | 46.1 | 47.7 | |
| 60.0 | 54.8 | 57.1 | 58.2 |
이 글의 그림은 arXiv:2610.37386 원본에서 가져왔습니다 (CC BY 4.0). 크기와 형식만 바꿨습니다.
댓글