논문 링크 최근 언어 모델은 어휘 하나에 담는 정보를 계속 키우고 있다. Gemma 3n에서 처음 도입된 레이어별 임베딩(PLE)은 Gemma 4로 이어졌고, 어휘 항목마다 입력층 하나의 벡터 대신 디코더 레이어마다 다른 학습 벡터를 둔다. 이 글은 이 테이블을 약 100배 줄이면서 원본 성능 대부분을 유지하는 OPTIC을, 문제 상황에서 시작해 작은 예시와 방법, 결과, 한계 순으로 살펴본다.
OPTIC의 핵심 아이디어는 두 가지다. 하나는 토큰마다 코드를 하나만 저장하고 각 레이어가 자기만의 디코더로 그 코드를 펼치는 것, 다른 하나는 “저장된 벡터가 얼마나 똑같이 복원되는가"가 아니라 “모델이 실제로 쓰는 출력 경로에서 얼마나 차이가 나는가"를 기준으로 코드와 디코더를 맞추는 것이다.
PLE가 왜 문제인가
일반적인 입력 임베딩은 토큰 하나를 벡터 하나로 바꾼다. 토큰 "고양이"라면 어휘 사전에서 그 토큰이 가리키는 벡터 하나를 꺼내는 식이다. PLE는 여기에 레이어 축을 더한다. 같은 토큰이라도 레이어 1에서 쓰는 벡터와 레이어 42에서 쓰는 벡터가 다르고, 각 레이어는 자기 단계의 잔차 연결에서 그 벡터를 꺼내 쓴다. 잔차 연결은 레이어를 거칠 때마다 은닉 상태에 항을 더하는 통로다.
저장량은 곧장 커진다. E4B는 어휘 262,144개, PLE를 쓰는 디코더 레이어 42개, 벡터 폭 256차원이라, 토큰-레이어 쌍마다 벡터를 따로 적어 둔 결과 1,100만 개의 토큰-레이어 벡터를 저장한다(§1, §2.2). bfloat16으로 계산하면 약 5.64GB다(§2.2). 같은 체크포인트에서 PLE가 차지하는 파라미터 비중은 35.2%다(초록). 더 작은 E2B에서는 45.8%다(§1).
설명용 예시로 한 토큰이 실제로 무엇을 남기고 무엇을 하는지 보자(E4B 기준).
| 단계 | 상태 |
|---|---|
| 입력 | 토큰 ID 하나 (예: "고양이") |
| 남는 상태 | 레이어마다 하나씩 42개의 256차원 벡터 = 42×256 = 10,752개의 숫자, bfloat16 기준 21,504바이트 |
| 레이어에서 벌어지는 일 | 그 레이어의 벡터가 게이트와 원소별 곱을 거치고 출력 투사 행렬로 은닉 폭에 투사된다 |
| 출력 | 은닉 상태에 더해지는 PLE 잔차 |
이 테이블을 약 100배 압축하면 벡터 하나당 5바이트 남짓 남는다(§1). 기존 양자화 기법은 이 몇 바이트를 “벡터 하나마다의 코드"로 소비한다. 벡터 1,100만 개가 각자 자기 코드를 갖다 보니 코드가 지나치게 짧아져 복원 품질이 크게 떨어진다.
OPTIC은 어떻게 저장하고 복원하는가
문제는 명확하다. 5바이트는 벡터 하나를 제대로 담기에 부족하다. PLE 테이블에는 토큰 축과 레이어 축이라는 두 방향이 있는데, OPTIC은 두 방향을 동시에 공유한다(§2.2).
- 토큰 방향: 토큰 하나가 42개 벡터를 각자 저장하는 대신, 토큰마다 코드 하나를 저장한다.
- 레이어 방향: 한 레이어의 모든 토큰은 하나의 아핀 디코더(행렬 곱과 더하기)를 공유한다. 이 디코더의 크기는 어휘 수에 무관하다.
구체적으로 토큰 t는 M개의 인덱스를 적어 둔다. 각 인덱스는 자기 코드북에서 4차원 코드워드 하나를 가리키고, M개를 이어 붙이면 토큰을 요약하는 잠재 벡터 z_t가 된다. 그다음 레이어 ℓ는 자기만의 아핀 디코더로 z_t를 256차원 행으로 펼친다.
E4B의 약 100배 설정에서는 M=161, 코드워드 256개(K=256)를 쓴다. 토큰 하나는 인덱스 161개, 즉 161바이트만 저장하면 되고, 42개 벡터의 21,504바이트가 161바이트로 줄어든다(§2.2). 대신 코드북(약 330KB)은 전체가, 42개 레이어의 디코더 가중치(약 13.8MB)와 바이어스는 해당 레이어의 모든 토큰이 나눠 쓴다. 전체를 합치면 56.4MB로, 원본 5.64GB 대비 99.94배다(§2.2, Table 16).
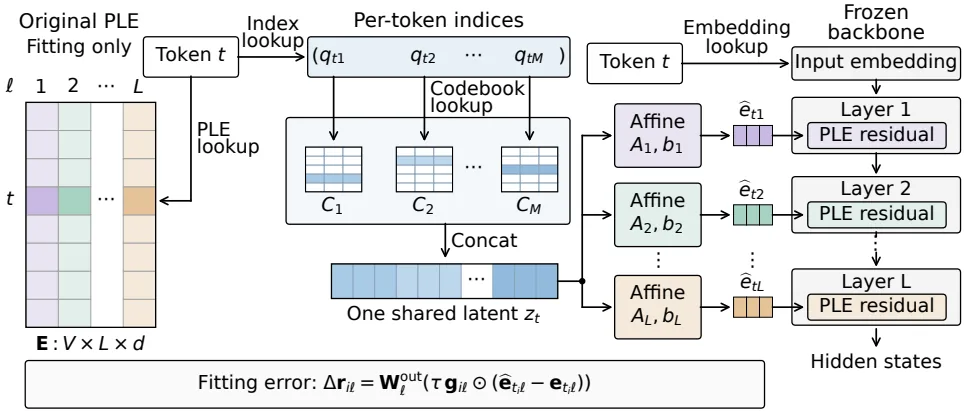
위 그림을 상태 변화로 읽으면 다음과 같다. 입력은 토큰 t의 ID 하나다. 저장 상태는 어휘 행 t에 놓인 인덱스 M개(예: 161바이트)다. 각 인덱스 q_{tm}은 자기 코드북 C_m의 행 하나(강조된 칸)를 고르고, 고른 코드워드 161개를 이어 붙여 잠재 벡터 z_t(길이 644)를 계산한다. 이때 레이어는 아직 개입하지 않는다. 이어 레이어 ℓ가 자기 아핀 가중치 A_ℓ와 바이어스 b_ℓ를 적용해 256차원 행 ê_{tℓ}을 계산하고, 그 행이 레이어 ℓ의 PLE 잔차로 이어진다. 색이 같은 칸은 같은 레이어를 가리키고, 점선(ellipsis)은 생략된 레이어와 코드북을 나타낸다. 원본 PLE는 “맞추는(fitting) 단계"에서만 쓰고, 실제 저장과 복원에는 쓰지 않는다는 점이 중요하다(원문 Figure 1).
핵심은 인덱스를 저장하는 비용이 어휘 수 V에만 비례하고 V × L에 비례하지 않게 됐다는 점이다. 기존의 행 단위 양자화는 벡터 하나마다 인덱스 모음을 저장해야 해서 레이어 수만큼 곱해지지만, OPTIC은 이 레이어 인자를 없앤다(§2.2, Equation 3).
왜 “출력 경로"에서 맞추는가
저장만 공유해도 끝이 아니다. PLE 벡터는 그 자체로 쓰이는 게 아니라, 각 레이어에서 게이트와 출력 투사를 거쳐 은닉 상태에 더해진다. 구체적으로 PLE 행은 레이어의 은닉 상태에서 만든 게이트와 원소별로 곱해진 뒤, 출력 투사 행렬 W_out으로 은닉 폭에 투사된다(§2.3).
따라서 복원 벡터가 원본과 “좌표상으로” 얼마나 비슷한지보다, 게이트와 출력 투사를 지난 뒤 얼마나 차이가 나는지가 모델 품질에 더 직접적으로 작용한다. OPTIC은 저장된 좌표가 아니라 이 투사 출력에서의 오차를 최소화하도록 코드와 디코더를 맞춘다(§2.3, Equation 4–5).
$$ \Delta r_{i\ell}(\theta) = W^{\mathrm{out}}_\ell \bigl( \tau\, g_{i\ell} \odot (\hat e_{\theta, t_i \ell} - e_{t_i \ell}) \bigr) $$여기서 g_{iℓ}은 캘리브레이션 위치 i와 레이어 ℓ의 게이트, τ는 고정된 PLE 스케일, ⊙는 원소별 곱이다. 학습 기록의 게이트는 압축 전 모델에서 수집해 고정한 채로 쓴다. 합성 기록의 게이트는 1로 채운다(§3.2). 목표 함수는 이 투사 출력 오차 ‖Δr‖²를 위치와 레이어에 걸쳐 평균한 값이다(§2.3, Equation 5).
맞추는 절차는 두 종류의 갱신을 번갈아 한다(§2.4, Algorithm 1). 하나는 코드를 고정한 채 코드북과 디코더를 연속적으로(AdamW로) 갱신하는 것, 다른 하나는 코드북을 고정한 채 각 토큰의 인덱스를 가장 오차가 작은 코드워드로 다시 배정하는 것이다. 재배정은 어휘 전체 토큰을 대상으로 한다. 자연어 캘리브레이션에 자주 나오지 않는 희귀 토큰까지 다루기 위해, 게이트 정보를 레이어별로 평균한 지표 G_ℓ를 대리 목표로 쓴다(§2.4, Equation 6–7). 초기화는 토큰별 벡터를 이어 붙인 뒤 어휘 평균을 빼고 출력 경로 가중치로 스케일한 PCA로 잠재 벡터와 디코더를 만들고, 좌표를 코드북 그룹에 나누는 OPQ 방식의 배정으로 시작한 뒤 그룹 안에서 K-means를 돌린다.
결과: 품질은 유지되고 메모리는 줄어든다
먼저 품질부터 보자. 논문은 7개 태스크(PIQA, GSM8K, GPQA Diamond, AIME 2026, MMLU-Redux, IFBench, InfographicVQA)에서 “원본 대비 성능 유지율"의 기하평균을 보고한다. 각 태스크의 유지율은 100%로 상한을 쳐서, 한 태스크의 초과 달성이 다른 태스크의 손실을 덮지 못하게 한다. 한 태스크라도 0점이면 기하평균이 0이 된다(§3.3, Equation 8).
질문: 약 100배 압축에서 기존 양자화 기법과 OPTIC은 얼마나 버티는가? 아래는 E4B의 결과다(Table 1).
| 방법 | BF16 유지율 | W4A16 유지율 |
|---|---|---|
| PQ | 66.3% | 82.4% |
| AQLM 유클리드 빔 인코더 | 46.7% | 82.8% |
| 출력 경로 가중 PCA-PQ | 93.3% | 88.3% |
| OPTIC | 97.8% | 96.9% |
| 주파수 계층형 OPTIC | 95.7% | 95.1% |
BF16 E4B에서 OPTIC은 가장 강한 기존 기법(PQ)보다 31.5%포인트 앞서고, W4A16에서는 가장 강한 기법(AQLM)보다 14.0%포인트 앞선다(§4.1). E2B에서는 OPTIC이 BF16에서 89.1%, W4A16에서 91.5%를 유지하고, 주파수 계층형 변형이 90.0%와 93.0%로 가장 높다(§4.1, Table 1). 주파수 계층형 변형은 자주 나오는 토큰에 코드 그룹을 더 주고, 나머지 토큰은 그룹마다 학습된 공유 코드워드를 쓰며, 특수 토큰의 PLE 행만 bfloat16으로 정확히 보존한다(§2.5, Appendix A.3).
실제 태스크 점수를 보면 차이가 어디서 나는지 보인다. BF16 E4B에서 GSM8K는 원본 92.9% 대비 OPTIC 92.8%, PQ 73.5%다. IFBench는 원본 44.0% 대비 OPTIC 41.7%, PQ 16.0%이고, InfographicVQA는 원본 69.7% 대비 OPTIC 67.5%, PQ 38.4%다(§4.1, Table 12). 수학 추론·지시 따르기·시각 질의응답에서 기존 기법의 하락이 특히 크다. 부트스트랩 95% 신뢰구간도 갈린다. BF16 E4B에서 OPTIC은 95.5–99.0%, PQ는 60.6–70.5%다. W4A16 E4B에서는 OPTIC이 93.9–97.8%, AQLM이 76.8–87.1%다(Table 2). 이 구간은 벤치마크 표집 불확실성을 반영한다.
압축률을 더 높여도 OPTIC은 버틴다. 아래 곡선은 압축률(가로축, 로그 스케일)에 따른 유지율(세로축)을 그린 것이다.
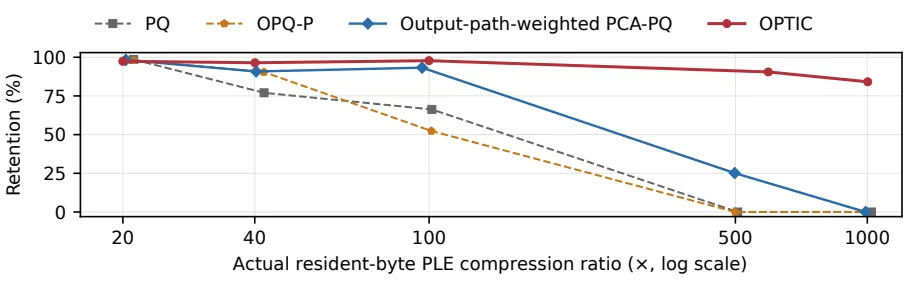
점선이 기존 기법(PQ, OPQ-P), 실선이 저자의 방법이다. OPTIC은 약 100배에서 97.8%를 유지하고, 594배와 1002배까지 올라가도 각각 90.5%, 84.1%를 지킨다. 같은 지점의 W4A16 E4B는 87.7%와 81.8%다(§4.2, Table 16). 반면 행 단위로만 개선한 출력 경로 가중 PCA-PQ는 100배 근처에선 93.3%로 좋지만 500배 근처에서 25.1%로 떨어지고 1000배 근처에선 0이 된다(§4.2). 벡터 하나에 남는 바이트가 적을수록, 토큰 단위로 코드를 공유한 이점이 커진다.
커널 속도와 시스템 성능은 따로 본다
품질 외에, 실제 서빙에서 메모리와 시간이 어떻게 되는지는 별도 측정이다. 저자는 vLLM으로 RTX 4090 한 대에서 원본 PLE와 약 100배 압축 PLE를 같은 설정(고정 1GiB KV 캐시)으로 비교했다(§6).
메모리는 시스템 관점에서 크게 줄어든다. BF16 E4B의 프로세스 GPU 메모리가 18.57GB에서 13.05GB로 29.7% 줄고, W4A16에서는 12.95GB에서 7.37GB로 43.1% 줄었다(Table 7). 이는 GPU에 상주하는 PLE가 5.64GB에서 56.4MB로 줄었기 때문이다.
시간은 커널 관점과 시스템 관점으로 나눠 읽어야 한다. 테이블이 호스트 메모리에 있는 조건의 단일 조회 측정에서는, 토큰 하나는 밀집 조회가 더 빠르지만(압축 조회는 0.6배), 토큰 32개부터는 압축 조회가 더 빨라져 8192개에서는 12.1배다(Table 11). 전체 서빙 시간으로 보면 압축 PLE가 BF16에서 최대 0.40%, W4A16에서 최대 0.69% 더 느린 수준에 그친다(Table 9). 압축 조회는 코드를 디코더로 펼치는 곱셈을 추가로 수행해야 해서, 같은 캐시 예산에서는 “메모리는 크게 줄고 시간은 거의 같다"가 결론이다.
다만 메모리가 진짜 병목인 상황은 다르다. 동일 GPU 예산에서 밀집 PLE로는 KV 캐시에 들어가지 않아 기동하지 않거나 요청을 순차 처리할 때, 압축 PLE는 완료 시간을 최대 2.1배까지 줄인 사례가 있다(§B.3, Table 10). 즉, 서빙 시간 절약 자체가 목적이 아니라 메모리가 지연으로 이어질 때 이득이 생긴다.
왜 이렇게 되는가
레이어 평균만으로는 부족하다는 분석부터 보자. 각 벡터를 그 레이어의 어휘 평균으로 통째로 바꾸면, 평균 벡터가 테이블 전체 제곱 놈의 8.1%만 차지하는데도 GSM8K가 92.9%→43.5%, GPQA가 56.9%→23.0%로 떨어지고 AIME은 0이 된다(§5.1, Appendix E.3). 즉 토큰마다 다른 정보가 성능의 핵심이다.
그렇다면 그 토큰별 변동이 저차원에 몰려 있는가? 다음 그림이 이 질문에 답한다.
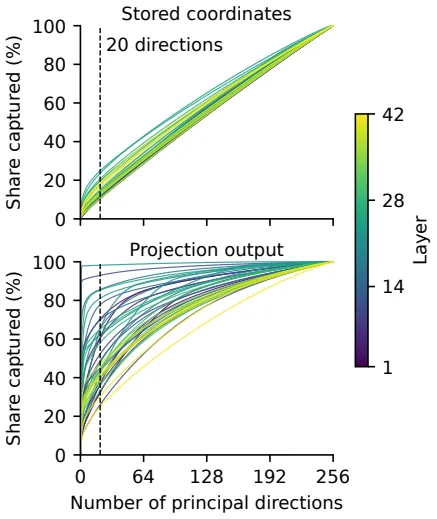
위 패널은 저장된 좌표, 아래 패널은 출력 투사 뒤의 좌표에서, 각 곡선(레이어)의 토큰별 변동이 주성분 몇 개에 의해 설명되는지(가로축: 주성분 수, 세로축: 누적 설명 비율)를 보여준다. 저장 좌표에서는 90%를 설명하려면 212~227개 방향이 필요하다. 출력 투사 뒤에서는 레이어마다 1~205개(중앙값 158)로 줄어든다(§5.1, Figure 3). 이 간격이 OPTIC이 “출력 경로에서 맞추는” 선택의 근거다. 게이트와 투사를 지나면 중요한 변동이 상당히 저차원 쪽으로 몰리므로, 낮은 잠재 폭이 어느 정도 견딜 수 있다는 신호다.
두 가지 설계를 각각 끊어 검증한 실험도 있다. 하나는 코드 공유 효과다. 토큰-레이어 벡터마다 독립 잠재 코드를 두고 같은 맞춤 절차를 적용하면, 거의 같은 저장 예산에서 E4B BF16 유지율이 97.8%에서 79.3%로 떨어진다(Table 3). 이 차이에는 공유 자체의 효과와 바이트가 코드와 디코더 사이에 재배분되는 효과가 섞여 있다는 점은 한계 절에서 다시 본다. 디코더의 자유도도 중요하다. 인덱스·코드북·바이어스를 고정한 채 디코더만 최소제곱으로 다시 맞추면서 랭크를 레이어당 20으로 제한하면, 유지율이 95.09%에서 70.55%로 떨어진다(§5.2, Table 4).
다른 하나는 출력 경로 맞춤의 효과다. 코드와 초기화를 고정하고 목적 함수만 바꿔 보면, 유클리드 오차 대비 문맥 의존 출력 경로 목적이 평균 1.98%포인트, 대각 근사 대비 0.31%포인트 더 높은 유지율을 준다(§5.3, Table 5). 또 연속 갱신이 이득의 대부분을 만들고(초기화만 63.60%, 연속 갱신 94.67%), 인덱스 재배정이 그 위에 0.65~1.14%포인트를 더한다(§5.3, Table 6).
한계와 적용 판단
OPTIC을 실제로 쓸지 판단하려면 저자가 밝힌 한계와 그 밖의 조건을 구분해야 한다.
저자가 명시한 한계부터 보자. 평가 대상은 Gemma 4 E2B·E4B로 한정됐고, 주 비교는 고정된 피팅 시드 하나로 이뤄져 신뢰구간은 벤치마크 표집 불확실성만 반영한다(한계 절). 베이스라인 6종은 원 논문의 방법을 PLE에 맞춰 재구성한 것으로, 원래 설정의 결과와 직접 이어 읽을 수 없다(한계 절). 코드 공유 제거 실험은 바이트를 코드와 디코더 사이에 다시 나누는 효과까지 섞여 있어, “순수한 공유 효과"만을 재는 것은 아니다(한계 절). 캘리브레이션은 자연어 786,432개 위치에 어휘 전체를 덮는 합성 레코드(게이트는 1)를 더하는 방식이라(§3.2), 자연어에 잘 나오지 않는 토큰은 합성 기록만으로 맞춰진다. 출력 경로 손실도 게이트를 고정한 채 각 층의 투사 출력에서만 오차를 재는 근사다(한계 절).
리뷰어 관점에서 짚어 둘 것은 세 가지다. 첫째, 이 기법은 PLE처럼 “토큰×레이어” 구조를 가진 임베딩에 특화돼 있어, 일반적인 단일 입력 임베딩에는 코드 공유의 레이어 축이 없으므로 이점이 그대로 이어지지 않는다. 둘째, 유지율은 7개 태스크의 기하평균이고 한 태스크라도 0점이면 전체가 0이 되므로, 표본이 적은 태스크가 붕괴하면 지표가 크게 흔들린다. 극한 압축(1000배)에서 특정 태스크가 붕괴하는지 개별 점수를 확인해야 하는데, 원문은 극한 압축 조건의 태스크별 점수는 보고하지 않는다(Table 12·13은 100× 조건만 수록, 해당 수치 원문 미보고). 셋째, 앞 서빙 절의 이득은 메모리 병목 조건에 의존하므로, 그 조건이 없는 환경에서는 기대할 것이 적다.
결론적으로 OPTIC은 “임베딩 테이블이 모델의 큰 부분을 차지하고, GPU 메모리가 제약인” 환경, 특히 PLE 계열 모델을 여러 요청으로 동시에 서빙할 때 유망하다. W4A16 본체 양자화와도 함께 쓸 수 있다. 저장되는 벡터가 아니라 모델이 실제로 소비하는 곳에서 맞춘다는 관점은, 임베딩 용량과 압축 표현을 처음부터 함께 설계할 여지가 있음을 보여준다(결론).
논문 원문의 표
arXiv e-print 의 LaTeX 원본에서 기계적으로 옮긴 표입니다. 숫자는 논문의 값이며 모델을 거치지 않았습니다.
표 1. PLE compression on the original BF16 and official W4A16 releases at the nominal $100\times$ tier. Cells report compression ratio $R$ / seven-task retention (%) relative to the matched uncompressed PLE. A zero denotes at least one zero task score. Bold marks the highest retention in each column.
| Method | Original BF16 E2B $R$ / Retention | Original BF16 E4B $R$ / Retention | Official W4A16 E2B $R$ / Retention | Official W4A16 E4B $R$ / Retention |
|---|---|---|---|---|
| Baselines | ||||
| PQ | 101.24/22.9 | 101.43/66.3 | 101.24/0.0 | 101.43/82.4 |
| RVQ | 100.96/0.0 | 98.64/37.6 | 100.96/29.3 | 101.20/82.0 |
| OPQ-P | 100.92/0.0 | 101.16/52.4 | 100.92/0.0 | 101.16/57.9 |
| AQ | 100.96/0.0 | 101.20/45.6 | 100.96/0.0 | 101.20/62.8 |
| AQLM Euclidean beam encoder | 100.96/20.7 | 101.20/46.7 | 100.96/32.0 | 101.20/82.8 |
| INT8 randomized low-rank SVD | 100.13/0.0 | 99.76/37.7 | 100.13/0.0 | 100.24/51.1 |
| Our methods | ||||
| Output-path-weighted PCA-PQ | 96.14/32.2 | 96.36/93.3 | 96.14/44.5 | 96.36/88.3 |
| OPTIC | 99.86/89.1 | 99.94/97.8 | 99.86/91.5 | 99.94/96.9 |
| Frequency-tiered OPTIC | 100.48/90.0 | 100.00/95.7 | 100.48/93.0 | 100.00/95.1 |
표 2. Paired-bootstrap confidence intervals for the four primary nominal-$100\times$ comparisons. Retention is reported in percent.
| Setting | Our method | Retention (95% interval) | Strongest baseline | Retention (95% interval) |
|---|---|---|---|---|
| E2B, BF16 | OPTIC | 89.1 [85.8, 91.8] | PQ | 22.9 [0.0, 28.8] |
| E4B, BF16 | OPTIC | 97.8 [95.5, 99.0] | PQ | 66.3 [60.6, 70.5] |
| E2B, W4A16 | OPTIC | 91.5 [89.3, 93.3] | AQLM Euclidean beam encoder | 32.0 [0.0, 38.9] |
| E4B, W4A16 | OPTIC | 96.9 [93.9, 97.8] | AQLM Euclidean beam encoder | 82.8 [76.8, 87.1] |
표 3. Seven-task retention (%) near $100\times$ PLE compression with fit seed 0, relative to the uncompressed checkpoints of Tables and . Independent latent codes use the main method’s fitting recipe and calibration data, with 0.8–0.9% fewer resident bytes. OPTIC values are the main results of Table . Output-path-fitted additive codes keep their standard initializer.
| Representation | E2B BF16 | E4B BF16 | E2B W4A16 | E4B W4A16 |
|---|---|---|---|---|
| Independent latent codes | 28.5 | 79.3 | 53.7 | 86.8 |
| Additive codes | 42.1 | 90.0 | 83.5 | 94.4 |
| OPTIC | 89.1 | 97.8 | 91.5 | 96.9 |
표 4. Decoder refits on the three E4B BF16 fits of Table , which use a common Euclidean initialization, near $100\times$. Values are means and sample standard deviations over fit seeds 0, 1 and 2. Refits keep each fit’s indices, codebooks and biases, constrain rank before float16 storage, and share the uncompressed reference of Table .
| Decoder refit with fixed codes | Retention (%) |
|---|---|
| Rank unlimited | $95.09\pm0.48$ |
| Fitted rank at most 20 per layer | $70.55\pm1.18$ |
표 5. Fixed-code fitting on E4B BF16 near $100\times$, with the common Euclidean initialization and 5,000 continuous updates. Each loss is divided by its value for an all-zero reconstruction. Values are means and sample standard deviations over three fits.
| Fixed-code objective | Retention (%) |
|---|---|
| Euclidean | $92.76\pm1.16$ |
| Diagonal output path | $94.44\pm0.94$ |
| Context-dependent output path | $94.74\pm0.59$ |
표 6. Optimization on E4B BF16 near $100\times$. Values are means and sample standard deviations over three fits. The last two rows use 5,000 continuous updates, and the final row adds 18 reassignment sweeps.
| Optimization recipe | Retention (%) |
|---|---|
| Initialization only | $63.60\pm3.68$ |
| Continuous updates only | $94.67\pm0.53$ |
| Continuous updates + reassignment | $95.49\pm0.40$ |
표 7. Post-initialization process GPU memory for E4B on an RTX 4090 with a fixed 1 GiB key-value cache, averaged over two engine initializations. Resident PLE storage falls from 5.64 GB to 56.4 MB.
| Backbone | Dense (GB) | Compact (GB) | Saved (%) |
|---|---|---|---|
| BF16 | 18.57 | 13.05 | 29.7 |
| W4A16 | 12.95 | 7.37 | 43.1 |
표 8. Model releases used for fitting and evaluation. The final column gives a 12-character revision prefix.
| Scale | Role | Hugging Face model | Version |
|---|---|---|---|
| E2B | Evaluated BF16 | google/gemma-4-E2B-it | b446025c61ec |
| E4B | Evaluated BF16 | google/gemma-4-E4B-it | ee0ef6023621 |
| E2B | PLE fit for W4A16 | google/gemma-4-E2B-it-qat-q4_0-unquantized | 6befbaca7398 |
| E4B | PLE fit for W4A16 | google/gemma-4-E4B-it-qat-q4_0-unquantized | 476025a01dbf |
| E2B | Evaluated W4A16 | google/gemma-4-E2B-it-qat-w4a16-ct | 971342c08f60 |
| E4B | Evaluated W4A16 | google/gemma-4-E4B-it-qat-w4a16-ct | 6cd26aaa2357 |
이 글의 그림은 arXiv:2610.31309 원본에서 가져왔습니다 (CC BY 4.0). 크기와 형식만 바꿨습니다.
댓글