토큰을 하나씩 뽑는 순차 병목
대형 언어 모델은 학습 때 문장 전체를 함께 계산할 수 있지만, 글을 만들 때는 앞 토큰을 알아야만 다음 토큰을 고를 수 있다. GPU가 아무리 빨라도 이 순서를 한 번에 건너뛸 수 없어 생성 지연이 커진다. 이 글은 이 병목을 블록 단위 flow로 푸는 Lafa(Large flow language model)를 다룬다.
Lafa는 이미 학습된 자기회귀 모델을 되살려 쓴다. 한 번의 계산으로 블록 전체의 후보 토큰을 만들고, 자기회귀 예측으로 앞에서부터 검증해 확정한다. 결과적으로 같은 품질 수준에서 기존 자기회귀 대비 최대 2.54배의 처리량을 얻는다. 정확한 조건과 숫자는 뒤에서 다시 짚는다.
왜 flow인가, 그리고 블록 단위로 쪼개는 이유
기존 병렬 생성 방법인 이산 확산(discrete diffusion)은 토큰을 [MASK]로 지웠다가 되살리는 방식이다. 한 스텝에서 여러 위치를 독립적으로 샘플링하면 위치 사이 관계가 끊겨 품질이 떨어질 수 있다.
flow는 이와 다르게 토큰을 지우지 않는다. 토큰 임베딩 벡터에 가우시안 노이즈를 섞은 뒤, 노이즈에서 깨끗한 임베딩으로 이어지는 연속 경로를 거꾸로 적분해 토큰을 만든다. 연속 공간에서 움직이기 때문에 이미지·비디오 생성에서 나온 가속·제어 기법을 그대로 쓸 수 있다. 다만 기존 flow 언어 모델은 소규모·단순 과제에서만 보여졌고, 한 차례 스케일링 시도는 학습 비효율을 지적했으며, 수십억 파라미터로 키우는 방법은 아직 정립되지 않았다(§1, §2).
Lafa는 flow를 블록 단위로 쪼갠다. 전체 문장을 통째로 만드는 대신, 앞서 확정한 글(prefix)을 조건으로 크기 $B$의 토큰 블록을 하나씩 생성하고, 블록 사이는 인과적으로 이어 붙인다. 문장 확률을 블록의 곱으로 인수분해한 셈이다.
$$p(y\mid c)=\prod_{r} p\bigl(y^{rB+1:(r+1)B}\mid c,\,y^{\le rB}\bigr)$$블록 단위로 쪼개면 두 가지를 얻는다. 첫째, prefix의 키·값(KV) 캐시—이전 토큰 계산에서 나온 어텐션 중간 결과—를 블록마다 다시 쓸 수 있다. 둘째, 병렬 생성을 블록 안쪽에 한정할 수 있다(§2.1). 토큰을 임베딩 위에서 다루면 토큰 한 개의 차원이 어휘 크기 $|V|$에서 임베딩 차원 $d$로 줄어 학습도 확장하기 쉬워진다.
블록 안의 비동기 flow
블록의 모든 위치가 같은 속도로 노이즈에서 벗어나면, 왼쪽에서 오른쪽으로 읽는 텍스트의 방향성이 사라진다. Lafa는 각 위치 $i$에 자기만의 진행 시계 $\tau^i(t)$를 준다. 앞쪽 위치의 시계가 더 빨리 돌아 앞 토큰이 먼저 드러난다. 노이즈 $x_0$에서 깨끗한 임베딩 $x_1$으로 가는 경로는 다음과 같다.
$$I_t^i=(1-\tau^i(t))\,x_0^i+\tau^i(t)\,x_1^i$$$\tau$는 고정하지 않는다. 학습 중 손실이 큰 구간을 천천히 지나가도록 데이터에서 배운다. 이렇게 하면 학습 샘플과 추론 스텝이 어려운 노이즈 수준에 몰린다. 학습된 스케줄은 일반적으로 앞 위치가 먼저 진행하는데(Fig. learned_time의 가로축은 기준 시간 $t\in[0,1]$, 세로축은 위치별 $\tau^i(t)$, 곡선은 블록 위치 1, 4, 7, …, 16에 대응한다), 이 좌→우 편향은 수동으로 강제한 것이 아니라 학습에서 나온 것이다(§2.1).
설명용 예시. prefix “오늘 날씨가"의 임베딩 3개가 이미 확정되어 있고, 블록 크기 $B=3$으로 “맑다/흐리다/.“를 만들어야 한다고 하자.
| 단계 | 입력 | 유지되는 상태 | 바뀌는 상태 | 출력·버리는 값 |
|---|---|---|---|---|
| 시작 | prefix 임베딩 3개, 노이즈 벡터 3개 | prefix KV 캐시 | — | — |
| 스텝 $k$ | 기준 시간 $t_k$, 현재 상태 $\hat x_{t_k}$ | prefix KV 캐시 | 앞 위치 $\tau$가 먼저 커지고 $\hat x$가 임베딩에 가까워짐 | 중간 노이즈 $\hat x_{t_k}$ |
| 종료 | $K$번의 오일러 스텝 뒤 | prefix KV 캐시 | 최종 $\hat x$에서 토큰 확정 | “맑다/흐리다/.” |
확정된 토큰의 KV를 이어 붙이고 다음 블록으로 넘어간다. 이 예시는 이해를 돕기 위한 것이며, 뒤의 측정값과는 무관하다.
자기회귀 모델에서 flow를 배우는 설계
핵심은 flow 모델을 처음부터 키우는 것이 아니라, 이미 학습된 자기회귀 모델을 블록 디노이저로 개조하는 것이다. 디노이저는 노이즈 낀 블록을 보고 각 위치의 깨끗한 토큰 확률을 예측하는 함수다. 문제는 이 개조가 자기회귀 예측과 prefix 캐시를 해치면 안 된다는 점이다. 논문은 세 가지 설계로 해결한다(§2.2).
첫째, tokenwise 시간 조건부. prefix에는 시간 1(노이즈 없음)을, 블록의 각 위치에는 자기 시간 $\tau^i(t)$를 넣는다. 이 값은 적응형 레이어 정규화(adaLN)—레이어 출력을 입력에 따라 다시 정규화하는 장치—로 주입된다. adaLN을 항등 함수로 초기화하면, 시간 조건이 처음에는 기존 계산을 그대로 두고 점차 학습된다.
둘째, 블록 양방향 어텐션. 블록 내부 토큰끼리는 서로 볼 수 있게 해, 아직 덜 정리된 뒷 토큰이 앞 토큰을 돕게 한다. prefix는 기존처럼 인과적으로만 본다. 덕분에 prefix의 키·값이 블록 상태에 의존하지 않아 디노이징 스텝마다 재사용할 수 있다.
셋째, 임베딩 norm 고정. 임베딩을 자유롭게 갱신하면 노이즈 스케일에 비해 L2 norm이 커져 디노이징이 쉬워지는 편법이 생긴다. 사전학습된 norm을 고정하고 방향만 학습한다.
학습 손실은 세 항을 합친다. prefix에 대한 자기회귀 교차 엔트로피, 블록 토큰에 대한 디노이징 교차 엔트로피, 예측 임베딩과 실제 임베딩의 제곱 오차다(식 6). 자기회귀 손실을 같이 두면 flow 정확도까지 올라간다. 이 공동 학습 덕분에 flow를 배우면서도 자기회귀 능력이 보존되거나 오히려 좋아진다. 멀티 토큰 예측이 다음 토큰 예측을 개선한다는 기존 관찰과도 일치한다(§2.2, §3.2).
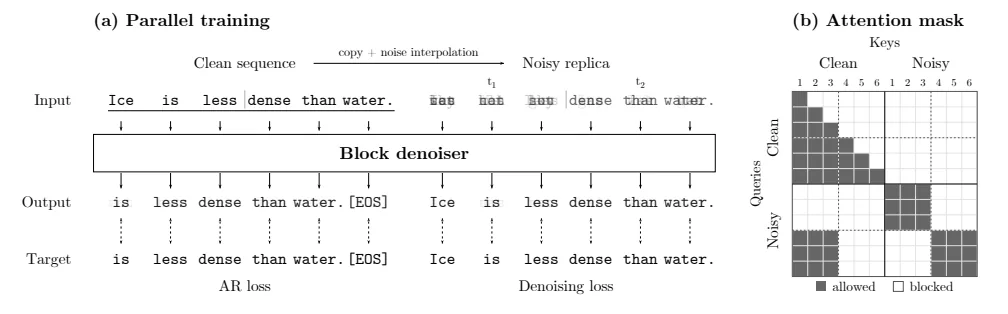
위 그림(원문 Figure training)은 병렬 학습의 상태 변화를 보여준다. 위쪽 깨끗한 시퀀스는 인과 어텐션으로 자기회귀 예측을 만들고, 아래쪽 복사본은 블록 크기 3으로 나뉘어 각 블록이 앞의 깨끗한 토큰만 보고 블록 내부는 양방향으로 디노이징 예측을 만든다. 한 번의 forward pass로 자기회귀 손실과 모든 블록의 디노이징 손실을 동시에 얻어, 겹치는 prefix를 다시 계산하지 않는다.
ablation으로 확인한 설계 효과
0.5B·블록 4·32 오일러 스텝에서 각 설계를 한 번씩 되돌려 놓고 평균 정확도를 비교했다(Table design-ablations).
| 바꾼 항목 | 비교 조건 | 평균 정확도 |
|---|---|---|
| 어텐션 | 완전 인과 | 32.7% |
| 블록 양방향 | 38.0% | |
| 시간 스케줄 | 동기(모든 위치가 같은 $t$) | 36.2% |
| 비동기 tokenwise | 38.0% | |
| 임베딩 | 완전 동결 | 34.4% |
| 무제한 갱신 | 36.9% | |
| norm 고정 | 38.0% | |
| 손실 | 디노이징 교차 엔트로피만 | 33.6% |
| 제곱 오차만 | 29.7% | |
| 두 항 | 35.8% | |
| 두 항 + 자기회귀 | 38.0% |
어텐션·시간·임베딩·손실 네 축에서 모두 원래 설계가 낫다. 특히 자기회귀 손실을 더하면 flow 정확도가 오히려 올라가며, AR 보존과 flow 생성이 서로를 해치지 않는다.
flow map 증류로 스텝 수 줄이기
flow 디코딩은 블록마다 디노이저를 여러 번 불러야 해 비용이 크다. 이를 줄이기 위해 flow map 증류를 쓴다. 상태를 시간 $s$에서 $t$로 직접 옮기는 함수 $\hat X_{s,t}$를 학생 모델로 배워, 오일러 스텝 여러 번을 한 번의 점프로 대체한다. 사선($s=t$) 예측은 교사와 맞추고, 비사선($s\lt t$) 예측은 짧은 점프 두 번을 합친 결과에 맞추는 반군(semigroup) 방식이다. 학생은 prefix 캐시를 유지하며 최소 1스텝($\hat X_{0,1}$) 생성까지 가능하다(§2.2).
초안과 검증을 한 번에: self-speculative decoding
flow 디코딩으로 AR 수준 품질을 내려면 스텝을 여러 번 밟아야 한다. Lafa는 비싼 다중 스텝을 버리고, 1스텝 flow로 블록 초안을 뽑은 뒤 자기회귀 예측기로 검증하는 방식을 기본으로 쓴다(§2.3).
초안은 노이즈에서 한 번의 디노이저 평가로 얻는다. 초안의 각 위치를 자기회귀 예측과 앞에서부터 비교하고, 일치하는 가장 긴 prefix만 확정하며 나머지는 버린다. 첫 토큰부터 다르면 자기회귀 쪽 토큰으로 교체한다. 최종 출력은 모델의 탐욕적(greedy) 자기회귀 출력과 정확히 같다. flow는 속도를 올리는 데만 쓰이고, 품질 기준은 탐욕적 자기회귀와 같아진다.
단순 구현에서는 검증 forward와 다음 초안 forward가 따로 필요해 손해가 난다. 논문은 이를 융합(fused) 디코딩으로 없앤다. 이전 초안의 검증과 다음 블록의 초안 생성을 한 번의 forward pass에 섞는 것이다.
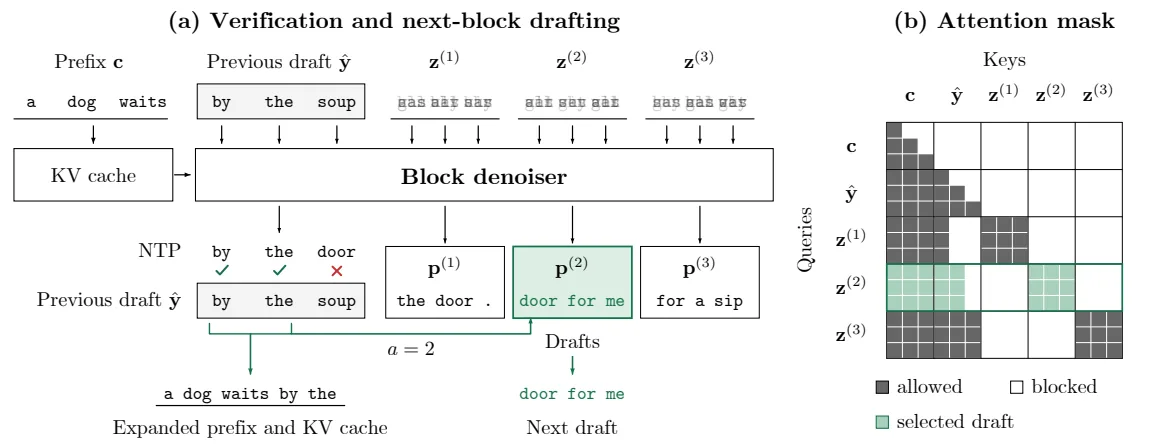
위 그림(원문 Figure fused_decoding)은 블록 크기 3에서 한 단계가 어떻게 흐르는지 보여준다. 가로 방향은 시퀀스 위치, 세로 블록은 각 forward에 들어간 입력 조각이다.
| 단계 | 입력 | 유지 | 변경·거절 | 출력 |
|---|---|---|---|---|
| 직전 단계 끝 | prefix KV, 초안 $\hat y$ | prefix KV | — | — |
| 융합 forward | 깨끗한 초안 $\hat y$ + 후보 노이즈 블록 $B$개 | prefix KV | 후보 각각은 “앞에서 $j$개 수용” 가정 | 검증 로짓, 후보 초안 $B$개 |
| 검증 | 검증 로짓 vs 자기회귀 예측 | 수용된 prefix KV | 불일치 위치 이후 초안·후보는 버림 | 수용 길이 $a$, 다음 초안 |
| 다음 단계 | 확장된 prefix | 갱신된 KV 캐시 | — | 반복 |
깨끗한 초안은 prefix처럼 붙여 인과 어텐션으로 검증 로짓을 만들고, 동시에 “앞 초안이 $j$개 수용되는 경우"에 해당하는 후보 노이즈 블록을 붙여 한 번에 처리한다. 검증 결과 실제로 수용된 길이의 후보 블록을 골라 다음 초안으로 삼아, 별도의 재초안 forward를 없앤다.
이 방식은 학습된 모델 하나로 초안과 검증을 모두 수행하므로 self-speculative(자기 추측)라 부른다. 별도의 작은 초안 모델이나 추가 파라미터가 필요 없다. 대안으로 자기회귀 검증 대신 토큰 확률이 임계값을 넘는 prefix만 수용하는 confidence 디코딩도 가능하지만, 임계값을 낮추면 속도 대신 정확도가 떨어지므로 논문은 self-speculative를 기본으로 둔다(§3.3, Appendix confidence_results).
결과: 품질은 유지하고 속도를 올린다
모델은 Qwen2.5 0.5B·7B Instruct와 Qwen3 8B Base를 초기화로 쓰고, Dolci-Instruct-SFT 데이터로 5–15 에포크(9–27B 토큰)만 학습한다. 이는 비슷한 규모의 확산 모델(Dream, LLaDA, Efficient-DLM)이 보고한 최대 500B 토큰 대비 최소 18배 적다(§3, Table training-hyperparameters). 벤치마크는 지시 따르기·추론·코딩을 아우르는 IFEval, BBH, MMLU-Pro, GPQA, GSM8K, HumanEval 여섯 가지다.
flow 학습이 자기회귀를 해치지 않는다
여섯 벤치마크 평균 단일 토큰 디코딩 정확도를 비교하면(Table ntp_main), Lafa는 모든 규모에서 같은 초기화·데이터·학습 예산으로 만든 AR SFT를 넘는다. 8B에서는 Efficient-DLM 63.5%에 근접하면서 학습 토큰은 최소 18배 적다. flow를 배우는 과정이 오히려 자기회귀 예측을 개선한 셈이다(Table 1, §3.2).
| 규모 | AR SFT | Lafa | 차이 |
|---|---|---|---|
| 0.5B | 28.7% | 31.6% | +2.9%p |
| 7B | 58.4% | 60.9% | +2.5%p |
| 8B | 56.8% | 63.1% | +6.3%p |
병렬성: TPF가 오르면 정확도는 어디까지 유지되는가
TPF(tokens per forward)는 한 번의 forward pass로 확정되는 토큰 수다. AR은 정의상 1이다. self-speculative의 출력은 탐욕적 자기회귀와 같으므로, TPF 비교는 같은 AR 품질 위에서의 병렬성 비교가 된다.
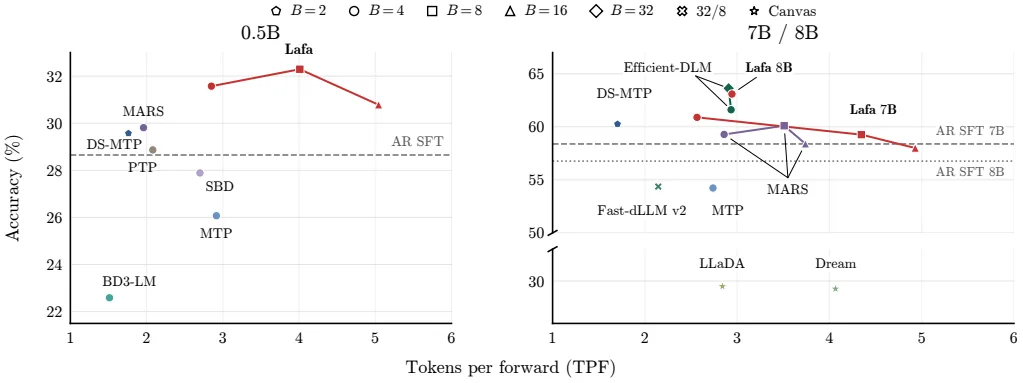
위 그림(원문 Figure selfspec_frontier)의 가로축은 TPF, 세로축은 여섯 벤치마크 평균 정확도다. 7B에서 블록 4는 TPF 2.6·정확도 60.9%로 DeepSeek-MTP를 정확도와 TPF 모두 넘고, 블록 16은 TPF 4.9에서 정확도 58.0%로 AR SFT 58.4%에 근접하면서 병렬성을 거의 두 배로 올린다. 전 규모에서 약 2.5–5 TPF 구간에서 AR 수준 정확도를 유지한다(Table selfspec_lafa_sixbench).
실제 시간: TPS로 측정한 처리량
TPF는 병렬성만 보여줄 뿐 실제 시간을 말해주지 않는다. forward pass 비용이 방법마다 다르기 때문에, H100 GPU 1장·배치 1에서 초당 토큰 수(TPS)를 측정했다.
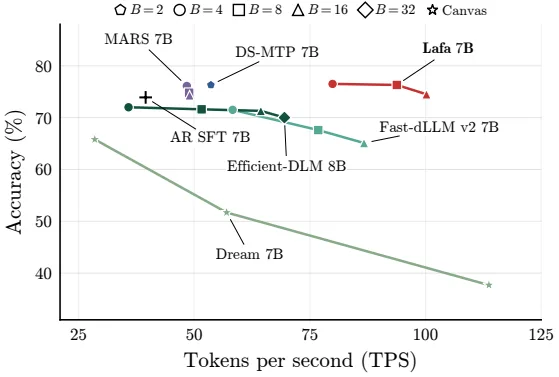
위 그림(원문 Figure throughput)의 가로축은 TPS, 세로축은 IFEval·GSM8K·HumanEval 평균 정확도다. Lafa 7B는 블록 16에서 100.2 TPS로 AR SFT의 39.5 TPS 대비 2.54배의 처리량을 비슷한 평균 정확도(74.5% vs 73.9%)에서 낸다. 블록 4에서는 79.9 TPS로 약 2배 빠르면서 평균 정확도(76.5%)가 더 높다. DeepSeek-MTP(53.6 TPS)와 MARS(48–49 TPS)는 AR보다 정확도가 같거나 높아도 최대 1.4배에 그친다. 확산 기반 방법(Fast-dLLM v2, Dream, Efficient-DLM)은 설정에 따라 더 높은 TPS를 내기도 하지만 평균 정확도가 AR SFT 아래이며, 빠른 설정일수록 정확도 손실이 크다(Table throughput_full, §3.3).
‘품질 유지’의 의미
self-speculative의 출력은 탐욕적 자기회귀와 같으므로, 2.54배는 같은 AR 품질을 유지한 채 얻는 속도 향상이다. flow 디코딩 자체는 다중 스텝이 필요하다. 7B·블록 4에서 32스텝 평균은 75.2%로 이미 AR SFT(73.9%)를 넘고, 64스텝에서는 75.9%에 이른다(Table flow_full, §3.1). 여러 스텝이 필요한 flow를 1스텝 초안 + 검증으로 바꾸는 것이 실질적인 가속의 원천이다. flow map 증류는 1–2스텝 구간의 정확도를 개선하며, 7B에서 2스텝 학생이 4스텝 교사에 근접한다.
한계와 적용 판단
이 논문이 스스로 남긴 한계는 주로 flow map 증류와 관련 있다. 증류된 1·2스텝 모델은 스텝 수를 줄이면서 정확도를 올리지만, 더 많은 스텝을 밟는 flow 디코딩과의 품질 격차가 남는다. 자기 조건화(self-conditioning)와 prefix guidance를 증류에 충분히 녹이는 것은 후속 과제로 남겨두었다(§3.1, §4). confidence 디코딩은 임계값을 낮추면 정확도가 떨어져 기본 방식으로 쓰지 못했다(Appendix confidence_results).
리뷰어 관점에서 주의할 점도 있다. 첫째, 2.54배는 7B·블록 16·H100 1장·배치 1 조건에서 측정한 것으로, 더 큰 모델이나 배치·긴 문맥에서 같은 배수가 나온다는 보장은 없다. 둘째, 평가가 지시·수학·코딩 벤치마크로 한정되어 있어 다른 영역 일반화는 원문에서 확인되지 않는다. 셋째, 8B는 Instruct 대신 Base에서 시작했다(논문은 Instruct 대응물의 추가 학습이 성능을 떨어뜨렸다고 보고한다). 이 때문에 8B 스케일의 IFEval 수치가 전반적으로 낮게 나온다(AR SFT도 38.1%).
이 조건을 감안하면, Lafa는 자기회귀 모델의 탐욕적 출력을 그대로 유지하면서 처리량을 높이고 싶은 서빙 환경에 적합하다. 이미 학습된 모델이 있고 토큰을 조금만 추가 학습할 수 있다면, 초안 모델을 따로 두지 않고도 speculative decoding의 이점을 얻을 수 있다. 반면 출력 분포 자체를 바꾸고 싶거나, 수 스텝의 flow 디코딩을 실시간으로 돌릴 수 있을 만큼 지연 여유가 큰 경우에는 이 방법의 강점이 덜 부각된다.
논문 원문의 표
arXiv e-print 의 LaTeX 원본에서 기계적으로 옮긴 표입니다. 숫자는 논문의 값이며 모델을 거치지 않았습니다.
표 1. Main hyperparameters. For block size four, we use batches of 384 sequences for training, whereas for larger blocks, we use memory-matched microbatches and, when applicable, continue training from smaller-block checkpoint.
| Setting | Lafa 0.5B | Lafa 7B | Lafa 8B |
|---|---|---|---|
| Model and data | |||
| Initialization | Qwen2.5 0.5B Instruct | Qwen2.5 7B Instruct | Qwen3 8B Base |
| Training data / epochs / tokens | Dolci-Instruct-SFT / 5 epochs / approximately 9B | ||
| Block sizes $B$ | 4, 8, 16 | 4, 8, 16 | 4 |
| Maximum sequence length | 512–1024 | 512–1024 | 512 |
| adaLN | Per-layer | Shared across layers | Shared across layers |
| Optimization | |||
| Optimizer | AdamW | ||
| Learning rate | $1{\times}10^{-4}$ | $1{\times}10^{-5}$ | $1{\times}10^{-5}$ |
| Schedule / warm-up | Constant / first 1% of steps | ||
| Adam $(\beta_1,\beta_2)$ | (0.9, 0.999) | ||
| Weight decay / gradient clipping / batch size | 0 / 1.0 / 384 sequences | ||
| Precision | bfloat16 | ||
| Distributed training | DDP | ZeRO-3 | ZeRO-3 |
| Training objective and architecture | |||
| Training noise scale $\sigma$ | 4.0 | ||
| Self-conditioning probability $p_\mathsf{sc}$ | 0.5 | ||
| adaLN learning rate multiplier | 5.0 | ||
| Parameter EMA decay | 0.999 (enabled from step 500) | ||
| Learned tokenwise time | |||
| Histogram bins $M$ | 200 | ||
| Histogram EMA decay $\beta$ | 0.99 | ||
| Update interval $S$ | 100 steps | ||
| Flow decoding | |||
| Inference noise scale $\sigma$ | 0.1 | ||
| prefix guidance scale $g$ | 8.0 |
표 2. Flow and flow map decoding accuracies.
| Method | $B$ | Euler steps | 0.5B scale GSM8K | 0.5B scale HumanEval | 0.5B scale IFEval | 0.5B scale Average | 7B scale GSM8K | 7B scale HumanEval | 7B scale IFEval | 7B scale Average |
|---|---|---|---|---|---|---|---|---|---|---|
| AR SFT | – | – | 32.0 | 35.4 | 48.4 | 38.6 | 69.1 | 78.7 | 73.8 | 73.9 |
| Flow decoding | ||||||||||
| Lafa (Ours) | 16 | 1 | 0.8 | 3.0 | 20.3 | 8.1 | 2.4 | 10.4 | 29.8 | 14.2 |
| 2 | 1.7 | 6.1 | 23.5 | 10.4 | 18.7 | 21.3 | 36.2 | 25.4 | ||
| 4 | 11.7 | 12.2 | 27.0 | 17.0 | 47.5 | 40.2 | 44.7 | 44.1 | ||
| 8 | 18.3 | 14.0 | 30.9 | 21.1 | 60.2 | 54.9 | 56.9 | 57.3 | ||
| 16 | 24.8 | 17.1 | 37.2 | 26.3 | 65.6 | 65.2 | 64.9 | 65.2 | ||
| 32 | 25.9 | 21.3 | 39.9 | 29.1 | 66.9 | 68.3 | 64.1 | 66.5 | ||
| 64 | 28.1 | 21.3 | 42.3 | 30.6 | 67.5 | 66.5 | 66.5 | 66.8 | ||
| 128 | 28.1 | 20.7 | 44.2 | 31.0 | 68.7 | 67.7 | 65.2 | 67.2 | ||
| 8 | 1 | 2.4 | 6.1 | 23.3 | 10.6 | 20.1 | 22.0 | 34.8 | 25.6 | |
| 2 | 9.2 | 12.2 | 23.5 | 15.0 | 47.4 | 41.5 | 42.1 | 43.7 | ||
| 4 | 17.4 | 18.9 | 29.0 | 21.8 | 64.0 | 57.9 | 55.8 | 59.2 | ||
| 8 | 24.8 | 25.6 | 38.4 | 29.6 | 64.8 | 64.0 | 64.5 | 64.5 | ||
| 16 | 28.4 | 28.0 | 46.4 | 34.3 | 71.6 | 70.7 | 64.5 | 68.9 | ||
| 32 | 29.1 | 28.0 | 45.5 | 34.2 | 72.3 | 72.0 | 71.0 | 71.7 | ||
| 64 | 28.4 | 28.0 | 47.1 | 34.5 | 71.7 | 72.6 | 68.8 | 71.0 | ||
| 128 | 28.7 | 28.7 | 49.0 | 35.5 | 71.0 | 72.6 | 69.3 | 70.9 | ||
| 1 | 16.4 | 13.4 | 32.5 | 20.8 | 53.9 | 32.3 | 44.7 | 43.7 | ||
| 2 | 14.7 | 9.1 | 35.1 | 19.7 | 60.0 | 34.8 | 43.8 | 46.2 | ||
| 4 | 25.0 | 21.3 | 43.6 | 30.0 | 69.5 | 63.4 | 60.1 | 64.3 | ||
| 8 | 27.0 | 22.0 | 46.6 | 31.8 | 73.0 | 71.3 | 69.3 | 71.2 | ||
| 16 | 28.8 | 27.4 | 50.1 | 35.4 | 71.9 | 75.0 | 69.5 | 72.1 | ||
| 32 | 30.4 | 31.1 | 52.9 | 38.1 | 73.8 | 78.7 | 73.0 | 75.2 | ||
| 64 | 29.6 | 32.9 | 53.0 | 38.5 | 74.6 | 78.7 | 74.3 | 75.9 | ||
| -8*4 | 128 | 30.1 | 31.7 | 49.4 | 37.1 | 75.6 | 78.0 | 73.6 | 75.7 | |
| Flow map decoding | ||||||||||
| 1 | 19.2 | 17.1 | 33.6 | 23.3 | 54.2 | 50.0 | 42.7 | 49.0 | ||
| 2 | 21.1 | 18.3 | 36.2 | 25.2 | 66.4 | 68.3 | 55.1 | 63.3 | ||
| 4 | 24.9 | 21.3 | 39.4 | 28.5 | 69.7 | 73.8 | 64.7 | 69.4 | ||
| 8 | 28.1 | 26.8 | 40.3 | 31.8 | 70.9 | 73.8 | 68.2 | 71.0 | ||
| -5*Lafa (Ours) | -5*4 | 16 | 28.9 | 25.6 | 43.3 | 32.6 | – | – | – | – |
표 3. Single-token decoding. For diffusion models, we decode exactly one highest-probability token per forward. Models marked $^\dagger$ are trained by us from the matched AR model on Dolci-Instruct-SFT for five epochs.
| Method | IFEval | BBH | MMLU-Pro | GPQA | GSM8K | HumanEval | Average |
|---|---|---|---|---|---|---|---|
| 0.5B scale | |||||||
| Qwen2.5 SFT$^\dagger$ | 48.4 | 26.3 | 11.9 | 17.9 | 32.0 | 35.4 | 28.7 |
| MTP$^\dagger$ | 50.6 | 17.3 | 9.2 | 18.8 | 27.1 | 32.3 | 25.9 |
| DeepSeek-MTP$^\dagger$ | 53.2 | 24.1 | 14.0 | 18.5 | 35.5 | 36.0 | 30.2 |
| MARS$^\dagger$ | 51.3 | 26.6 | 12.4 | 19.4 | 32.8 | 40.2 | 30.4 |
| SBD$^\dagger$ | 55.3 | 20.6 | 9.2 | 22.5 | 27.2 | 30.8 | 27.6 |
| BD3LM$^\dagger$ | 47.1 | 7.5 | 2.0 | 17.9 | 30.6 | 31.7 | 22.8 |
| Lafa 0.5B (Ours)$^\dagger$ | 55.1 | 27.6 | 12.1 | 21.9 | 36.1 | 36.6 | 31.6 |
| 7B scale | |||||||
| Qwen2.5 SFT$^\dagger$ | 73.8 | 59.2 | 41.6 | 27.9 | 69.1 | 78.7 | 58.4 |
| MTP$^\dagger$ | 73.2 | 51.7 | 37.3 | 26.8 | 60.5 | 73.8 | 53.9 |
| DeepSeek-MTP$^\dagger$ | 78.0 | 60.7 | 40.6 | 30.1 | 70.3 | 80.5 | 60.0 |
| MARS$^\dagger$ | 77.8 | 54.6 | 44.4 | 26.6 | 73.2 | 81.7 | 59.7 |
| Fast-dLLM v2$^\dagger$ | 70.6 | 53.5 | 43.1 | 28.6 | 67.2 | 32.9 | 49.3 |
| Fast-dLLM v2 | 64.5 | 58.1 | 39.7 | 21.4 | 80.3 | 62.2 | 54.4 |
| Dream | 57.1 | 66.0 | 43.6 | 26.6 | 81.7 | 58.5 | 55.6 |
| Lafa (Ours)$^\dagger$ | 78.9 | 63.0 | 41.8 | 31.0 | 73.8 | 76.8 | 60.9 |
| 8B scale | |||||||
| Qwen3 SFT$^\dagger$ | 38.1 | 71.6 | 56.2 | 29.5 | 62.9 | 82.3 | 56.8 |
| LLaDA | 58.0 | 30.9 | 28.7 | 25.4 | 76.0 | 42.1 | 43.5 |
| Efficient-DLM | 58.4 | 70.8 | 61.5 | 33.7 | 87.4 | 68.9 | 63.5 |
| Lafa (Ours)$^\dagger$ | 62.3 | 70.7 | 56.2 | 31.7 | 77.8 | 79.9 | 63.1 |
표 4. Self-speculative and parallel decoding accuracy (%) and TPF across model scales.
| Method | $B$ | IFEval Acc. | IFEval TPF | BBH Acc. | BBH TPF | MMLU-Pro Acc. | MMLU-Pro TPF | GPQA Acc. | GPQA TPF | GSM8K Acc. | GSM8K TPF | HumanEval Acc. | HumanEval TPF | Average Acc. | Average TPF |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0.5B scale | |||||||||||||||
| AR SFT | – | 48.4 | 1.0 | 26.3 | 1.0 | 11.9 | 1.0 | 17.9 | 1.0 | 32.0 | 1.0 | 35.4 | 1.0 | 28.7 | 1.0 |
| MARS | 4 | 51.0 | 1.8 | 31.7 | 2.3 | 13.9 | 1.7 | 18.3 | 2.0 | 31.7 | 2.1 | 32.3 | 1.9 | 29.8 | 2.0 |
| MTP | 4 | 51.2 | 2.5 | 17.6 | 3.3 | 9.4 | 3.1 | 17.9 | 2.8 | 26.8 | 2.9 | 33.5 | 2.9 | 26.1 | 2.9 |
| DeepSeek-MTP | 2 | 51.9 | 1.6 | 23.7 | 1.8 | 12.1 | 1.9 | 18.8 | 1.9 | 35.5 | 1.8 | 35.4 | 1.7 | 29.6 | 1.8 |
| BD3LM | 4 | 46.8 | 1.5 | 8.3 | 1.6 | 1.3 | 1.5 | 19.4 | 1.5 | 29.8 | 1.5 | 29.9 | 1.5 | 22.6 | 1.5 |
| SBD | 4 | 56.4 | 2.2 | 20.6 | 3.2 | 9.4 | 2.7 | 23.2 | 2.7 | 26.7 | 2.7 | 31.1 | 2.8 | 27.9 | 2.7 |
| PTP | 4 | 42.3 | 1.7 | 26.0 | 2.5 | 11.9 | 2.0 | 15.0 | 1.9 | 35.3 | 2.3 | 42.7 | 2.1 | 28.9 | 2.1 |
| 4 | 55.1 | 2.2 | 27.6 | 3.3 | 12.1 | 3.1 | 21.9 | 2.9 | 36.1 | 2.7 | 36.6 | 2.9 | 31.6 | 2.9 | |
| 8 | 55.3 | 2.7 | 27.9 | 5.1 | 10.0 | 5.5 | 23.7 | 4.2 | 37.8 | 3.6 | 39.0 | 3.0 | 32.3 | 4.0 | |
| -3*Lafa (Ours) | 16 | 54.2 | 3.1 | 27.0 | 6.3 | 9.1 | 9.2 | 18.1 | 4.8 | 36.7 | 3.6 | 39.6 | 3.3 | 30.8 | 5.0 |
| 7B scale | |||||||||||||||
| AR SFT | – | 73.8 | 1.0 | 59.2 | 1.0 | 41.6 | 1.0 | 27.9 | 1.0 | 69.1 | 1.0 | 78.7 | 1.0 | 58.4 | 1.0 |
| MTP | 4 | 73.2 | 1.9 | 51.9 | 3.3 | 38.3 | 2.5 | 27.7 | 2.6 | 60.5 | 3.0 | 73.8 | 3.1 | 54.2 | 2.7 |
| DeepSeek-MTP | 2 | 78.0 | 1.5 | 60.8 | 1.8 | 42.5 | 1.6 | 29.5 | 1.7 | 70.3 | 1.7 | 80.5 | 1.9 | 60.3 | 1.7 |
| Fast-dLLM v2 | 32/8 | 62.8 | 1.9 | 58.1 | 2.3 | 39.2 | 2.2 | 22.3 | 2.2 | 80.4 | 2.5 | 63.4 | 1.8 | 54.4 | 2.1 |
| Dream | Canvas | 18.9 | 4.2 | 42.5 | 4.2 | 42.2 | 4.4 | 9.8 | 4.4 | 38.4 | 3.5 | 23.8 | 3.8 | 29.3 | 4.1 |
| 4 | 77.8 | 1.9 | 52.9 | 4.1 | 40.0 | 2.8 | 29.2 | 2.8 | 74.0 | 2.8 | 81.7 | 2.9 | 59.3 | 2.9 | |
| MARS | 8 | 76.3 | 2.0 | 59.6 | 5.7 | 41.5 | 3.3 | 30.8 | 3.2 | 71.3 | 3.5 | 81.1 | 3.5 | 60.1 | 3.5 |
| 16 | 75.8 | 2.0 | 55.8 | 6.3 | 39.2 | 3.6 | 26.8 | 3.2 | 75.4 | 3.7 | 77.4 | 3.7 | 58.4 | 3.7 | |
| 4 | 78.9 | 1.7 | 63.0 | 3.4 | 41.8 | 2.4 | 31.0 | 2.3 | 73.8 | 2.8 | 76.8 | 2.8 | 60.9 | 2.6 | |
| 8 | 77.5 | 2.8 | 59.1 | 6.3 | 39.4 | 3.7 | 28.1 | 4.0 | 75.3 | 4.8 | 76.2 | 4.6 | 59.3 | 4.3 | |
| -3*Lafa (Ours) | 16 | 74.9 | 2.8 | 57.3 | 7.9 | 39.0 | 3.8 | 28.1 | 4.0 | 75.0 | 5.8 | 73.8 | 5.4 | 58.0 | 4.9 |
| 8B scale | |||||||||||||||
| AR SFT | – | 38.1 | 1.0 | 71.6 | 1.0 | 56.2 | 1.0 | 29.5 | 1.0 | 62.9 | 1.0 | 82.3 | 1.0 | 56.8 | 1.0 |
| LLaDA | Canvas | 36.8 | 3.2 | 31.0 | 3.2 | 28.8 | 2.7 | 9.4 | 2.7 | 47.2 | 2.7 | 23.8 | 2.5 | 29.5 | 2.8 |
| 4 | 57.1 | 2.6 | 66.9 | 3.2 | 60.7 | 3.0 | 33.0 | 2.8 | 85.4 | 2.9 | 66.5 | 3.0 | 61.6 | 2.9 | |
| -2*Efficient-DLM | 32 | 58.8 | 2.4 | 70.7 | 3.3 | 61.6 | 3.1 | 34.4 | 2.9 | 87.4 | 2.9 | 68.9 | 3.0 | 63.6 | 2.9 |
| Lafa (Ours) | 4 | 62.3 | 2.4 | 70.7 | 3.4 | 56.2 | 3.2 | 31.7 | 3.1 | 77.8 | 2.6 | 79.9 | 2.9 | 63.1 | 2.9 |
표 5. Per-task accuracy (%) and throughput in tokens per second (TPS) at 7–8B scales, measured using one H100 GPU with batch size one. Efficient-DLM is 8B and other methods are 7B.
| Method | Setting | Threshold | IFEval Accuracy | IFEval TPS | GSM8K Accuracy | GSM8K TPS | HumanEval Accuracy | HumanEval TPS | Average Accuracy | Average TPS |
|---|---|---|---|---|---|---|---|---|---|---|
| AR SFT | – | – | 73.8 | 40.9 | 69.1 | 40.6 | 78.7 | 37.0 | 73.9 | 39.5 |
| DeepSeek-MTP | $B=2$ | – | 78.0 | 45.1 | 70.3 | 57.2 | 80.5 | 58.4 | 76.3 | 53.6 |
| MARS | $B=4$ | 0.95 | 77.6 | 42.0 | 70.7 | 59.8 | 79.9 | 43.3 | 76.1 | 48.4 |
| $B=8$ | 0.95 | 77.3 | 40.9 | 69.1 | 62.7 | 78.0 | 43.1 | 74.8 | 48.9 | |
| $B=16$ | 0.95 | 75.0 | 41.1 | 72.9 | 61.3 | 75.0 | 44.6 | 74.3 | 49.0 | |
| Fast-dLLM v2 | $B=4$ | 0.90 | 65.8 | 52.1 | 81.6 | 66.2 | 67.1 | 56.5 | 71.5 | 58.3 |
| $B=8$ | 0.90 | 65.4 | 60.9 | 80.1 | 98.5 | 57.3 | 71.1 | 67.6 | 76.8 | |
| $B=16$ | 0.90 | 61.9 | 65.1 | 77.3 | 116.0 | 56.1 | 78.9 | 65.1 | 86.7 | |
| Efficient-DLM | $B=4$ | 0.70 | 58.2 | 31.8 | 87.8 | 37.1 | 70.1 | 38.4 | 72.0 | 35.8 |
| $B=8$ | 0.70 | 58.2 | 40.7 | 87.7 | 55.6 | 68.9 | 58.5 | 71.6 | 51.6 | |
| $B=16$ | 0.70 | 58.4 | 47.2 | 88.4 | 70.5 | 67.1 | 75.4 | 71.3 | 64.4 | |
| $B=32$ | 0.70 | 59.1 | 49.3 | 87.5 | 74.4 | 63.4 | 84.8 | 70.0 | 69.5 | |
| $B=32$ | 0.60 | 58.6 | 56.1 | 82.2 | 87.1 | 55.5 | 96.3 | 65.4 | 79.9 | |
| $B=32$ | 0.50 | 52.9 | 71.9 | 72.0 | 102.9 | 42.1 | 111.2 | 55.7 | 95.3 | |
| Dream | $k=1$ | – | 57.1 | 22.7 | 81.7 | 36.0 | 58.5 | 26.7 | 65.8 | 28.5 |
| $k=2$ | – | 44.7 | 45.6 | 75.0 | 72.0 | 35.4 | 53.3 | 51.7 | 57.0 | |
| $k=4$ | – | 33.8 | 91.2 | 59.3 | 143.5 | 20.1 | 106.3 | 37.7 | 113.7 | |
| $B=4$ | – | 78.9 | 60.9 | 73.8 | 91.7 | 76.8 | 87.2 | 76.5 | 79.9 | |
| $B=8$ | – | 77.5 | 61.1 | 75.3 | 116.1 | 76.2 | 104.3 | 76.3 | 93.8 | |
| -3*Lafa (Ours) | $B=16$ | – | 74.9 | 59.7 | 75.0 | 125.2 | 73.8 | 115.7 | 74.5 | 100.2 |
표 6. Self-speculative decoding accuracy (%) $\uparrow$ and TPF $\uparrow$.
| Method | $B$ | IFEval Acc. | IFEval TPF | BBH Acc. | BBH TPF | MMLU-Pro Acc. | MMLU-Pro TPF | GPQA Acc. | GPQA TPF | GSM8K Acc. | GSM8K TPF | HumanEval Acc. | HumanEval TPF | Average Acc. | Average TPF |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0.5B scale | |||||||||||||||
| Qwen2.5 SFT | – | 48.4 | 1.0 | 26.3 | 1.0 | 11.9 | 1.0 | 17.9 | 1.0 | 32.0 | 1.0 | 35.4 | 1.0 | 28.7 | 1.0 |
| 4 | 55.1 | 2.2 | 27.6 | 3.3 | 12.1 | 3.1 | 21.9 | 2.9 | 36.1 | 2.7 | 36.6 | 2.9 | 31.6 | 2.9 | |
| 8 | 55.3 | 2.7 | 27.9 | 5.1 | 10.0 | 5.5 | 23.7 | 4.2 | 37.8 | 3.6 | 39.0 | 3.0 | 32.3 | 4.0 | |
| -3*Lafa (Ours) | 16 | 54.2 | 3.1 | 27.0 | 6.3 | 9.1 | 9.2 | 18.1 | 4.8 | 36.7 | 3.6 | 39.6 | 3.3 | 30.8 | 5.0 |
| 7B scale | |||||||||||||||
| Qwen2.5 SFT | – | 73.8 | 1.0 | 59.2 | 1.0 | 41.6 | 1.0 | 27.9 | 1.0 | 69.1 | 1.0 | 78.7 | 1.0 | 58.4 | 1.0 |
| 4 | 78.9 | 1.7 | 63.0 | 3.4 | 41.8 | 2.4 | 31.0 | 2.3 | 73.8 | 2.8 | 76.8 | 2.8 | 60.9 | 2.6 | |
| 8 | 77.5 | 2.8 | 59.1 | 6.3 | 39.4 | 3.7 | 28.1 | 4.0 | 75.3 | 4.8 | 76.2 | 4.6 | 59.3 | 4.3 | |
| -3*Lafa (Ours) | 16 | 74.9 | 2.8 | 57.3 | 7.9 | 39.0 | 3.8 | 28.1 | 4.0 | 75.0 | 5.8 | 73.8 | 5.4 | 58.0 | 4.9 |
| 8B scale | |||||||||||||||
| Qwen3 SFT | – | 38.1 | 1.0 | 71.6 | 1.0 | 56.2 | 1.0 | 29.5 | 1.0 | 62.9 | 1.0 | 82.3 | 1.0 | 56.8 | 1.0 |
| Lafa (Ours) | 4 | 62.3 | 2.4 | 70.7 | 3.4 | 56.2 | 3.2 | 31.7 | 3.1 | 77.8 | 2.6 | 79.9 | 2.9 | 63.1 | 2.9 |
이 글의 그림은 arXiv:2610.28559 원본에서 가져왔습니다 (CC BY 4.0). 크기와 형식만 바꿨습니다.
댓글