코딩 에이전트가 파일을 읽고 도구를 호출할수록, 모델에 다시 넣어야 할 대화와 실행 기록은 길어진다. 답변을 빨리 만들기 위해 작은 모델을 붙여도, 그 작은 모델까지 긴 기록을 따로 처리하고 보관한다면 새로운 부담이 생긴다.
DLite는 긴 기록은 본체 모델이 처리하고, 작은 모델은 본체가 만든 내부 표현을 받아 다음 후보만 만들게 한다. 없애는 것은 작은 모델이 따로 유지하던 과거 기록용 KV 캐시다. 본체 모델의 캐시나 과거 정보 자체를 없애는 방법은 아니다.
작은 모델을 붙이면 왜 빨라질까
언어 모델은 보통 다음 토큰을 하나씩 생성한다. 여기서 토큰은 모델이 문장을 처리하는 단위로, 단어나 단어의 일부일 수 있다. 큰 모델을 토큰마다 실행하는 대신, 작은 모델이 후보 여러 개를 먼저 내고 큰 모델이 한 번에 검사하면 실행 횟수를 줄일 수 있다. 이것이 **추측 디코딩(speculative decoding)**의 기본 생각이다(§2.1).
두 모델의 역할을 나누면 이해하기 쉽다. **초안 모델(drafter)**은 빠르게 후보를 제안하고, **본체 모델(target)**은 후보를 검증해 실제 출력으로 이어간다. 후보가 많이 받아들여지고 후보를 만드는 비용이 작을수록 유리하다. 후보를 만드는 작은 모델이 느리거나 자주 틀리면, 붙여 둔 이점이 줄어든다.
에이전트에서는 도구 실행 결과와 이전 대화가 계속 쌓인다. 기존 초안 모델도 이 기록을 자기 방식으로 처리하며, 다음 생성에 재사용할 내부 데이터를 KV 캐시에 저장한다. KV 캐시는 이미 처리한 토큰을 매번 처음부터 계산하지 않도록 보관하는 데이터다. 본체와 초안 모델이 각자 캐시를 유지하면, 새 토큰이 확정될 때 초안 쪽 기록도 갱신해야 한다(§3.1).
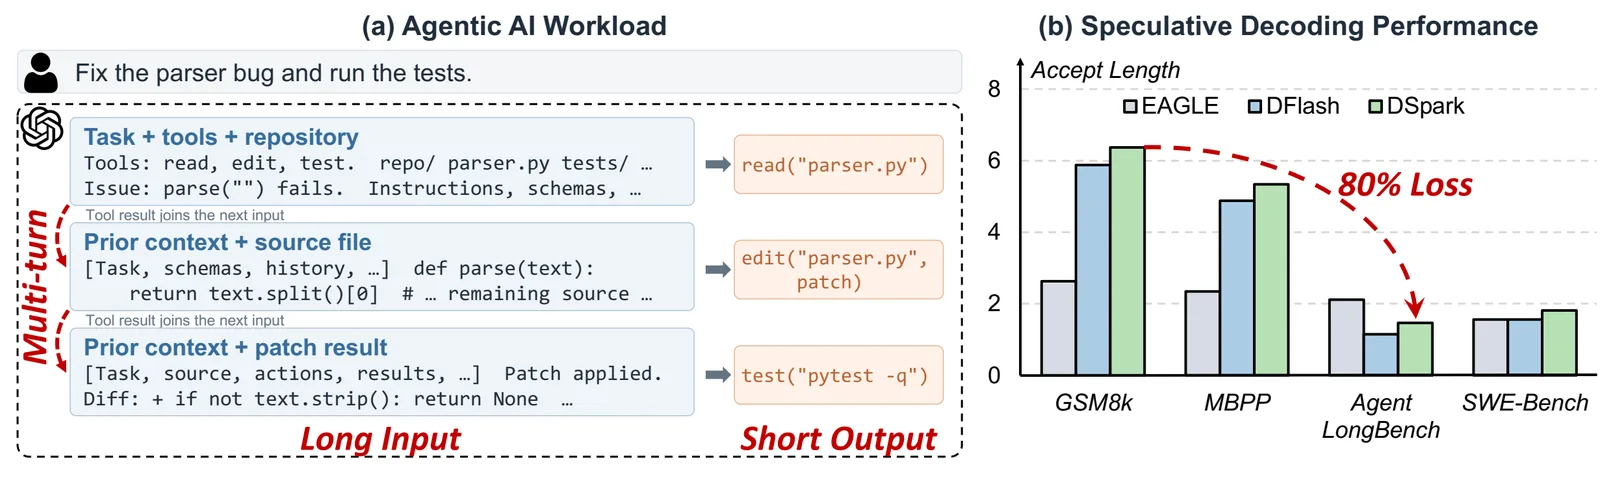
원문 Figure 1의 왼쪽은 긴 입력과 짧은 출력이 반복되는 에이전트 실행을, 오른쪽은 이런 작업에서 한 번에 받아들여지는 토큰 수가 줄어드는 상황을 보여준다. 이 그림에서 볼 점은 “작은 모델이 있다”는 사실보다 긴 기록을 처리하는 작은 모델이 좋은 후보를 계속 낼 수 있는가다.
전체 파이프라인: 무엇을 남기고 무엇을 없애나
DLite에서는 본체가 긴 기록을 처리한 뒤 만든 **내부 표현(hidden state)**을 초안 모델에 건넨다. 내부 표현은 사람이 읽는 요약문이 아니라 신경망의 중간 계산값이다. 초안 모델은 이 값과 직전에 확정된 토큰을 받아 새 후보를 만든다(§4.1).
아래는 후보가 검사되는 흐름을 보여주는 설명용 예시다. 영어 단어를 눈에 보이는 단위로 사용했으며 실제 토크나이저의 분할이나 논문 측정값을 뜻하지 않는다.
첫 패널에서 긴 기록과 본체의 캐시는 그대로 남아 있다. 초안 모델이 받는 것은 본체의 내부 표현과 현재 위치의 정보다. 따라서 “history-free”는 기록을 잊는다는 뜻이 아니라, 초안 모델이 긴 기록용 캐시를 따로 유지하지 않는다는 뜻이다.
둘째 패널에서 초안은 jumps over a dog를 제안한다. 셋째 패널은 검증 결과를 jumps, over는 통과하고 a에서 거절되는 경우로 가정했다. 이 경우 dog도 확정하지 않고, 검증 절차에 따른 토큰 the로 이어간다. 이는 정답 문자열과 단순 비교한다는 뜻이 아니라, 후보의 통과·거절 이후 어떤 부분이 남는지 보여주는 예시다.
실제 한 라운드의 흐름은 다음과 같다.
| 단계 | 실제로 하는 일 | 다음에 쓰는 결과 |
|---|---|---|
| 본체 계산 | 지금까지의 입력을 처리 | 본체 캐시와 내부 표현 |
| 후보 준비 | 여러 후보 위치의 중간 표현을 한 번에 계산 | 위치별 표현 |
| 후보 생성 | 앞서 뽑은 후보를 반영하며 다음 후보를 선택 | 후보 토큰 묶음 |
| 본체 검증 | 후보들을 검사하고 통과한 앞부분을 확정 | 확정 출력과 다음 라운드 정보 |
표에서 초안 모델은 긴 기록을 다시 저장하지 않지만, 본체 계산과 검증은 남는다. DLite가 줄이는 작업의 범위를 이 둘과 혼동하면 안 된다(§4.1, Figure 3).
후보는 함께 준비하되, 선택할 때는 앞 단어를 본다
다음 몇 개의 위치를 동시에 계산하면 빠르다. 하지만 각 위치의 단어까지 서로 독립적으로 뽑으면 문장이 잘 이어지지 않을 수 있다. 예를 들어 jumps 다음 단어를 고를 때는 앞에서 실제로 jumps를 골랐다는 정보가 필요하다.
DLite는 이 일을 둘로 나눈다. 먼저 병렬 백본이 여러 위치의 중간 표현을 함께 계산한다. 그다음 작은 순차 헤드가 앞서 선택한 후보를 반영해 다음 후보를 고른다. 큰 계산은 함께 하고, 앞 후보와의 연결을 반영하는 작은 계산만 순서대로 한다는 설계다(§4.1.1–4.1.2).
여기서 순차 헤드가 다루는 것은 현재 후보 묶음 안의 정보다. 전체 대화와 파일 내용을 다시 읽는 것은 아니다. 또한 중간 표현을 어휘 전체의 점수로 바꾼 뒤 다시 다듬는 대신, 중간 표현에서 순서를 반영하고 나서 어휘 점수를 계산한다. 큰 어휘 변환을 중간 단계에서 반복하는 비용을 줄이려는 선택이다.
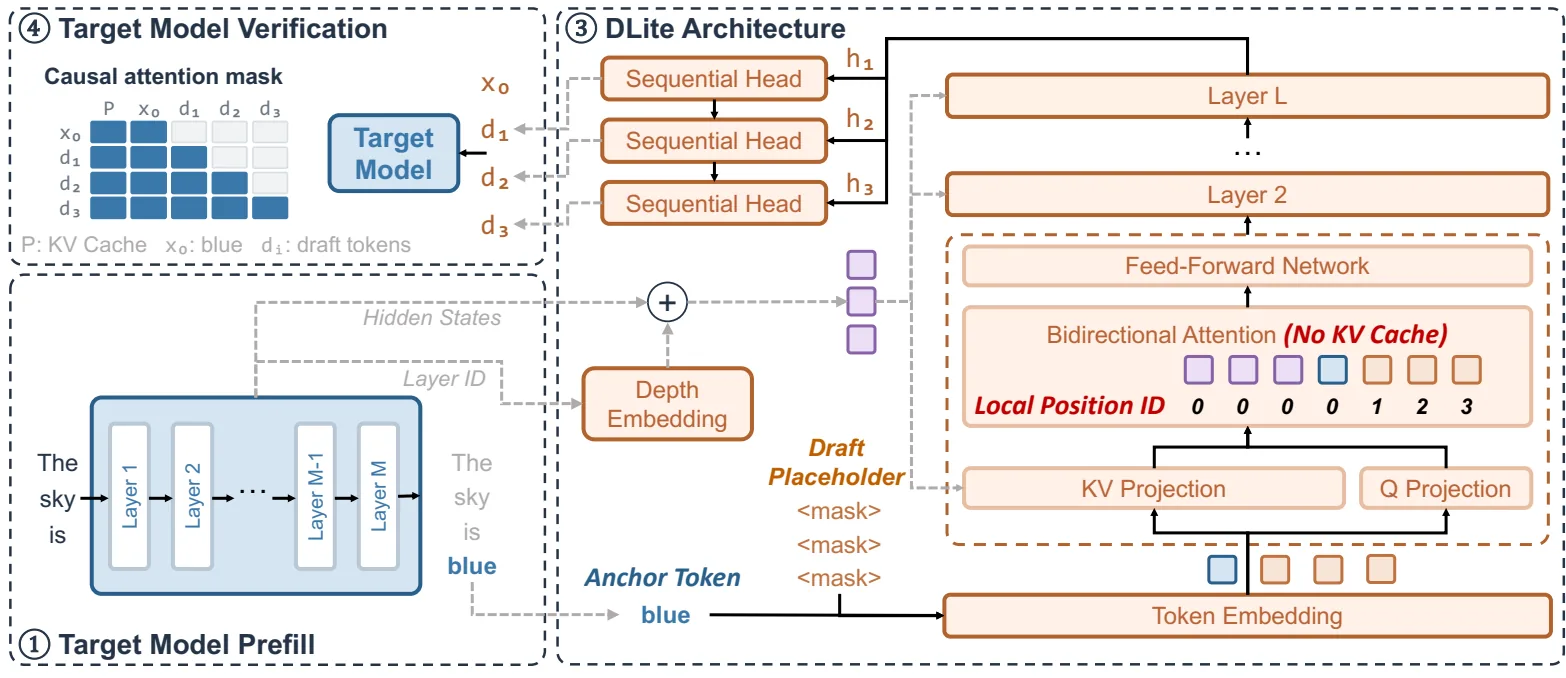
원문 Figure 3은 위 설명을 실제 모델 구성에 연결한다. 본체에서 나온 표현이 초안 쪽으로 전달되는 경로와, 병렬 계산 뒤에 순차 헤드가 놓이는 순서를 보면 된다. 독자가 만든 예시 그림은 후보의 변화를, 이 원문 그림은 구현 구성요소 사이의 연결을 설명한다.
이 구조는 학습에도 준비가 필요하다. 저자들은 DLite와 비슷한 구조이면서 과거 캐시에 접근할 수 있는 중간 교사 모델로 먼저 학습시킨 뒤, 본체 모델을 직접 따라가도록 학습한다. 추론 시 캐시를 없애는 대신 학습 절차가 추가되는 셈이다(§4.2).
결과: 후보 수와 실제 속도를 따로 읽어야 한다
실험은 Qwen3-4B와 Qwen3-8B를 본체로 사용했고, 서빙 하드웨어는 NVIDIA H800이다. 후보 블록 크기는 7이다. 결과의 두 지표를 구분해야 한다. 수용 길이는 검증 한 번으로 얼마나 생성하는지를, 속도 배수는 일반적인 한 토큰씩 생성하는 방식보다 얼마나 빨라졌는지를 나타낸다(§5.1).
아래는 SWE-Bench의 결과다. DSpark는 비교 대상인 다른 초안 모델 방식이다(원문 Table 3).
| 본체 | 방식 | 평균 수용 길이 | 일반 생성 대비 속도 |
|---|---|---|---|
| Qwen3-4B | DSpark | 1.89 | 1.64배 |
| Qwen3-4B | DLite | 3.15 | 2.68배 |
| Qwen3-8B | DSpark | 1.94 | 1.60배 |
| Qwen3-8B | DLite | 3.19 | 2.74배 |
4B에서 1.89→3.15는 수용 길이가 약 66.7% 늘어난 것이다. 반면 2.68배는 DSpark 대비가 아니라 일반 생성 대비 속도다. DSpark와 직접 속도를 비교하려면 2.68을 1.64로 나눠 약 1.63배로 읽어야 한다. “후보를 더 받아들인다”와 “서비스가 빨라진다”는 연결되지만 같은 숫자는 아니다.
짧은 범용 과제에서는 차이가 작다. 예를 들어 4B의 GSM8K 수용 길이는 DSpark 6.27, DLite 6.38이다(Table 1). 따라서 어느 작업에서나 큰 폭으로 개선된다고 읽기보다, 기록이 길어지는 작업에서 이 설계가 얼마나 유리한지를 봐야 한다.
동시에 여러 요청을 처리할 때도 배수가 그대로 유지되는 것은 아니다. 4B Alpaca에서 DLite의 일반 생성 대비 처리량 배수는 동시 요청 1개에서 2.58배, 64개에서 1.32배였다. 실제 요청 수와 입력 길이에 맞춘 검증이 필요하다(Table 4).
적용 전에 확인할 한계
먼저 본체 모델의 내부 표현을 꺼내 초안에 전달할 수 있어야 한다. 따라서 이 방식을 검토할 때는 모델 이름뿐 아니라 서빙 엔진에서 그 경로를 구현할 수 있는지도 확인해야 한다. 본체 KV 캐시는 계속 필요하므로 긴 입력 전체의 메모리 문제가 사라지는 것은 아니다.
학습 비용도 남는다. 앞서 설명한 중간 교사와 두 단계 학습은 저자가 도입한 절차다. 이미 학습된 작은 모델을 연결하기만 하면 같은 결과를 얻는다는 뜻으로 읽으면 안 된다(§4.2).
리뷰어 관점에서 남는 질문은 적용 범위다. 제시된 본체는 4B·8B Qwen3이고 서빙 실험은 H800 환경이다. 더 큰 본체나 다른 구조의 모델, 본체와 초안을 서로 다른 장치에 두는 배치에서도 같은 이득이 나는지는 별도 확인이 필요하다. 표의 수용 길이와 속도는 작업 성공률 자체를 측정한 수치도 아니다.
DLite를 검토할 만한 상황은 긴 기록을 자주 다시 사용하는 에이전트 서빙이다. 중요한 질문은 “캐시가 0인가”보다 누가 긴 기록을 처리하고, 그 결과를 누가 재사용하는가다. 본체의 기록 처리는 유지하면서 초안의 중복 저장과 갱신을 줄이는 것이 이 설계의 초점이다.
논문 원문의 표 펼쳐 보기
arXiv e-print 의 LaTeX 원본에서 기계적으로 옮긴 표입니다. 숫자는 논문의 값이며 모델을 거치지 않았습니다.
표 1. Acceptance length $\tau$ evaluation on general-purpose workloads.
| Model | Method | Math GSM8K | Math MATH-500 | Code HumanEval | Code \ MBPP | Code *\ \ \ LCB \ * | Chat MT-Bench | Chat Alpaca |
|---|---|---|---|---|---|---|---|---|
| Qwen3-4B | EAGLE3 | 2.63 | 2.39 | 2.47 | 2.34 | 2.17 | 3.07 | 2.28 |
| DFlow | 5.13 | 4.92 | 4.33 | 4.12 | - | 3.80 | 2.90 | |
| DFlash | 5.97 | 5.82 | 5.25 | 4.97 | 4.82 | 3.39 | 3.56 | |
| DFlash2 | 6.14 | 5.80 | 5.38 | 5.14 | 4.79 | 4.14 | 2.50 | |
| DSpark | 6.27 | 6.25 | 5.62 | 5.48 | 5.20 | 3.81 | 3.54 | |
| DLite | 6.38 | 6.30 | 5.68 | 5.64 | 5.31 | 3.94 | 3.64 | |
| Qwen3-8B | EAGLE3 | 2.60 | 2.28 | 2.51 | 2.17 | 2.08 | 3.07 | 2.56 |
| DFlow | 5.10 | 4.94 | 4.28 | 4.08 | - | 3.58 | 2.93 | |
| DFlash | 6.04 | 5.91 | 5.27 | 4.88 | 4.89 | 3.39 | 3.56 | |
| DSpark | 6.36 | 6.34 | 5.86 | 5.36 | 5.43 | 3.88 | 3.64 | |
| DLite | 6.48 | 6.35 | 5.96 | 5.65 | 5.66 | 3.96 | 3.78 |
표 2. Speedup and acceptance length ($\tau$) evaluation on long-context workloads.
| Model | Method | LongBench_v2 | |||||||
|---|---|---|---|---|---|---|---|---|---|
| Multi-Doc QA | Long In-ctx Lrn. | Code Repo Ud. | Long-dialog Hist. | ||||||
| Speedup | $\tau$ | Speedup | $\tau$ | Speedup | $\tau$ | Speedup | $\tau$ | ||
| Qwen3-4B | Eagle3 | 1.70$\times$ | 2.10 | 1.76$\times$ | 2.28 | 1.68$\times$ | 2.12 | 2.23$\times$ | 2.88 |
| DFlash | 1.60$\times$ | 1.90 | 1.71$\times$ | 2.00 | 1.45$\times$ | 1.83 | 2.62$\times$ | 3.04 | |
| DSpark | 1.81$\times$ | 2.20 | 2.01$\times$ | 2.41 | 2.02$\times$ | 2.44 | 3.16$\times$ | 3.93 | |
| DLite | 2.18$\times$ | 2.74 | 2.58$\times$ | 3.11 | 2.66$\times$ | 3.14 | 3.88$\times$ | 4.62 | |
| Qwen3-8B | Eagle3 | 1.64$\times$ | 2.05 | 1.87$\times$ | 2.33 | 1.42$\times$ | 1.80 | 2.01$\times$ | 2.56 |
| DFlash | 1.81$\times$ | 2.10 | 1.86$\times$ | 2.28 | 1.65$\times$ | 2.16 | 2.58$\times$ | 3.07 | |
| DSpark | 1.98$\times$ | 2.52 | 2.28$\times$ | 2.67 | 2.02$\times$ | 2.59 | 3.02$\times$ | 4.01 | |
| DLite | 2.32$\times$ | 2.86 | 2.74$\times$ | 3.22 | 2.53$\times$ | 3.04 | 3.96$\times$ | 4.77 |
표 3. Speedup and acceptance length ($\tau$) evaluation on agentic workloads.
| Metric | Method | AgentMemBench \ \ Speedup | AgentMemBench $\tau$ | AgentLongBench Speedup | AgentLongBench $\tau$ | *\ \ \ \ \ \ \ \ \ BFCL-v3 \ \ \ \ \ \ \ \ * Speedup | *\ \ \ \ \ \ \ \ \ BFCL-v3 \ \ \ \ \ \ \ \ * $\tau$ | *\ \ \ \ SWE-bench\ \ \ * Speedup | *\ \ \ \ SWE-bench\ \ \ * $\tau$ |
|---|---|---|---|---|---|---|---|---|---|
| Qwen3-4B | Eagle3 | 1.66$\times$ | 2.09 | 1.70$\times$ | 2.12 | 1.58$\times$ | 2.00 | 1.48$\times$ | 1.88 |
| DFlash | 1.22$\times$ | 1.65 | 0.95$\times$ | 1.14 | 1.44$\times$ | 1.80 | 1.47$\times$ | 1.72 | |
| DSpark | 1.72$\times$ | 2.10 | 1.45$\times$ | 1.84 | 2.11$\times$ | 2.54 | 1.64$\times$ | 1.89 | |
| DLite | 2.39$\times$ | 2.80 | 2.07$\times$ | 2.51 | 2.37$\times$ | 2.78 | 2.68$\times$ | 3.15 | |
| Qwen3-8B | Eagle3 | 1.77$\times$ | 2.19 | 1.60$\times$ | 2.00 | 1.49$\times$ | 1.88 | 1.33$\times$ | 1.71 |
| DFlash | 1.80$\times$ | 2.20 | 1.28$\times$ | 1.65 | 1.78$\times$ | 2.07 | 1.53$\times$ | 1.83 | |
| DSpark | 1.83$\times$ | 2.26 | 1.68$\times$ | 2.09 | 1.82$\times$ | 2.23 | 1.60$\times$ | 1.94 | |
| DLite | 2.20$\times$ | 2.69 | 2.31$\times$ | 2.79 | 2.30$\times$ | 2.76 | 2.74$\times$ | 3.19 |
표 4. High-concurrency throughput evaluation on Qwen3 models.
| Task | Method | Concurrency (TPS / Speedup) 1 | Concurrency (TPS / Speedup) 8 | Concurrency (TPS / Speedup) 16 | Concurrency (TPS / Speedup) 32 | Concurrency (TPS / Speedup) 64 | Avg. $\tau$ |
|---|---|---|---|---|---|---|---|
| Qwen3-4B | |||||||
| Alpaca | Baseline | 246 / 1.00$\times$ | 1798 / 1.00$\times$ | 3377 / 1.00$\times$ | 5849 / 1.00$\times$ | 10808 /1.00$\times$ | – |
| DSpark | 609 / 2.47$\times$ | 4131 / 2.30$\times$ | 7018 / 2.08$\times$ | 11118 / 1.90$\times$ | 13548 / 1.25$\times$ | 3.49 | |
| DLite | 635 / 2.58$\times$ | 4222 / 2.35$\times$ | 7293 / 2.16$\times$ | 11792 / 2.02$\times$ | 14300 / 1.32$\times$ | 3.63 | |
| MT-Bench | Baseline | 245 / 1.00$\times$ | 1792 / 1.00$\times$ | 3377 / 1.00$\times$ | 5883 / 1.00$\times$ | 10113 / 1.00$\times$ | – |
| DSpark | 620 / 2.53$\times$ | 4589 / 2.56$\times$ | 8177 / 2.42$\times$ | 12565 / 2.14$\times$ | 15830 / 1.57$\times$ | 3.79 | |
| DLite | 633 / 2.58$\times$ | 4699 / 2.62$\times$ | 8162 / 2.42$\times$ | 12994 / 2.21$\times$ | 16820 / 1.66$\times$ | 3.88 | |
| LCB | Baseline | 242 / 1.00$\times$ | 1665 / 1.00$\times$ | 2918 / 1.00$\times$ | 4498 / 1.00$\times$ | 6586 / 1.00$\times$ | – |
| DSpark | 905 / 3.74$\times$ | 5457 / 3.28$\times$ | 8248 / 2.83$\times$ | 10243 / 2.28$\times$ | 11309 / 1.72$\times$ | 5.28 | |
| DLite | 960 / 3.97$\times$ | 5592 / 3.36$\times$ | 8418 / 2.88$\times$ | 10873 / 2.42$\times$ | 12075 / 1.83$\times$ | 5.98 | |
| Qwen3-8B | |||||||
| Alpaca | Baseline | 142 / 1.00$\times$ | 993 / 1.00$\times$ | 1705 / 1.00$\times$ | 2920 / 1.00$\times$ | 4330 / 1.00$\times$ | – |
| DSpark | 364 / 2.56$\times$ | 2260 / 2.28$\times$ | 3758 / 2.20$\times$ | 5238 / 1.79$\times$ | 6827 / 1.58$\times$ | 3.69 | |
| DLite | 379 / 2.67$\times$ | 2409 / 2.43$\times$ | 3965 / 2.33$\times$ | 5325 / 1.82$\times$ | 7042 / 1.63$\times$ | 3.86 | |
| MT-Bench | Baseline | 143 / 1.00$\times$ | 977 / 1.00$\times$ | 1749 / 1.00$\times$ | 2950 / 1.00$\times$ | 4450 / 1.00$\times$ | – |
| DSpark | 398 / 2.78$\times$ | 2454 / 2.51$\times$ | 3956 / 2.26$\times$ | 5455 / 1.85$\times$ | 7236 / 1.63$\times$ | 3.89 | |
| DLite | 407 / 2.85$\times$ | 2531 / 2.59$\times$ | 4131 / 2.36$\times$ | 5558 / 1.88$\times$ | 7305 / 1.64$\times$ | 4.10 | |
| LCB | Baseline | 142 / 1.00$\times$ | 902 / 1.00$\times$ | 1401 / 1.00$\times$ | 2196 / 1.00$\times$ | 2708 / 1.00$\times$ | – |
| DSpark | 511 / 3.60$\times$ | 2562 / 2.84$\times$ | 3803 / 2.71$\times$ | 4815 / 2.19$\times$ | 5621 / 2.08$\times$ | 5.47 | |
| DLite | 561 / 3.95$\times$ | 2761 / 3.06$\times$ | 4016 / 2.87$\times$ | 5059 / 2.30$\times$ | 5758 / 2.13$\times$ | 6.04 |
표 5. Design space exploration of DLite\xspace on Qwen3-8B. All variants are trained on the same 80K-sample subset, and we report average acceptance length ($\tau$). For the target hidden-state exploration, the first and last target layers are always included in addition to the sampled intermediate layers. Unless otherwise specified, we use 14 target hidden states, sequence-wise hidden-state composition, and a sequential-head rank of 512. Bold indicates the configuration adopted in the final model.
| Dimension | Configuration | Alpaca | GSM8K | MBPP | Multi-Doc QA | Avg. $\tau$ |
|---|---|---|---|---|---|---|
| Target Hidden States | 7 | 2.34 | 4.36 | 3.63 | 2.22 | 3.14 |
| 9 | 2.42 | 4.40 | 3.75 | 2.24 | 3.20 | |
| 14 | 2.63 | 4.53 | 3.76 | 2.28 | 3.30 | |
| 20 | 2.62 | 4.55 | 3.74 | 2.26 | 3.29 | |
| 36 | 2.58 | 4.51 | 3.71 | 2.26 | 3.27 | |
| Hidden Composition | Feature-wise | 2.20 | 4.28 | 3.50 | 2.16 | 3.04 |
| Sequence-wise | 2.63 | 4.53 | 3.76 | 2.28 | 3.30 | |
| Sequential-Head Rank | 256 ($1/16D$) | 2.48 | 4.40 | 3.61 | 2.16 | 3.16 |
| 512 ($1/8D$) | 2.63 | 4.53 | 3.76 | 2.28 | 3.30 | |
| 1024 ($1/4D$) | 2.64 | 4.55 | 3.80 | 2.28 | 3.32 | |
| 2048 ($1/2D$) | 2.64 | 4.53 | 3.82 | 2.28 | 3.32 | |
| 4096 ($D$) | 2.64 | 4.56 | 3.82 | 2.30 | 3.33 |
Figure 번호를 붙인 원문 그림은 arXiv:2610.23787에서 가져왔습니다 (CC BY 4.0). 크기와 형식만 바꿨습니다. 후보 검증 예시는 이 글을 위해 별도로 그린 설명용 그림입니다.
댓글