확산 언어 모델은 ‘무엇을’과 ‘어디를’을 동시에 정해야 한다
확산 언어 모델은 마스크된 토큰을 여러 번 반복해서 채워가며 문장을 만든다. 정확하게 디코딩하려면 한 번의 모델 forward마다 가장 확실한 마스크 위치 하나만 토큰으로 확정해야 해서 느리고, 속도를 올리려고 한 번에 여러 위치를 확정하면 생성 품질이 떨어진다. 이 논문은 자동회귀 모델에서 검증된 무손실 가속 기법인 speculative decoding을 확산 언어 모델로 옮기되, 토큰이 아니라 어느 위치를 다음에 채울지라는 순서를 예측하는 데서 해법을 찾는다.
저자들은 한 가지 관찰을 실험으로 먼저 보여준다. 타깃 모델이 이전 forward에서 남긴 확률 분포만 봐도 각 위치에 들어갈 토큰은 대부분 미리 맞힐 수 있지만(첫 블록 커밋의 92%, 이후 90% 이상), 다음에 어느 위치가 채워질지는 거의 맞히지 못한다. 그래서 토큰은 옛 분포에서 그대로 재사용하고, 0.62M 파라미터짜리 작은 모델(SPOT)이 커밋 순서만 예측해 여러 후보 상태의 트리를 만든다. 타깃은 그 트리를 한 번의 batched forward로 검증한다. SDAR-8B에서 타깃 forward를 최대 6.8배 줄이고 처리율은 표준 디코딩 대비 최대 3.4배로 올린다(§1, §5.2).
배경: 블록을 한 칸씩 채우는 디코딩
이 논문의 타깃은 블록 인과(block-causal) 확산 언어 모델이다. 하나의 활성 블록에는 길이 $L$의 위치들이 있고(논문은 b32, 즉 $L{=}32$를 주로 쓴다), 각 위치는 토큰이거나 마스크다. 한 번의 forward는 마스크된 모든 위치에 대해 어휘 전체 확률 분포를 돌려준다. 이때 타깃은 “최고 확률이 가장 높은 위치” 하나만 골라 그 위치의 argmax 토큰으로 채운다. 이것을 commit(확정)이라 부르고, 논문은 타깃 forward 횟수를 NFE(number of function evaluations)로 센다(§3).
문제는 블록 안이 양방향 attention이라는 점이다. 한 위치를 채우는 순간 나머지 마스크 위치들의 표현과 확률 분포가 전부 바뀐다. 그래서 자동회귀 모델처럼 “다음 위치는 고정이고 어떤 토큰인지만 맞히면 된다"가 성립하지 않는다. 확산 언어 모델의 speculative decoding은 쓸 토큰과 쓸 위치를 둘 다 결정해야 한다(§1, §2).
설명용 예시 (실험 수치 아님)
블록 폭을 8로 줄여서 보자. 이미 “The”, “cat”, “sat” 세 토큰이 채워졌고 나머지 다섯 칸은 마스크다. 한 forward가 돌려준 각 마스크 위치의 최고 확률 후보(stale argmax)가 아래 표와 같다고 치자.
| 위치 | stale argmax 후보 | 확률 |
|---|---|---|
| 3 | “on” | 0.90 |
| 4 | “the” | 0.70 |
| 5 | “mat” | 0.60 |
| 6 | “quietly” | 0.50 |
| 7 | “.” | 0.95 |
이 forward에서 타깃은 가장 확실한 위치 하나만 확정한다. 위치 7의 “.“가 0.95로 가장 높으니 위치 7을 “.“로 채우고, 다음 forward에서 나머지 네 칸을 다시 본다. 여기서 유지되는 상태는 이미 확정된 토큰(“The cat sat …")이고, forward마다 바뀌는 것은 채워진 위치 하나와 나머지 마스크 위치들의 확률 전체다.
핵심은 이 예시에서 두 가지가 갈린다는 것이다. 각 위치에 결국 들어갈 토큰은 이 표의 stale argmax와 대체로 일치한다(“on”, “the”, “mat"은 대체로 맞는다). 하지만 “어느 위치를 먼저 확정하느냐"는 확률의 크기만으로는 알 수 없다. 위치 7을 채우는 순간 나머지 칸의 분포가 전부 어긋나므로, 이 표는 다음 순간부터 stale(옛) 분포가 된다.
관찰: 토큰은 이미 아는데, 순서를 모른다
방법을 설계하기 전에 저자들은 “드래프터가 도대체 뭘 예측해야 이득이 되는가"를 정량화했다. 이를 위해 타깃의 실제 미래를 훔쳐보는 live oracle을 쓴다. 세 종류를 비교한다: 진짜 다음 위치를 알려주는 position oracle, 진짜 토큰을 알려주는 token oracle, 둘 다 주는 joint oracle이다(§3.1).
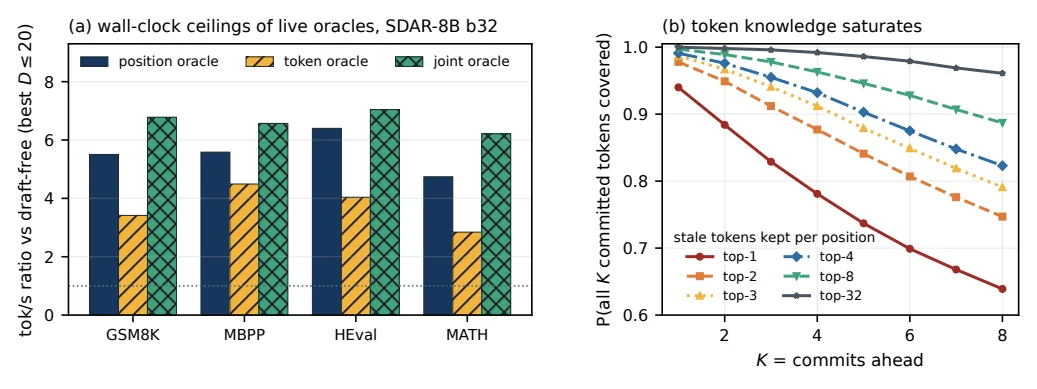
원문 Figure 2 (live oracle, SDAR-8B b32). 왼쪽 패널은 draft-free 대비 처리율 비율을 오라클 종류별·예산별로 보여주고, 오른쪽 패널은 다음 $K$ 단계의 커밋 토큰이 stale top-$t$ 후보 안에 들어올 확률을 보여준다. 왼쪽에서 position(위치) 오라클이 모든 태스크에서 token 오라클보다 위에 있다는 점, 오른쪽에서 후보 몇 개만으로도 미래 토큰을 거의 다 덮는다는 점을 읽는다.
결과는 명확하다. 위치를 아는 것이 토큰을 아는 것보다 항상 더 이득이다. D8에서 D20으로 갈 때 position oracle의 NFE 감소는 GSM8K에서 5.4배→7.2배, MBPP에서 5.7배→8.2배로 커지는 반면, token oracle은 D20에서 3.4~6.5배에 그친다. 완벽한 드래프터(joint oracle)의 처리율은 6.2~7.0배에 이른다(§3.1, Figure 2).
그 이유가 stale 분포에 이미 숨어 있다. stale argmax가 실제 확정 토큰과 일치할 확률은 첫 블록 커밋에서 92%, 이후로도 90% 이상이다. 하지만 “지난 라운드에서 가장 확신했던 위치가 다음에 커밋될 확률"은 블록 9까지 3%로 떨어진다. 토큰은 거의 이미 아는 것이고, 진짜 모르는 것은 순서다. 이 순서를 학습한 모델은 다음 커밋 위치를 75% 맞추는 반면, stale confidence로 순서를 읽는 방식은 22%에 그친다(§3.1, Appendix).
방법: 순서만 예측하는 드래프터와 결합 잡음 검증
SPOT(Speculating Positions Order Trajectory)은 두 부분으로 나뉜다. 무엇을 드래프트하는가(순서 모델)와, 어떻게 검증하는가(결합 잡음)다.
드래프터: 커밋 순서 모델
드래프터는 3층 트랜스포머 인코더($d_{model}{=}128$, 8헤드, 0.62M 파라미터)로, 각 마스크 위치의 stale 상위 32개 확률(원본·로그)과 요약 통계, 경로 특징을 읽고 다음에 커밋될 위치의 분포 $q_\phi(s|y)$를 예측한다. 타깃의 히든 스테이트나 토큰 임베딩, 텍스트를 전혀 쓰지 않는다(§4.2).
토큰은 예측하지 않는다. 각 위치의 후보 토큰은 stale 분포에서 가져온다. $T{=}0$에서는 stale argmax를 주 후보로 쓰고, stale top-1 확률이 0.6보다 낮으면 2순위 후보를 하나 더 넣는다(token hedge). 이 예외 덕분에 순서를 맞혔을 때 토큰을 틀려 검증에서 떨어지는 경우를 줄인다(§4.2).
핵심은 prefix-conditional 방식이다. 드래프터가 어떤 가상 상태에서 다음 위치를 예측하면, 그 위치를 채운 새 가상 상태에서 다시 다음 위치를 예측하고, 이를 재귀적으로 반복해 후보 상태의 트리를 키운다. 트리를 넓히는 기준은 prefix mass인데, 자식의 질량 = 부모 질량 × (이 위치가 커밋될 확률) × (이 토큰이 채워질 확률)로 정의하고 모든 인자가 $[0,1]$이라 자식은 부모보다 질량이 클 수 없다. 이 단조성 덕분에 최고 질량 후보 $D$개를 레벨별로 뽑는 탐색(DDTree)이 순차 best-first 탐색과 같은 결과를 낸다(§4.2, Appendix).
  flowchart LR
  A["현재 블록 상태<br/>일부 칸 확정, 일부 마스크"] --> B["stale 분포 읽기<br/>마스크 위치마다 확률"]
  B --> C["순서 모델: 다음 커밋 위치 예측"]
  C --> D["후보 트리 확장<br/>자식 = 위치+토큰 확정"]
  D -->|"재귀 반복, 예산 D까지"| C
  D --> E["타깃 1회 batched forward<br/>root + 모든 draft 검증"]
  E --> F["가장 긴 일치 경로만 commit"]
  F --> A
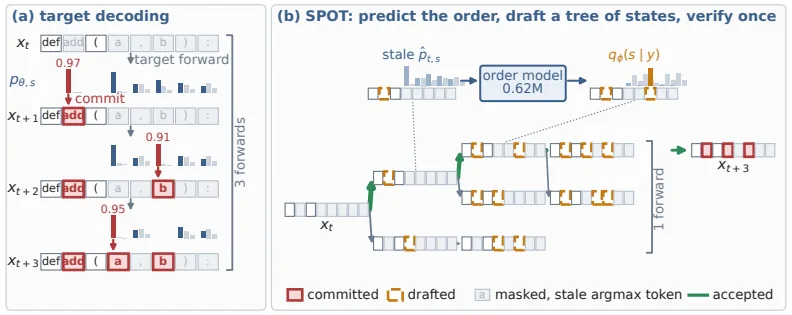
원문 Figure 1 (SPOT overview). (a) 타깃은 forward마다 가장 확실한 위치 하나를 확정하는데, 토큰은 대체로 미리 알려져 있고 순서만 모른다. (b) SPOT이 stale 분포를 읽어 0.62M 순서 모델로 다음 위치를 예측하고, prefix mass(가장자리 두께)로 상태 트리를 키워 한 번의 batched forward로 모두 검증해 세 위치를 확정하는 모습을 보여준다.
검증은 상태 동일성(state equality)으로 한다. 각 드래프트 상태를 캐시된 prefix 뒤에 블록 복사본으로 붙여 $(1{+}D)L$ 위치를 한 번에 forward하면, 루트와 모든 드래프트 상태에서 타깃의 다음 커밋이 한 번에 나온다. 드래프트는 그 부모에서 타깃이 실제로 내는 커밋과 일치할 때만 받아들인다. 타깃의 다음 커밋은 유일하므로, 받아들여지는 것은 항상 경로 하나다. 따라서 출력은 드래프트가 얼마나 틀리든 절대 변하지 않는다 — 드래프터는 속도만 정하고 정확성은 건드리지 않는다(§4.1, §4.2).
검증: 샘플링에서도 정확성을 지키는 결합 잡음
$T{=}0$에서는 커밋이 결정론적이라 상태 동일성 검증이 그대로 성립한다(Proposition 1). 문제는 $T{>}0$ 샘플링이다. 같은 분포에서 독립적으로 샘플을 뽑으면 서로 다른 토큰이 나올 수 있어서, 옳은 드래프트도 상태가 달라 거절된다.
SPOT의 해법은 드래프터와 타깃이 같은 Gumbel 난수를 공유하는 것이다. 온도 $T$에서 토큰을 뽑는 것은, 위치·토큰마다 Gumbel 난수 $G_{a,v}$를 뽑아 $\argmax_v[(1/T)\log p + G_{a,v}]$를 고르는 것과 수학적으로 같다(Gumbel-argmax 항등식). 같은 난수 표를 절대 위치 기준으로 양쪽이 공유하면, 난수가 정해진 순간 타깃의 추첨 결과가 결정론적으로 변한다. 그러면 샘플링 검증이 다시 상태 동일성으로 돌아간다. 난수 $G$에 대해 조건부로는 정확하고, $G$를 적분하면 원래 샘플링 분포를 그대로 회복한다(Proposition 2, §4.3).
이 결합 검증이 중요한 이유는 온도가 높아질수록 뚜렷하다. $T{\le}1$에서는 뽑힌 토큰이 99~99.8% argmax라 두 방식 차이가 2% 이내지만, $T{=}2$에서는 독립 샘플 검증이 거의 아무것도 받아들이지 못하는(257.5 NFE, draft-free 267.1) 반면 결합 검증은 계속 드래프트한다(187.2 NFE). 결합 검증의 수용 확률은 stale과 fresh 분포의 총변동거리 $\delta$로 하한이 잡힌다: 최소 $(1-\delta)/(1+\delta)$(§3.2, §4.3).
SPOT-Sets: 한 번에 여러 칸을 확정하는 디코딩 위에서
지금까지는 forward마다 위치 하나를 확정하는 정확한 디코딩이었다. 그런데 더 빠른 디코더는 한 forward에서 확률이 임계값 $\tau$를 넘는 모든 위치를 한꺼번에 확정한다(동적 임계값 디코딩). 이 경우 드래프트 단위는 위치 하나가 아니라 커밋 세트가 되고, 토큰도 드래프터가 정해야 한다. stale argmax는 한 단계 앞은 83% 맞지만 세 단계 앞은 44%밖에 맞지 않기 때문이다(§4.4).
SPOT-Sets는 이를 위해 5.1M 파라미터 드래프터를 쓴다. stale 상위 16개 후보 토큰의 임베딩과 타깃의 마지막 히든 스테이트를 추가로 읽고, 각 위치가 다음 단계에 $\tau$를 넘을지와 어떤 후보 토큰을 택할지를 예측한다. 트리의 노드는 위치 하나가 아니라 목표 단계 하나 전체다(§4.4).
작은 예시로 정리하면(설명용 예시), 임계값 디코딩에서 한 forward는 {3,4,6}처럼 여러 위치를 한 번에 확정한다. SPOT-Sets는 이 세트 전체를 드래프트하고, 블록을 다 채운 드래프트는 다음 블록까지 이어서 제안한다.
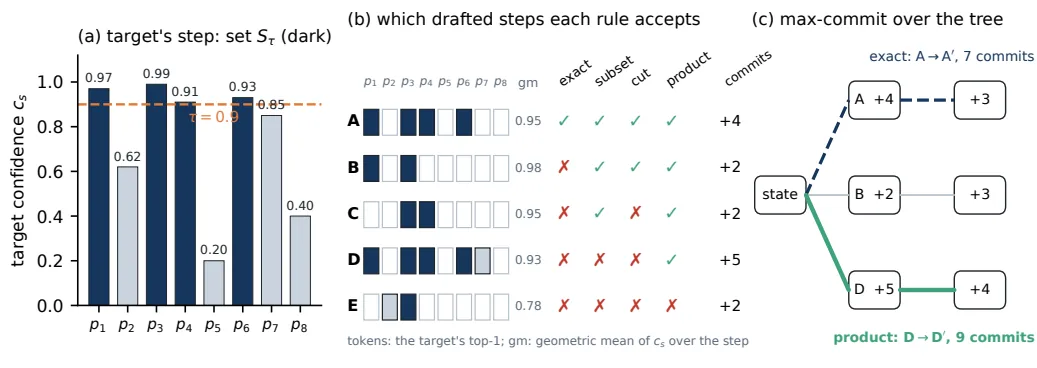
원문 Figure 3 (max-commit). (a) 임계값 디코더는 $\tau$를 넘는 위치들 $S_\tau$를 확정한다. (b) 정확한 수용(exact)은 드래프트 단계가 $S_\tau$와 같을 때만 받아들이고, subset·cut은 그 일부도 받아들이며, product는 confidence의 기하평균이 $\tau$ 이상인 어떤 단계든 받아들인다. (c) max-commit은 가장 많이 커밋되는 경로를 따라간다: exact에서는 7, product에서는 9 커밋이며 product의 출력은 임계값 디코더 자신의 출력과 달라진다.
여기서 정확성과 속도의 트레이드오프가 다시 나타난다. 정확한 수용(exact)은 출력을 임계값 디코더와 동일하게 유지하지만, 저자들의 주 결과는 더 느슨한 product 규칙을 쓴다. product는 confidence의 기하평균이 $\tau$ 이상인 단계까지 받아들여 forward당 더 많이 커밋하지만, 더 이상 임계값 디코더의 출력을 재현하지 않는다. 그래서 논문은 exact 변형도 함께 보고한다. 블록이 끝날 때마다 몇 forward마다 발생하는 비용을 줄이기 위해 cross-block drafting과 draft refresh라는 두 가지 블록 경계 최적화도 추가한다(§4.4, Appendix).
결과: forward 횟수와 처리율을 따로 읽기
결과를 볼 때 두 지표를 섞지 말아야 한다. NFE는 타깃 forward 횟수(드래프터 자체 비용은 빠진다), 처리율 비율은 초당 생성 토큰 기준으로 같은 카드·같은 태스크·같은 온도의 draft-free 실행 대비 값이다. draft 한 라운드는 수용 여부와 무관하게 $(1{+}D)L$ 위치를 forward하므로, NFE 감소폭과 처리율 이득은 항상 같지 않다는 게 이 논문의 되풀이되는 지점이다(§3.1, Appendix).
핵심 질문은 이렇다. SPOT이 같은 드래프트 예산으로 baseline보다 forward를 덜 쓰면서 처리율도 더 높은가? 아래는 SDAR-8B b32, $T{=}0$, 예산 D8에서의 NFE(낮을수록 좋음)와 처리율 비율(높을수록 좋음)이다(§5.2, 메인 결과표).
| 방법 (SDAR-8B, T=0, D8) | GSM8K | MBPP | HumanEval | MATH500 |
|---|---|---|---|---|
| draft-free (기준) | 270.8 (1.00×) | 269.2 (1.00×) | 271.4 (1.00×) | 271.8 (1.00×) |
| Spiffy 그래프 | 92.5 (2.48×) | 83.6 (2.40×) | 87.6 (2.64×) | 100.6 (2.29×) |
| SPOT | 70.1 (2.95×) | 56.7 (3.38×) | 62.5 (3.35×) | 84.6 (2.50×) |
SPOT은 전체 태스크·예산에서 Spiffy보다 forward를 16~36% 덜 쓰고 처리율은 1.04~1.41배 더 높다. 주목할 것은 baseline들의 처리율이 예산을 키울수록 무너진다는 점이다. D8에서 D20으로 가면 SSD 체인은 2.3~2.6배에서 1.4~1.7배로, BlockSpec 트리는 1.5~1.7배에서 0.86~1.10배로 떨어져 MBPP에서는 draft-free보다 오히려 느려진다. 넓은 드래프트는 수용 여부와 무관하게 $(1{+}D)L$ 위치를 소모하는데, 이들은 라운드당 1.1~2.9 토큰밖에 수용하지 못하기 때문이다. SPOT은 라운드당 2.5~7.5 토큰을 수용한다(§5.2).
여기에 mass floor $\gamma$를 켠 SPOT-$\gamma$는 예산 의존성을 거의 없앤다. 질량이 $\gamma$ 미만인 드래프트를 버려 실제 검증 예산을 드래프터 확신에 맞추는데, 처리율 비율이 D8의 2.5~3.5배에서 D20의 2.3~3.4배로 거의 평평하다. $T{=}1$ 샘플링에서도 같은 순서가 유지되며(Spiffy 대비 NFE 16~35%, 처리율 1.08~1.37배), T=1 결과는 distribution-preserving으로 정확성이 draft-free 대비 0.04 이내다(§5.2, §5.3).
임계값 디코딩 위에서는 7.9배
더 빠른 임계값 디코딩(혼자서 이미 표준 대비 3.3~6.1배, 평균 5.0배) 위에 SPOT-Sets를 올리면 SDAR-8B에서 5.2~9.9배, 평균 7.9배까지 올라간다. 임계값 디코더 대비로는 forward를 47~48% 줄인다. 정확성을 유지하는 exact 변형도 7.6배에 이른다(§5.2).
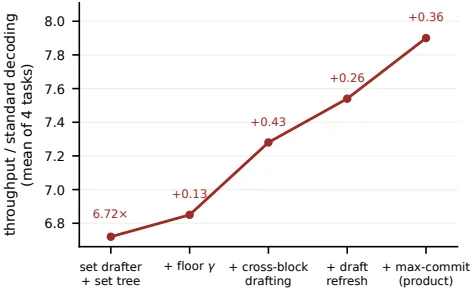
원문 Figure 4 (ladder). 표준 디코딩 대비 처리율을 네 태스크 평균으로, SPOT-Sets의 각 부분을 차례로 켜며 보여준다(라벨은 단계별 이득). set 드래프터와 트리만으로 6.7배까지 오르고, mass floor가 6.7→6.9배, 블록 경계 최적화인 cross-block drafting과 draft refresh가 6.9→7.5배로 가장 큰 이득을 더하며, product max-commit이 7.9배로 마무리한다(§5.5, Figure 4).
전이성도 주장의 핵심이다. 같은 레시피로 학습한 드래프터를 재학습·재보정 없이 다른 모델에 붙여도, SDAR-8B 체크포인트를 LLaDA2.0-mini(토크나이저가 다른 MoE 모델)에 옮기면 NFE 손실이 3~11%에 그치고 GSM8K·MATH500에서 여전히 모든 baseline을 앞선다. 한 번도 본 적 없는 LLaDA-8B와 Dream-7B에서는 각각 256번의 forward를 55~88번, 51~80번으로 줄인다. 단 이 둘은 전 시퀀스에 attention을 걸어 정확한 prefix 캐시가 없어 근사 캐시를 쓰므로, 이 행들은 무손실이 아니라 “도달 범위"를 보여준다(§5.4, Appendix).
한계와 적용 판단
저자가 명시적으로 인정한 한계가 몇 가지 있다(§6).
- 검증 비용이 크거나 수용률이 낮으면 이득이 줄어든다. 블록 폭이 넓으면 검증이 병목이 되고, 양방향 attention 아래에서 트리를 정확히 하나의 시퀀스로 패킹하는 문제는 여전히 풀리지 않았다.
- 수용률이 낮은 태스크에서는 이득이 좁아진다. 가장 작은 SDAR-1.7B에서는 MATH500 D20에서 Spiffy가 SPOT의 처리율 한 칸을 가져간다. forward가 워낙 싸서 드래프트 검증 비용의 비중이 커지기 때문이다. SPOT-γ는 저질량 드래프트를 버려 검증량을 줄이므로 그 칸을 다시 가져온다(Appendix).
- 고온에서는 $T{=}0$에서 학습한 순서 모델이 noise-aware 순위 매기기에 밀린다. $T{\ge}2$에서는 그렇고, 사실 $T{\ge}1.5$부터 타깃 자체 품질이 급락해(정확성 0.11, $T{\ge}2$에서 0.00) 지킬 정확성이 거의 남지 않는다.
- SPOT-Sets는 모델마다 짧은 보정이 필요하다. 히든 스테이트와 토큰 임베딩을 읽어서, SPOT과 달리 새 타깃마다 입력 레이어를 다시 맞춰야 한다. 5.1M 파라미터 드래프터는 타깃 forward가 싼 모델에서는 부담이 커진다.
- 주 결과의 max-commit(product 규칙)은 출력을 바꾼다. 정확성을 유지하려면 exact 변형을 써야 하고, 이는 속도 이득이 다소 줄어든다.
리뷰어 관점에서 짚어줄 것은 다음과 같다. 논문이 보여주는 6.8배 NFE 감소는 ‘forward 횟수’ 기준이고, 실제 처리율은 2.5~3.4배(SPOT) 또는 임계값 디코딩 위 7.9배로, 두 숫자를 혼동하면 안 된다. 또 SDAR-8B 드래프터는 코드 데이터(CodeAlpaca)로만 학습되어 GSM8K·MATH500이 도메인 밖인데도 잘 동작하는 것이 순서 지식의 일반성을 보여주는 근거가 되지만, 반대로 평가 태스크 같은 분포로 학습한 SPOT-Sets 드래프터는 SDAR-8B에서 평균 8.2배(일반 chat 드래프터 대비 7.9배)로 더 빨라, 적용 환경의 분포가 결과에 영향을 준다(§5.2, Appendix). LLaDA-8B·Dream-7B 결과는 근사 캐시라 무손실 보장이 아니라는 점도 별도로 구분해야 한다.
정리하면, SPOT은 정확한 prefix KV 캐시가 있고 블록 폭이 과도하게 넓지 않은 블록 인과 확산 모델에서, 무손실 가속이 필요할 때 가장 잘 들어맞는다. 결합 잡음 검증은 어떤 온도에서도 분포를 그대로 보존하며(Proposition 2), $T{\le}1$의 일반적인 생성 환경에서는 독립 샘플 검증과도 2% 이내로 결과가 가까워 가장 안전한 배포 설정이다. 임계값 디코딩처럼 이미 손실을 감수한 빠른 경로에서는 SPOT-Sets의 product 규칙이 추가 이득을 주는데, 논문 보고 기준 exact 대비 정확성 차이는 태스크마다 0.04 이내지만 출력 자체는 바뀌므로(예시 규칙: exact의 정확성 불변, cut은 디코더를 더 엄격하게 만들 뿐), 적용 시 품질을 별도로 확인해야 한다.
논문 원문의 표
arXiv e-print 의 LaTeX 원본에서 기계적으로 옮긴 표입니다. 숫자는 논문의 값이며 모델을 거치지 않았습니다.
표 1. Mass-floor calibration grids: mean throughput ratio over $D8/D12/D20$ on the $50$ held-out MBPP samples (test $350$–$399$), unpadded, seed $0$, against the same card’s draft-free run. Bold: selected.
| target | $\gamma{=}0$ | $0.02$ | $0.05$ | $0.1$ | $0.2$ |
|---|---|---|---|---|---|
| SDAR-8B b32 | 3.64 | 4.10 | 4.08 | 3.92 | 3.72 |
| SDAR-4B b32 | 4.04 | 4.47 | 4.35 | 4.24 | 4.02 |
| SDAR-1.7B b32 | 4.04 | 4.43 | 4.33 | 4.21 | 3.92 |
| LLaDA2.0-mini b32 | 2.25 | 2.28 | 2.18 | 2.09 | 1.88 |
표 2. MRP’s reported speedups next to SPOT. MRP: speculative mode ($K{=}3$) over its one-token-per-step baseline, Table 2 of (one H100, block width $16$, greedy). SPOT: $D8$ throughput ratio over our draft-free control (block width $32$, length $256$, one card, seed $0$), NFE reduction in parentheses. MRP generates up to $4096$ tokens. Different implementations: relative gains only.
| target | method | GSM8K | MATH500 | HumanEval | MBPP |
|---|---|---|---|---|---|
| SDAR-1.7B | MRP (reported) | $1.25\times$ | $1.23\times$ | $1.23\times$ | $1.17\times$ |
| SPOT (ours) | $\mathbf{2.81\times}$ (3.6) | $\mathbf{2.48\times}$ (3.2) | $\mathbf{3.23\times}$ (4.2) | $\mathbf{3.74\times}$ (4.9) | |
| SDAR-4B | MRP (reported) | $1.36\times$ | $1.26\times$ | $1.35\times$ | $1.27\times$ |
| SPOT (ours) | $\mathbf{3.27\times}$ (4.0) | $\mathbf{2.61\times}$ (3.3) | $\mathbf{3.49\times}$ (4.4) | $\mathbf{3.79\times}$ (4.9) | |
| SDAR-8B | MRP (reported) | $1.40\times$ | $1.39\times$ | $1.34\times$ | $1.34\times$ |
| SPOT (ours) | $\mathbf{3.00\times}$ (3.9) | $\mathbf{2.47\times}$ (3.2) | $\mathbf{3.44\times}$ (4.3) | $\mathbf{3.65\times}$ (4.7) |
표 3. Speculative decoding for diffusion targets, on the axes this paper argues are the relevant ones. Learns order'' = the commit order is predicted by a trained model rather than read off stale confidence or fixed offline; multi-step’’ = one drafted proposal spans more than one commit; ``exact $T{>}0$’’ = the committed distribution is provably the target’s at sampling temperature.
| method | drafter | size | learns order | multi-step | exact $T{>}0$ | single device |
|---|---|---|---|---|---|---|
| Spiffy | offline graph | — | ✗ | ✓ | ✗ | ✓ |
| SSD | self (confidence) | — | ✗ | ✓ | ✗ | ✓ |
| BlockSpec | self (conf.\ tree) | — | ✗ | ✓ | ✗ | ✓ |
| SimSD | sibling model | 1.7B | ✓ | ✓ | approx.\ | ✗ |
| MRP | residual head | 3 layers | ✗ | ✓ | ✗ | ✓ |
| SPOT (ours) | order model | 0.62M | ✓ | ✓ | ✓ | ✓ |
표 4. Live-oracle grid, $T{=}0$, generation length 256, $n{=}100$, seed 0. Per setting: NFE (reduction $\times$ over the setting’s draft-free NFE) and tok/s ratio (lookahead subtracted) over the setting’s draft-free throughput, for the position, token and joint oracles at $D8$/$D12$/$D20$; the draft-free column gives the baseline NFE and tok/s. Bold: best throughput per setting.
| setting | metric | draft-free | position oracle $D8$ | position oracle $D12$ | position oracle $D20$ | token oracle $D8$ | token oracle $D12$ | token oracle $D20$ | joint oracle $D8$ | joint oracle $D12$ | joint oracle $D20$ |
|---|---|---|---|---|---|---|---|---|---|---|---|
| SDAR-8B b32 GSM8K | NFE | 271.1 | 49.8 (5.4$\times$) | 42.5 (6.4$\times$) | 37.5 (7.2$\times$) | 68.3 (4.0$\times$) | 65.0 (4.2$\times$) | 61.6 (4.4$\times$) | 46.3 (5.8$\times$) | 37.9 (7.2$\times$) | 30.4 (8.9$\times$) |
| tok/s ratio | 16.3 tok/s | 4.62$\times$ | 5.37$\times$ | 5.51$\times$ | 3.34$\times$ | 3.42$\times$ | 3.32$\times$ | 5.00$\times$ | 5.93$\times$ | 6.78$\times$ | |
| SDAR-8B b32 MBPP | NFE | 267.1 | 46.8 (5.7$\times$) | 39.7 (6.7$\times$) | 32.8 (8.2$\times$) | 53.5 (5.0$\times$) | 47.3 (5.6$\times$) | 41.0 (6.5$\times$) | 43.5 (6.1$\times$) | 35.3 (7.6$\times$) | 27.4 (9.7$\times$) |
| tok/s ratio | 16.3 tok/s | 4.91$\times$ | 5.43$\times$ | 5.58$\times$ | 4.23$\times$ | 4.49$\times$ | 4.35$\times$ | 5.20$\times$ | 6.06$\times$ | 6.57$\times$ | |
| SDAR-8B b32 HumanEval | NFE | 272.6 | 47.1 (5.8$\times$) | 39.7 (6.9$\times$) | 32.9 (8.3$\times$) | 61.9 (4.4$\times$) | 57.4 (4.7$\times$) | 52.8 (5.2$\times$) | 45.7 (6.0$\times$) | 37.7 (7.2$\times$) | 29.9 (9.1$\times$) |
| tok/s ratio | 15.9 tok/s | 4.94$\times$ | 5.85$\times$ | 6.40$\times$ | 3.85$\times$ | 4.04$\times$ | 3.98$\times$ | 5.22$\times$ | 6.15$\times$ | 7.04$\times$ | |
| SDAR-8B b32 MATH500 | NFE | 272.9 | 53.5 (5.1$\times$) | 47.7 (5.7$\times$) | 44.5 (6.1$\times$) | 81.9 (3.3$\times$) | 81.9 (3.3$\times$) | 81.0 (3.4$\times$) | 48.0 (5.7$\times$) | 39.8 (6.9$\times$) | 32.6 (8.4$\times$) |
| tok/s ratio | 16.2 tok/s | 4.33$\times$ | 4.74$\times$ | 4.65$\times$ | 2.84$\times$ | 2.77$\times$ | 2.50$\times$ | 4.69$\times$ | 5.75$\times$ | 6.21$\times$ | |
| LLaDA2.0-mini b32 MBPP | NFE | 270.4 | 59.4 (4.6$\times$) | 53.7 (5.0$\times$) | 51.9 (5.2$\times$) | 90.1 (3.0$\times$) | 89.8 (3.0$\times$) | 88.8 (3.0$\times$) | 54.1 (5.0$\times$) | 46.7 (5.8$\times$) | 42.3 (6.4$\times$) |
| tok/s ratio | 6.6 tok/s | 3.23$\times$ | 3.45$\times$ | 3.39$\times$ | 2.25$\times$ | 2.21$\times$ | 1.98$\times$ | 3.66$\times$ | 3.96$\times$ | 4.40$\times$ |
표 5. Main results, SDAR-4B b32, $T{=}0$ (format as Table ). SPOT has the lowest NFE and the highest throughput ratio in every ours-vs-baseline comparison. Seed $0$. Lower block: the threshold decoder ($\tau{=}0.9$), second machine, main_sdar4b, SPOT-Sets rows and ratios as in Table .
| NFE$\downarrow$ (tok/s$\uparrow$) | GSM8K | MBPP | HumanEval | MATH500 | ||||
|---|---|---|---|---|---|---|---|---|
| acc.\ 0.85–0.87 | acc.\ 0.24–0.27 | acc.\ 0.59–0.63 | acc.\ 0.13–0.14 | |||||
| method | $D8$ | $D20$ | $D8$ | $D20$ | $D8$ | $D20$ | $D8$ | $D20$ |
| no draft ($D0$) | 270.8$\downarrow$ (1.00$\uparrow$) | 269.2$\downarrow$ (1.00$\uparrow$) | 271.4$\downarrow$ (1.00$\uparrow$) | 271.8$\downarrow$ (1.00$\uparrow$) | ||||
| SPOT (ours) | 68.5 (3.27) | 51.1 (3.69) | 54.6 (3.79) | 37.8 (3.74) | 61.1 (3.49) | 45.0 (3.93) | 82.3 (2.61) | 64.6 (2.87) |
| SPOT-$\gamma$ (ours) | 68.5 (3.29) | 53.2 (3.96) | 54.8 (3.92) | 39.7 (4.69) | 61.3 (3.54) | 46.6 (4.33) | 82.6 (2.63) | 68.2 (3.08) |
| Spiffy graph | 91.2 (2.67) | 71.0 (3.24) | 82.4 (2.83) | 59.7 (3.14) | 88.9 (2.70) | 66.8 (3.44) | 97.7 (2.39) | 80.5 (2.79) |
| SSD free chain | 91.5 (2.67) | 83.7 (2.68) | 83.3 (2.82) | 74.5 (2.26) | 89.5 (2.74) | 78.6 (2.74) | 98.5 (2.38) | 91.5 (2.33) |
| BlockSpec tree | 136.3 (1.74) | 114.3 (1.80) | 135.1 (1.70) | 111.0 (1.35) | 135.9 (1.71) | 113.3 (1.75) | 136.1 (1.68) | 115.5 (1.75) |
| 0.6pt2.5pt0pt threshold decoding, $\tau{=}0.9$ (second machine, $n{=}350$, HumanEval $164$) | ||||||||
| $T{=}0$ | acc.\ 0.84–0.86 | acc.\ 0.24–0.27 | acc.\ 0.58–0.61 | acc.\ 0.13–0.15 | ||||
| no draft | 59.0$\downarrow$ (4.55$\uparrow$) | 40.6$\downarrow$ (6.43$\uparrow$) | 38.4$\downarrow$ (6.91$\uparrow$) | 85.4$\downarrow$ (3.14$\uparrow$) | ||||
| SPOT-Sets-$\gamma$ (ours) | 30.9 (7.34) | 30.6 (7.38) | 22.0 (10.22) | 21.5 (10.40) | 21.8 (10.42) | 21.7 (10.42) | 45.0 (5.04) | 44.9 (5.07) |
| SPOT-Sets-$\gamma$, exact (ours) | 33.2 (6.85) | 33.0 (6.83) | 22.7 (9.90) | 22.3 (10.00) | 23.4 (9.73) | 23.2 (9.66) | 48.0 (4.75) | 47.4 (4.77) |
| Spiffy graph | 37.8 (6.27) | 37.7 (6.23) | 25.1 (9.48) | 24.8 (8.91) | 28.0 (8.59) | 28.0 (8.51) | 54.4 (4.34) | 53.8 (4.33) |
| SSD free chain | 37.9 (6.26) | 37.1 (5.01) | 24.8 (9.46) | 23.9 (6.43) | 28.1 (8.56) | 27.6 (6.77) | 54.2 (4.36) | 52.9 (3.44) |
| BlockSpec tree | 41.1 (5.62) | 38.4 (4.64) | 27.7 (8.33) | 25.4 (5.82) | 29.6 (7.93) | 28.3 (6.40) | 58.9 (3.92) | 55.3 (3.04) |
표 6. SDAR-4B b32 at $T{=}1$ (coupled-noise match; free chain also under rejection sampling). Every comparison won on both columns. Seed $0$. Both blocks from the second machine, each ratio over that machine’s draft-free run. Lower block: the threshold decoder ($\tau{=}0.9$), main_sdar4b_t1, SPOT-Sets rows and ratios as in Table .
| NFE$\downarrow$ (tok/s$\uparrow$) | GSM8K | MBPP | HumanEval | MATH500 | ||||
|---|---|---|---|---|---|---|---|---|
| acc.\ 0.85–0.88 | acc.\ 0.19–0.23 | acc.\ 0.55–0.63 | acc.\ 0.13–0.17 | |||||
| method | $D8$ | $D20$ | $D8$ | $D20$ | $D8$ | $D20$ | $D8$ | $D20$ |
| no draft ($D0$) | 270.8$\downarrow$ (1.00$\uparrow$) | 269.2$\downarrow$ (1.00$\uparrow$) | 271.4$\downarrow$ (1.00$\uparrow$) | 271.8$\downarrow$ (1.00$\uparrow$) | ||||
| SPOT (ours) | 70.9 (2.94) | 53.4 (2.77) | 57.2 (3.64) | 40.4 (2.79) | 62.9 (3.32) | 46.8 (3.05) | 85.6 (2.48) | 67.8 (2.19) |
| SPOT-$\gamma$ (ours) | 71.3 (3.02) | 55.9 (3.36) | 57.8 (3.73) | 42.9 (3.98) | 63.4 (3.39) | 48.7 (3.72) | 86.5 (2.49) | 72.0 (2.63) |
| Spiffy graph | 94.3 (2.47) | 74.4 (2.53) | 84.9 (2.80) | 63.3 (2.23) | 90.2 (2.61) | 68.6 (2.63) | 102.4 (2.29) | 86.0 (2.15) |
| free chain, match | 94.6 (2.45) | 86.5 (1.99) | 85.8 (2.73) | 77.3 (1.64) | 90.7 (2.56) | 79.9 (2.04) | 103.3 (2.23) | 96.4 (1.74) |
| free chain, RS | 88.5 (1.95) | 83.4 (1.66) | 61.2 (2.97) | 50.7 (2.37) | 76.7 (2.24) | 69.7 (1.94) | 110.3 (1.55) | 110.2 (1.29) |
| BlockSpec tree | 138.9 (1.63) | 117.7 (1.37) | 137.9 (1.66) | 114.2 (1.00) | 137.7 (1.65) | 115.8 (1.32) | 140.8 (1.62) | 121.1 (1.27) |
| 0.6pt2.5pt0pt threshold decoding, $\tau{=}0.9$ (second machine, $n{=}350$, HumanEval $164$) | ||||||||
| $T{=}1$ | acc.\ 0.81–0.85 | acc.\ 0.19–0.21 | acc.\ 0.57–0.60 | acc.\ 0.15–0.17 | ||||
| no draft | 59.9$\downarrow$ (4.41$\uparrow$) | 41.2$\downarrow$ (6.46$\uparrow$) | 41.9$\downarrow$ (6.35$\uparrow$) | 86.8$\downarrow$ (3.11$\uparrow$) | ||||
| SPOT-Sets-$\gamma$ (ours) | 34.3 (6.44) | 33.8 (6.50) | 25.8 (8.53) | 25.9 (8.46) | 25.7 (8.64) | 25.5 (8.50) | 49.8 (4.45) | 49.1 (4.46) |
| SPOT-Sets-$\gamma$, exact (ours) | 36.4 (6.27) | 35.9 (6.30) | 26.4 (8.57) | 26.2 (8.56) | 26.7 (8.39) | 26.6 (8.37) | 52.5 (4.30) | 51.6 (4.34) |
| Spiffy graph | 41.5 (5.66) | 41.4 (5.58) | 28.1 (8.36) | 28.3 (7.79) | 31.6 (7.43) | 31.8 (7.33) | 60.2 (3.90) | 59.4 (3.91) |
| SSD free chain | 41.1 (5.72) | 40.6 (4.65) | 27.8 (8.48) | 27.6 (5.45) | 31.3 (7.53) | 31.3 (5.93) | 60.1 (3.91) | 59.4 (2.96) |
| BlockSpec tree | 43.5 (5.30) | 41.3 (4.27) | 30.2 (7.62) | 28.6 (5.02) | 33.0 (7.08) | 31.7 (5.65) | 63.2 (3.62) | 60.3 (2.80) |
표 7. Main results, SDAR-1.7B b32, $T{=}0$ (format as Table ). SPOT has the lowest NFE in every ours-vs-baseline comparison and the higher throughput ratio in $23$ of $24$ (Spiffy takes MATH500 at $D20$); SPOT-$\gamma$ wins all $24$ on both columns. Seed $0$. Lower block: the threshold decoder ($\tau{=}0.9$), second machine, main_sdar17, SPOT-Sets rows and ratios as in Table .
| NFE$\downarrow$ (tok/s$\uparrow$) | GSM8K | MBPP | HumanEval | MATH500 | ||||
|---|---|---|---|---|---|---|---|---|
| acc.\ 0.69–0.71 | acc.\ 0.29–0.30 | acc.\ 0.45–0.47 | acc.\ 0.09–0.11 | |||||
| method | $D8$ | $D20$ | $D8$ | $D20$ | $D8$ | $D20$ | $D8$ | $D20$ |
| no draft ($D0$) | 270.8$\downarrow$ (1.00$\uparrow$) | 269.2$\downarrow$ (1.00$\uparrow$) | 271.4$\downarrow$ (1.00$\uparrow$) | 271.8$\downarrow$ (1.00$\uparrow$) | ||||
| SPOT (ours) | 75.6 (2.81) | 58.8 (3.01) | 55.4 (3.74) | 38.8 (4.28) | 64.6 (3.23) | 46.4 (3.69) | 85.2 (2.48) | 67.7 (2.67) |
| SPOT-$\gamma$ (ours) | 75.7 (2.85) | 62.2 (3.30) | 55.7 (3.83) | 40.4 (5.02) | 64.5 (3.30) | 48.1 (4.09) | 85.6 (2.55) | 71.6 (2.85) |
| Spiffy graph | 94.8 (2.49) | 76.6 (2.99) | 85.3 (2.79) | 64.4 (3.55) | 89.9 (2.64) | 69.3 (3.27) | 99.4 (2.39) | 82.8 (2.75) |
| SSD free chain | 94.8 (2.47) | 88.1 (2.54) | 91.4 (2.54) | 76.5 (3.00) | 89.4 (2.66) | 81.8 (2.78) | 99.3 (2.43) | 92.7 (2.46) |
| BlockSpec tree | 136.5 (1.68) | 115.7 (1.72) | 135.1 (1.71) | 111.5 (1.81) | 135.2 (1.70) | 112.7 (1.83) | 136.0 (1.68) | 115.8 (1.75) |
| 0.6pt2.5pt0pt threshold decoding, $\tau{=}0.9$ (second machine, $n{=}350$, HumanEval $164$) | ||||||||
| $T{=}0$ | acc.\ 0.67–0.69 | acc.\ 0.28–0.30 | acc.\ 0.42–0.45 | acc.\ 0.09–0.10 | ||||
| no draft | 86.4$\downarrow$ (3.13$\uparrow$) | 40.7$\downarrow$ (6.46$\uparrow$) | 48.5$\downarrow$ (5.50$\uparrow$) | 95.7$\downarrow$ (2.83$\uparrow$) | ||||
| SPOT-Sets-$\gamma$ (ours) | 43.4 (5.04) | 42.6 (5.08) | 22.5 (9.90) | 22.2 (9.91) | 26.7 (8.36) | 26.2 (8.47) | 51.6 (4.23) | 51.3 (4.26) |
| SPOT-Sets-$\gamma$, exact (ours) | 46.2 (4.74) | 45.5 (4.73) | 23.3 (9.63) | 22.9 (9.65) | 27.9 (8.02) | 27.5 (8.09) | 55.2 (4.05) | 54.5 (4.06) |
| Spiffy graph | 53.8 (4.36) | 52.7 (4.37) | 26.3 (8.98) | 25.7 (9.02) | 33.7 (7.10) | 33.0 (7.05) | 62.8 (3.73) | 61.5 (3.75) |
| SSD free chain | 53.1 (4.39) | 51.9 (4.22) | 25.7 (9.18) | 25.2 (8.92) | 33.3 (7.17) | 32.6 (6.98) | 62.4 (3.73) | 60.6 (3.64) |
| BlockSpec tree | 58.3 (3.92) | 54.3 (3.73) | 28.3 (8.10) | 26.5 (7.88) | 35.7 (6.51) | 33.4 (6.26) | 67.6 (3.38) | 63.1 (3.23) |
표 8. SDAR-1.7B b32 at $T{=}1$ (coupled-noise match; free chain also under rejection sampling). Lowest NFE in every comparison and the higher throughput ratio in all but one of $32$ (Spiffy takes MATH500 at $D20$); SPOT-$\gamma$ wins every comparison on both columns. Seed $0$. Lower block: the threshold decoder ($\tau{=}0.9$), second machine, main_sdar17_t1, SPOT-Sets rows and ratios as in Table .
| NFE$\downarrow$ (tok/s$\uparrow$) | GSM8K | MBPP | HumanEval | MATH500 | ||||
|---|---|---|---|---|---|---|---|---|
| acc.\ 0.69–0.74 | acc.\ 0.21–0.29 | acc.\ 0.37–0.45 | acc.\ 0.09–0.12 | |||||
| method | $D8$ | $D20$ | $D8$ | $D20$ | $D8$ | $D20$ | $D8$ | $D20$ |
| no draft ($D0$) | 270.8$\downarrow$ (1.00$\uparrow$) | 269.2$\downarrow$ (1.00$\uparrow$) | 271.4$\downarrow$ (1.00$\uparrow$) | 271.8$\downarrow$ (1.00$\uparrow$) | ||||
| SPOT (ours) | 79.0 (2.67) | 62.3 (2.86) | 58.0 (3.52) | 40.9 (3.99) | 66.7 (3.14) | 48.5 (3.49) | 88.9 (2.39) | 71.7 (2.48) |
| SPOT-$\gamma$ (ours) | 79.9 (2.67) | 66.6 (3.04) | 58.7 (3.54) | 43.7 (4.54) | 67.5 (3.15) | 51.5 (3.85) | 89.8 (2.40) | 76.3 (2.78) |
| Spiffy graph | 99.5 (2.37) | 82.7 (2.73) | 87.7 (2.68) | 67.3 (3.33) | 93.0 (2.54) | 72.4 (3.15) | 105.5 (2.28) | 90.1 (2.57) |
| free chain, match | 98.9 (2.36) | 92.8 (2.44) | 93.6 (2.47) | 78.7 (2.79) | 92.9 (2.50) | 84.6 (2.62) | 104.8 (2.31) | 99.0 (2.29) |
| free chain, RS | 99.4 (1.62) | 97.0 (1.47) | 71.5 (2.29) | 67.4 (2.13) | 87.6 (1.87) | 81.7 (1.74) | 115.7 (1.43) | 115.5 (1.26) |
| BlockSpec tree | 141.5 (1.60) | 121.3 (1.67) | 137.4 (1.62) | 114.2 (1.72) | 138.5 (1.66) | 116.3 (1.74) | 141.7 (1.63) | 122.3 (1.70) |
| 0.6pt2.5pt0pt threshold decoding, $\tau{=}0.9$ (second machine, $n{=}350$, HumanEval $164$) | ||||||||
| $T{=}1$ | acc.\ 0.69–0.72 | acc.\ 0.21–0.23 | acc.\ 0.35–0.37 | acc.\ 0.10–0.12 | ||||
| no draft | 88.4$\downarrow$ (3.01$\uparrow$) | 42.7$\downarrow$ (6.24$\uparrow$) | 52.5$\downarrow$ (5.11$\uparrow$) | 97.4$\downarrow$ (2.74$\uparrow$) | ||||
| SPOT-Sets-$\gamma$ (ours) | 48.3 (4.32) | 47.7 (4.36) | 26.8 (8.09) | 26.4 (8.00) | 30.1 (7.20) | 30.0 (7.16) | 56.8 (3.74) | 55.9 (3.77) |
| SPOT-Sets-$\gamma$, exact (ours) | 51.0 (4.24) | 50.2 (4.25) | 27.4 (8.10) | 27.2 (8.10) | 31.8 (6.97) | 31.8 (6.92) | 59.8 (3.68) | 58.8 (3.74) |
| Spiffy graph | 59.5 (3.86) | 58.9 (3.86) | 29.6 (8.00) | 29.1 (7.95) | 38.3 (6.24) | 38.0 (6.17) | 70.0 (3.34) | 68.8 (3.31) |
| SSD free chain | 58.7 (3.91) | 58.1 (3.72) | 29.1 (8.06) | 28.7 (7.81) | 37.9 (6.27) | 37.5 (6.06) | 69.6 (3.33) | 68.7 (3.14) |
| BlockSpec tree | 63.0 (3.53) | 59.9 (3.29) | 31.4 (7.29) | 29.7 (6.91) | 39.9 (5.77) | 38.2 (5.51) | 72.7 (3.09) | 69.8 (2.84) |
이 글의 그림은 arXiv:2610.22543 원본에서 가져왔습니다 (CC BY 4.0). 크기와 형식만 바꿨습니다.
댓글