큰 청크를 유지하면서도 즉시 반응하기: 인터랙티브 영상 생성의 투기적 샘플링
시청자가 카메라 조작이나 행동 지시를 바꾸면, 재생 중인 영상이 곧바로 바뀌어야 한다. 그런데 영상 생성 모델이 아무리 빨라도 새 조건은 청크 단위로만 화면에 반영되어, 사용자는 그 경계까지 기다린다. 이 논문은 큰 크기로 생성하되 출력 확정은 잘게 나누는 투기적 샘플링으로, 경계가 만드는 대기 하한을 없앤다.
1. 왜 빠른 생성만으로는 부족한가
1.1 이 시스템이 실제로 하는 일
인터랙티브 영상 서빙은 두 가지가 동시에 도는 구조다. 플레이어는 이미 계산된 버퍼를 소비해 화면에 내보내고, 생성기는 다음 구간을 미리 계산해 버퍼를 채운다. 그 사이에서 새로운 조건(카메라 지시, 행동 명령 등)이 온라인으로 도착한다.
이 논문이 다루는 모델은 잠재 프레임(latent frame) 단위로 계산한다. 잠재 프레임은 비디오 오토인코더(VAE)가 픽셀 프레임을 압축해 만든 표현이고, 디퓨전 트랜스포머(DiT)가 이 잠재 프레임들을 여러 노이즈 제거 단계에 걸쳐 샘플링한다. 한 번의 DiT 호출이 함께 만드는 잠재 프레임의 개수를 청크 크기 K라고 하며, 청크 안은 시간 양방향 attention으로 함께 모델링하고 청크 사이는 자기회귀적으로 이어 붙인다.
한 잠재 프레임이 픽셀 프레임 $r$개를 대신하고 영상의 시간 프레임레이트가 $f$라면, 잠재 프레임 하나가 담당하는 시간은 $\delta = r/f$이고 청크 하나는 $T = K\delta = Kr/f$초를 덮는다. 이 $T$가 곧 “얼마나 오래 한 묶음을 갱신 주기로 삼는가"다.
1.2 반응 지연을 세 구간으로 나누기
조건이 $t_{arrival}$에 도착해 $t_{start}$에 생성이 시작되고, $t_{ready}$에 첫 출력이 준비되어 $t_{playback}$에 화면에 뜬다고 하자. 이때
$$ L = R + C + Q $$이며 각 항은 서로 다른 병목을 가리킨다. $R$은 생성이 시작되기 전의 대기이고, $C$는 첫 출력을 만드는 계산 시간으로 DiT 샘플링과 필요한 VAE 디코딩을 포함하며, $Q$는 준비된 출력이 재생 구간에 들어갈 때까지의 대기다. (§3.1, 식 (1))
이렇게 나눠 두는 이유는 해법이 단계마다 다르기 때문이다. $C$는 샘플링 스텝 축소나 병렬화 같은 가속 기술의 대상이고, $R$은 스케줄링과 자원 배분의 대상이며, $Q$는 재생 확정 주기의 대상이다. “모델이 빠르다"는 말은 $C$에 대한 말일 뿐, 시청자가 느끼는 $L$ 전체에 대한 말이 아니다.
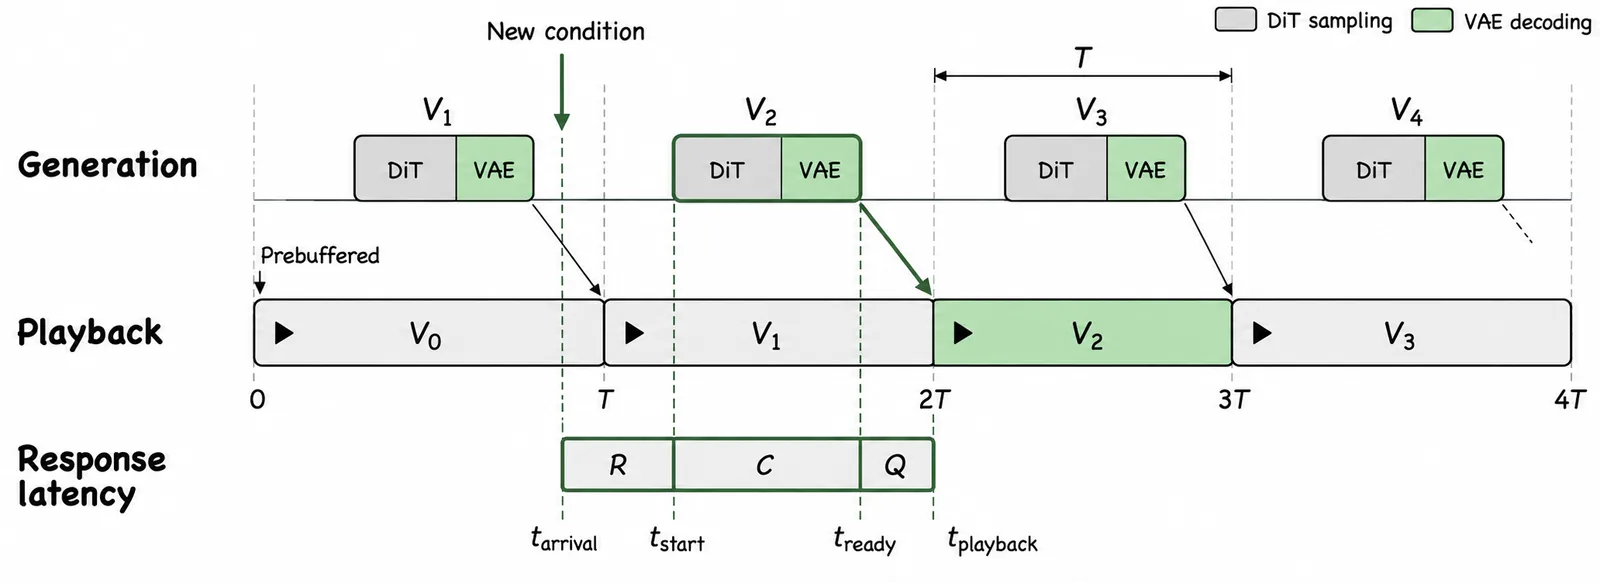
(원문 Figure 2) 주기적 기준 스케줄에서 강조된 갱신 하나가 $R$만큼 기다린 뒤 $C$만큼 생성하고 $Q$만큼 더 기다린 뒤 표시되는 구간을 그린다. 각 청크는 다음 재생 구간에 맞춰 준비되고, 첫 구간 $V_0$는 미리 버퍼에 넣어 둔다. 생성이 끝나도 재생 경계까지는 기다려야 하므로, 생성 시간만으로 응답 지연이 정해지지 않는다.
1.3 경계 대기는 생성 속도와 무관하게 남는다
기존 방식처럼 새 조건이 적용된 출력을 고정된 청크 재생 경계에서만 화면에 넣을 수 있다고 하자. 생성 시간 $C$가 고정이고 도착 위상이 균등할 때, 정렬 때문에 생기는 두 대기 구간의 합은 $E[R+Q] \ge T/2$, 따라서 $E[L] \ge C + T/2$다. (§3.4, 식 (4); Appendix A.1 Proposition 1)
이 하한의 뜻을 정확히 짚을 필요가 있다. 하한은 평균 결합 대기에 대한 것이지 요청별·구성요소별 하한이 아니다. $E[R+Q] \ge T/2$는 합에 대한 하한이며, $E[R]$과 $E[Q]$ 각각에 대한 하한이 아니다. 기다림이 생성 전($R$)이나 생성 후($Q$) 어느 쪽에 몰려 생겨도 합은 같다. 또한 하한은 생성 시간이 0이어도 사라지지 않는다.
1.4 작은 예시: 숫자로 확인하기
숫자를 하나씩 넣어 보자. 초당 24프레임($f=24$)이고 잠재 프레임 하나가 4픽셀프레임을 표현한다면($r=4$), 잠재 프레임 하나는 $\delta = r/f = 4/24 \approx 0.17$초를 담당한다. 청크를 $K=4$로 잡으면 $T = K\delta \approx 0.67$초이고, 정렬 대기는 평균 $T/2 \approx 0.33$초씩 발생한다. 즉 DiT를 0초 만에 끝내도 시청자는 평균 0.33초를 기다린다.
(이것은 설명용 가정이며 논문의 실측 수치가 아니다. 실제 모델의 $r$·$f$와 무관하게 $T = Kr/f$에 대입한 산술 예시다.)
1.5 그러면 청크를 줄이는 게 답인가
하한을 줄이는 직접적인 손은 $T = Kr/f$를 줄이는 것이다. 고정된 $r$에서 더 작은 $K$를 쓰거나 더 높은 시간 프레임레이트를 쓰면 된다. 하지만 논문의 예비 실험은 반대 방향을 가리킨다. 큰 청크 설정이 대체로 더 좋은 화질을 보이고 GPU 병렬성도 잘 활용해, 샘플링 시간은 조금만 늘면서 더 많은 잠재 프레임을 만들 수 있었다. (§1, §4.2)
여기서 논문의 중심 질문이 나온다. 반응성을 얻으려면 양방향 모델링 창을 반드시 줄여야 하는가. 답은 “아니오"이며, 청크를 줄이는 대신 청크 경계에서 확정한다는 관습 자체를 바꿔야 한다.
2. 방법: 투기적 샘플링
2.1 생성 단위와 확정 단위를 분리한다
핵심은 두 개의 크기를 떼어 놓는 것이다. 모델이 한 번에 얼마나 많이 함께 예측하는가($K$, 생성 단위)와, 시스템이 한 번에 얼마나 잘게 출력을 확정하는가($q$, 전달 단위)다. **전달 단위 $q$**는 함께 전송되는 잠재 프레임의 수를 뜻하며, 이 논문은 $q=1$을 쓴다. 즉 잠재 프레임 하나씩 내보낸다.
이 분리 덕분에 “화질은 큰 창에서, 반응성은 작은 창에서"를 동시에 취할 수 있다.
2.2 한 번 계산한 미래를 다시 쓰고, 필요할 때만 갈아 끼운다
동작 순서는 다음과 같다.
- DiT를 한 번 호출해 $K$개 잠재 프레임을 함께 샘플링한다. 다음에 내보낼 잠재 프레임 1개에 $K-1$개의 노이즈 잠재를 패딩으로 덧붙여, $K$개 잠재를 하나의 양방향 창으로 함께 만든다. (§3.2, 식 (2))
- 덧붙여서 얻은 예측을 버리지 않고 예측 캐시에 저장한다. 캐시 항목에는 소스/재생 위치 대응과 조건 버전이 함께 기록되므로, 뒤이어 오는 호출의 상태와 독립적으로 관리된다.
- 조건이 그대로면 캐시를 그대로 꺼내 순서대로 재생한다. 추가 샘플링은 없다.
- 조건이 바뀌면 이미 확정된 앞부분(잠긴 접두부)만 남기고, 아직 확정되지 않은 뒤쪽만 버린 뒤 새 조건으로 $K$개를 통째로 다시 샘플링한다. 새 샘플을 옛 청크의 남은 길이에 맞춰 짧게 만들지는 않는다.
- 출력 확정은 내용을 교체 불가로 만드는 행위이며, 실제 재생보다 먼저 일어날 수 있다. 큰 청크는 재사용 가능한 미래를 제공하고, 컨트롤러는 그 미래를 필요할 때까지 교체 가능하게 붙들고 있는다.
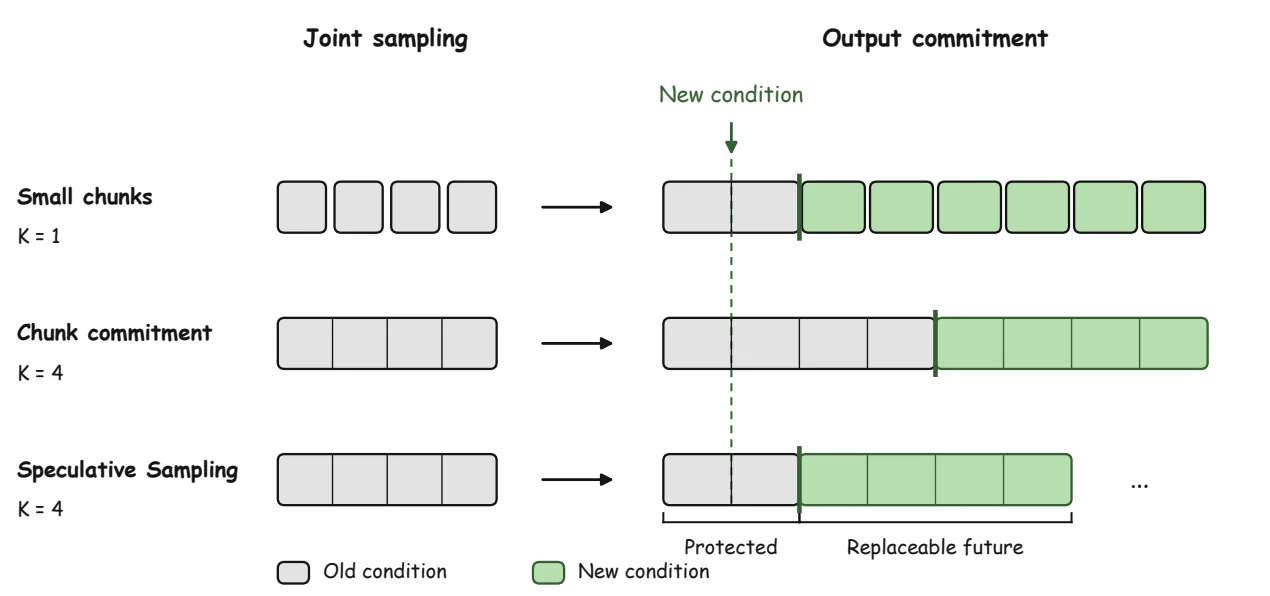
(원문 Figure 1) 세 경우를 나란히 비교한다. 작은 청크($K=1$), 청크 단위 확정($K=4$), 투기적 샘플링($K=4$)이다. 회색은 옛 조건, 녹색은 새 조건이고, 굵은 녹색 선분이 갱신된 출력이다. 점선은 조건이 도착한 시점의 재생 위치이며, “Protected” 구간은 되돌릴 수 없게 확정된 앞부분, “Replaceable future"는 교체 가능한 뒤쪽을 가리킨다. 가로 위치는 계산 시간이 아니라 영상의 내용 위치를 나타낸다. 즉 큰 청크로 함께 샘플링하면서, 보호된 접두부 너머의 교체 가능한 미래만 갈아 끼운다는 뜻이다.
2.3 작은 예시로 따라가기
$K=4$, $q=1$이고, 한 번의 DiT 호출이 잠재 프레임 1·2·3·4를 함께 만든다고 하자.
| 시점과 입력 | 잠긴 앞부분 (확정, 교체 불가) | 예측 캐시 (교체 가능) | 버려진 것 | 화면으로 나가는 출력 |
|---|---|---|---|---|
| DiT 1회 호출 완료 | (없음) | 2, 3, 4 | (없음) | 1을 픽셀로 디코딩해 재생 |
| 1 재생 완료, 2를 재생하는 중 새 조건 도착 | 1, 2 | 재샘플링 중 (3, 4 무효) | 3, 4 | 2 (이미 확정한 내용이므로 그대로 재생) |
| 새 조건으로 $K=4$ 재샘플링 완료 | 1, 2 | 3′, 4′, 5′, 6′ | (없음) | 3′을 재생, 이후 4′ → 5′ → 6′ 순으로 |
읽는 법은 이렇다. 1과 2는 확정되어 지워지지 않고, 3·4는 새 조건이 들어온 순간 버려졌다가 새 값(3′, 4′)으로 대체되며, 새 샘플은 옛 청크의 남은 길이에 맞춰 줄이지 않고 항상 $K$개 전체로 만들어진다. 5′·6′는 아직 아무도 소비하지 않은 미래라서, 조건이 또 바뀌면 이것도 버려질 수 있다.
(설명용 예시이며 실제 컨트롤러의 경계·상태 결정과 세부가 다를 수 있다.)
2.4 Produce와 Consume 두 상태로 조율하기
위 흐름을 실제 시스템에서 돌리려면 어떤 일이 언제 일어나는지 정해야 한다. 논문은 이 조율을 확장 유한 상태 기계(FSM)로 만든다. 제어 상태는 둘뿐이고, 재생은 두 상태 모두에서 계속된다. (§3.2, Appendix C)
| 상태 | 이 상태가 뜻하는 것 | 이 상태에서 실제로 일어나는 일 |
|---|---|---|
| Produce | 생성 작업 하나가 돌고 있음 | DiT를 호출해 $K$개 잠재 프레임을 만들고, 완성된 잠재 프레임을 VAE로 디코딩해 픽셀로 바꾸고, 준비된 묶음을 정해진 재생 경계에 내보낸다 |
| Consume | 돌고 있는 작업이 없음 | 캐시에 남은 예측을 순서대로 꺼내 재생하고, 픽셀로 변환해 전송한다 |
이벤트는 다섯 종류다. 조건 도착, 출력/상태 준비, 작업 완료, 재생 틱, 재충전·재시도 웨이크업이다. 각 이벤트가 일어나면 컨트롤러는 레지스터를 갱신한 뒤, 실행 가능한 분기 경계가 있는지 확인해 새 작업을 시작할지 결정한다.
| 이벤트 | 컨트롤러가 하는 일 | 상태에 미치는 변화 |
|---|---|---|
| 조건 도착 | 보류 조건 버전만 기록한다. 돌고 있는 작업은 중단하지 않는다. | Produce 자기 루프. 보류 갱신이 여러 개면 최신 버전으로 합치고, 버려진 버전은 ‘대체됨’으로 남긴다 |
| 작업 완료 | 결과를 검증하고 슬롯을 비운다 | 다음 작업을 시작할 조건이 있으면 Produce 유지, 없으면 Consume으로 전환 |
| 재생 틱 | 다음으로 내보낼 준비된 묶음을 재생하고 재생 커서를 전진시킨다 | 상태를 바꾸지 않는다. 틱 자체는 DiT 샘플링을 요구하지 않는다 |
| 유휴 상태에서 갱신 대기 | 잠긴 접두부 뒤, 조건 입력이 준비되고, VAE 연속성이 유효하고, 남은 재생 마감 시각을 맞출 수 있는 위치 중 가장 이른 곳을 골라 그 뒤만 교체한다 | Consume → Produce. 실행 불가능한 요청은 유용한 예측을 버리지 않고 보류로 남긴다 |
| 재충전 조건 충족 | 남은 재생 가능 길이가 예상 계산 리드보다 짧아지면 새 청크를 덧붙인다 | Consume → Produce |
(유휴 상태에서는 갱신 재계획과 정상 재충전은 별개의 사유로 작업을 시작시킨다. 보류 버전이 있다는 사실만으로 작업이 시작되지는 않는다.)
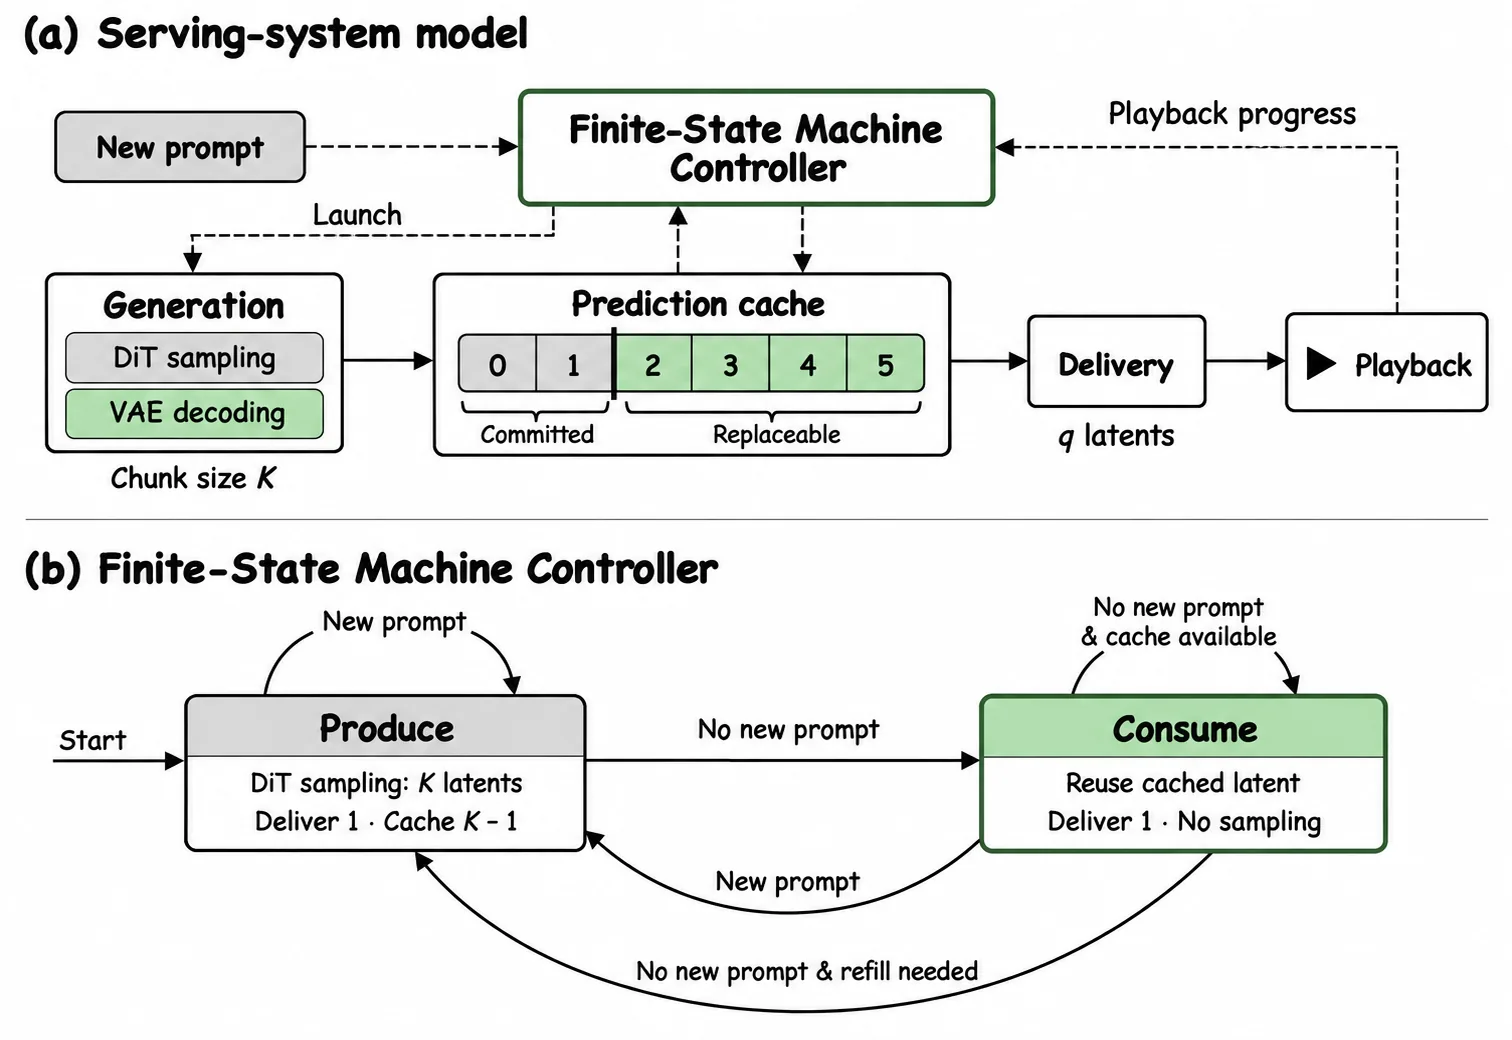
(원문 Figure 3) (a)는 공동 생성이 예측 캐시를 채우고, 재생 진행이 채워야 할 시점을 알려주는 구조다. (b)는 $q=1$일 때 Produce(생성 중)와 Consume(예측 재사용) 두 상태의 FSM이다. 조건 갱신은 돌고 있는 생성을 멈추지 않고 실행 가능한 재계획만 유발하며, 재생은 두 상태 모두에서 이어진다.
2.5 양방향 모델을 스트리밍에 붙이는 일
양방향 생성기는 보통 이미지·비디오 조건부 연속(continuation) 인터페이스를 제공한다. 시간 압축형 3D VAE를 쓰면 이 인터페이스가 기대하는 ‘시간적으로 압축되지 않은 첫 프레임 잠재’와, 캐시된 내부 프레임이 압축된 그룹에 속한다는 사실이 부딪힌다.
논문은 잡아 둔 경계를 픽셀로 디코딩한 뒤, 그 마지막 프레임을 VAE의 첫 프레임 경로로 다시 인코딩해 다음 DiT 호출에 넘긴다. 그러면 사전학습된 연속 인터페이스가 기대하는 형식과 맞아떨어진다. 대안으로는 압축된 잠재 연속을 직접 받도록 모델을 파인튜닝하는 방법을 든다. (§3.3)
2.6 무엇이 사라지고 무엇이 남는가
조건이 도착했을 때 준비된 접두부가 즉시 있고 추가 버퍼 제약이 없다면, 첫 표시는 잠재 프레임 경계에 맞춰진다.
$$ t_{playback} = \delta \left\lceil \frac{t_{start} + C}{\delta} \right\rceil, \qquad Q = t_{playback} - (t_{start}+C), \qquad 0 \le Q < \delta $$즉 정렬이 청크($T$)가 아니라 전달 단위($q=1$, 한 잠재 프레임)에 묶인다. (§3.4, 식 (5))
이상적 조건에서는 $E[L]$이 $C + \delta/2$까지 내려간다(Appendix A.2). 다만 균등한 도착이 균등한 완료 위상을 보장하지는 않는다. $R \ne 0$이면 $(t_{arrival}+R+C) \bmod \delta$가 특정 값에 몰릴 수 있어, 실제 $E[Q]$는 파이프라인 타이밍으로 정해진다. 정렬 대기만 줄고 계산 자체는 그대로라는 뜻이다.
남는 것은 생성과 그 잔여 대기다. 한 작업이 주기 $T$마다 $C$초를 온전히 점유하고($C \le T$), 그 작업이 새 분기에 필요한 접두부를 제공해야 하며, 도착이 균등할 때
$$ E[R] = \frac{C^2}{2T}, \qquad E[L] = C + \frac{C^2}{2T} + E[Q] $$가 된다. (§3.4, 식 (6), Appendix A.3)
논문의 산출 예시로 $T=5$초, $C=1.6$초를 넣으면 잔여 대기는 평균 0.256초다. $Q$를 제외하면 유휴 상태 도착은 1.6초, 작업 중 도착은 평균 2.4초, 무조건 평균은 1.856초다. (영상 시스템 측정이 아니라 계산 예시다.)
이 식이 말하는 방향 전환은 분명하다. 반응성을 위한 목표가 ‘청크($T$)를 줄이는 것’에서 ‘첫 출력의 생성 시간 $C$를 줄이는 것‘으로 옮겨간다. DiT 샘플링 가속과 병렬 가속의 이득도 $C$와 총 자원 비용을 통해 측정된다.
2.7 다시 계산하는 비용
비용 면에서도 주장은 구체적이다. 조건이 바뀌지 않으면 예측을 재사용하므로, 정상 상태에서 DiT 샘플링 호출 횟수는 대응되는 청크 단위 기준선과 같다. 잘게 전달한다고 샘플링이 늘지 않는다. 다만 재생 가능한 구간이 얼마 되지 않으면 정상적인 재충전은 여전히 필요하다.
조건이 바뀔 때만 버려진 예측만큼 추가 작업이 생긴다. 각 호출이 같은 비용으로 $K$개의 유용한 잠재 그룹을 만들고, 결국 재생되지 못하고 버려지는 비율을 $w$라 하면 상대 DiT 샘플링 작업량은
$$ A \simeq \frac{1}{1-w} $$다. (§3.4, 식 (7), Appendix B)
갱신이 드물면 이 오버헤드는 작다. Appendix B.2의 독립 갱신 모델은 갱신 확률이 $p$일 때 $A = \frac{Kp}{1-(1-p)^K}$, 포아송 도착률 $\lambda$에 대해 $\lambda T \ll 1$이면 $A - 1 \simeq \frac{\lambda(T-\delta)}{2}$로 낮아짐을 예측한다. 다만 $w$는 갱신 빈도만이 아니라 청크 크기와 선택된 분기 위치에도 의존하며, VAE 디코딩·어댑터 준비·오버랩 절단·중단된 작업·캐시 재구성은 별도 비용 계산이 필요하다.
3. 결과
실험은 두 층위로 나뉜다. 하나는 청크 크기가 화질과 단일 순방향 시간에 미치는 영향이고, 다른 하나는 실제 서빙에서 조건 도착부터 화면 표시까지의 끝단 대기다. 둘은 서로 다른 것을 측정하므로 따로 본다. (§4)
주의할 점 하나. §4.1의 순방향 시간 프로파일은 통신과 출력 수집은 포함하지만 텍스트 인코딩·VAE 디코딩·샘플러 루프는 제외한 shape 수준 측정이며, 생성 시간 $C$와는 다르다. (§4.1)
3.1 청크 크기는 화질–효율 트레이드오프다
Wan1.3B는 Toy6K로 $K \in \{1,3,7,21\}$를 각각 따로 학습하고(1/2/4스텝 샘플링), VBench로 81프레임·16fps 영상을 832×480과 1280×720에서 946개 프롬프트·5개 시드로 평가했다. (§4.1)
같은 스텝 수·해상도에서 $K>1$이 대체로 $K=1$보다 높은 VBench 총점을 얻는다.
| 스텝 / 해상도 | $K=1$ | $K=3$ | $K=7$ | $K=21$ |
|---|---|---|---|---|
| 4스텝 480p | 79.00 | 81.66 | 81.70 | 82.13 |
| 4스텝 720p | 78.84 | 81.59 | 81.86 | 81.65 |
(원문 Table 1의 VBench 총점. 이득은 단조 증가하지 않아 최적 $K$는 설정마다 다르다. 화질은 청크 크기별로 별도로 학습된 모델에서 측정됐다.)
!청크 크기에 따른 화질(VBench)과 H200 순방향 시간](/assets/images/papers/2610.20556/final-71f9a6ae.webp)
(원문 Figure 5) (a)는 해상도 832×480과 1280×720에서의 Wan 4스텝 VBench 총점이고, (b)는 480p에서 USP1·2·4·8별 H200 단일 forward 지연이다. 화질은 별도 학습 설정, 시간은 공유 체크포인트와 합성 입력 기준이다.
동시에 커널 순방향 시간은 생각보다 덜 늘어난다. $K$를 1에서 3으로 늘리면 현재 청크의 잠재 프레임 수는 3배가 되지만, 순방향 시간은 480p에서 2.05배, 720p에서 2.74배 늘 뿐이다.
| 해상도 | $K$ | USP1 | USP2 | USP4 | USP8 |
|---|---|---|---|---|---|
| 480p | 1 | 77.5 | 63.7 | 65.9 | 72.1 |
| 480p | 3 | 159.2 | 91.5 | 67.0 | 72.9 |
| 480p | 7 | 358.3 | 194.7 | 105.2 | 78.6 |
| 480p | 21 | 1406.2 | 750.0 | 384.1 | 211.0 |
| 720p | 1 | 218.7 | 143.4 | 95.8 | 72.7 |
| 720p | 3 | 599.6 | 318.4 | 166.5 | 119.4 |
| 720p | 7 | 1521.4 | 809.2 | 443.8 | 276.4 |
| 720p | 21 | 6432.8 | 3335.5 | 1737.1 | 899.7 |
(원문 Table 2(a), H200 단일 forward ms. 30회 동기화 forward의 가장 느린 랭크 중앙값, 워밍업 10회 제외.)
병렬성을 키우면 효과는 더 커진다. 480p의 $K=7$은 USP8에서 78.6ms로 USP1의 $K=1$(77.5ms)에 근접하고, 720p의 $K=21$은 USP1의 6432.8ms에서 USP8의 899.7ms로 떨어진다. 다만 GPU를 늘린다고 항상 좋아지는 것은 아니다(480p $K=1$은 USP2 63.7ms가 USP8 72.1ms보다 빠르다). 적절한 병렬성이 큰 청크를 효율적으로 유지한다.
LTX-2.3도 같은 방향을 보인다. $K \in \{1,3,9,15,45\}$를 3스텝으로 각각 학습하고 Internal32(832×448, 24fps, 361프레임 출력)에서 평가했다. $K=45$의 cached-forward는 USP1 2016.2ms에서 USP8 507.9ms로 내려간다. 다만 LTX는 여섯 개 VBench 시각 점수(주체 일관성, 배경 일관성, 심미성, 영상 품질, 매끄러움, 동적성)를 100배로 보고 합산 총점 없이 제시하므로, LTX에서 “가장 좋은 $K$“를 하나의 숫자로 읽어낼 수는 없다. (원문 Table 2(b))
3.2 큰 청크도 실제 서빙에서는 빠르다
비교 조건을 먼저 고정해야 한다. (§4.1)
- Wan1.3B: 짧은/긴 청크를 K3/USP4(4×B300)와 K21/USP8(8×B300)로, VAE는 별도 GPU 파이프라인, 832×480.
- Sol-H3: 22·124프레임 제안으로 USP4/USP8(4/8×B300), 832×480, 24fps.
- LTX-2.3: 짧은 청크는 K3/USP1(eager 또는 CUDA Graph), 긴 청크는 K15/USP2(eager), 832×448, 24fps, 텍스트·미디어 GPU 분리.
같은 짧/긴 설정 안에서 Baseline(청크 경계 단위 확정)과 투기적 샘플링은 모델 배치, 연속 인터페이스, 디코딩, 재생, 스케줄링 선행 시간을 공유한다. 각 설정은 60초 트레이스 30개를 저빈도(트레이스당 1–2회 갱신)와 고빈도(3–11회)로 받는다. L50/L95는 최소 RTT 기반 클록 정렬 후 ‘조건 도착→표시’ 응답의 50·95 백분위수(초)이고, stall은 60초 창에서 재생 언더런이 차지한 비율(%)이다. LTX의 긴 청크 구현은 CUDA Graph 캡처를 지원하지 않아 청크 크기 비교는 eager 기준이다.
긴 청크 설정을 두 확정 방식으로 비교하면 다음과 같다.
| 모델 (긴 청크) | 방식 | 저빈도 L50 / L95 | 고빈도 L50 / L95 |
|---|---|---|---|
| Sol-H3 | Baseline | 4.49 / 6.44 | 4.45 / 6.59 |
| Sol-H3 | 투기적 샘플링 | 1.42 / 2.47 | 1.41 / 1.95 |
| Wan1.3B | Baseline | 3.23 / 4.64 | 3.11 / 4.66 |
| Wan1.3B | 투기적 샘플링 | 1.32 / 1.91 | 1.35 / 1.63 |
| LTX-2.3 (eager) | Baseline | 4.82 / 6.99 | 5.09 / 6.98 |
| LTX-2.3 (eager) | 투기적 샘플링 | 2.39 / 4.13 | 2.39 / 4.24 |
(원문 Table 3의 긴 청크 행. 모두 480p급.)
세 모델 모두 긴 청크에서 투기적 샘플링의 L50이 baseline의 절반 이하로 줄었다.
여기에 여유도 함께 생긴다. GPU당 커널 활동률(시간 가중 평균)은 긴 설정에서 Wan 17–20%(짧은 청크 50–52%), Sol-H3 18–23%(짧은 청크 49–50%)로 크게 낮아지고, LTX eager는 21–25%로 짧은 청크(22–23%)와 비슷하다. 이 유휴는 동시에 더 많은 스트림을 서빙할 여지로 읽힌다. 고빈도 갱신에서 활동률 증가가 다소 크지만 긴 설정은 20–25% 이내에 머문다. 측정 범위는 모델별로 달라 Wan은 DiT GPU만, LTX는 텍스트·미디어 GPU를 포함한다.
가장 눈에 띄는 결과는 Sol-H3다. 긴 청크에 투기적 샘플링을 쓰면 L50이 저/고빈도 1.42/1.41초로, 작은 청크 baseline의 1.87/1.87초보다 낮으면서 재생 정지(stall)도 0.000%다. 큰 양방향 창을 유지하는 것이 반응성을 포기하는 길이 아니라는 직접 보여 주는 사례다.
재생을 멈추는 경우는 LTX에서 두드러진다. LTX의 짧은 청크 eager 실행은 재생 언더런이 저빈도 19.669%, 고빈도 20.339%로 측정된다. CUDA Graph 변형으로 바꾸면 baseline은 0.005%/0.021%로 내려가지만, 같은 변형의 투기적 샘플링은 1.781%/4.407%로 남는다. 긴 청크에서는 Baseline 0.069%/0.065%, 투기적 샘플링 0.204%/0.524%로 낮게 유지된다. 짧은 eager에서는 baseline과 투기적 샘플링이 19%대 후반으로 비슷해, 이 실행 모드에서는 확정 방식의 차이가 stall을 크게 바꾸지 못했다.
3.3 예측과 실측이 맞는다
평균 응답 감소를 이론과 겹쳐 보면 경계 대기 모델이 실제로 작동한다고 볼 수 있다. Sol-H3의 실측 감소는 짧/긴 설정에서 0.493/2.814초로, 이론 예측 0.438/2.562초에 가깝다. 감소 폭이 청크 크기에 따라 커지는 경향도 예측과 일치한다. Wan은 0.155 → 1.744초, LTX eager는 0.014 → 2.116초로, ‘큰 청크일수록 제거할 경계 대기가 많다’는 예측을 따른다. (§4.3)
또 하나의 요약 수치가 있다. 투기적 샘플링 적용 시 긴 설정의 L50은 같은 모델의 짧은 설정보다 0.26–0.39초 높은 수준에 그친다(세 모델, 두 요청 부하 모두). 즉 큰 청크를 써도 반응성 손실은 사실상 0.3초 수준으로 억제된다.
4. 한계와 언제 쓸 것인가
저자가 직접 인정한 한계는 두 가지다.
첫째, 예측은 새 조건이 무효화하기 전에 재사용될 때만 이득이다. 갱신이 잦거나 연속적이면 청크의 많은 부분이 버려져 DiT 연산을 낭비한다. $w$는 갱신 빈도만이 아니라 청크 크기와 선택된 분기 위치에도 의존한다.
둘째, 청크 안의 양방향 attention 때문에 유지된 KV가 나중에 버려진 뒤쪽 내용의 정보를 담고 있을 수 있다. KV 항목을 지워도 재생성된 연속부에 그 영향이 남을 수 있다. (§5)
리뷰어 관점에서 덧붙이면 제약이 몇 가지 있다.
- 실험이 다루는 갱신 빈도는 60초 트레이스당 1–2회와 3–11회 두 구간뿐이다. 시청자가 화면을 연속적으로 조작하는 상황은 검증되지 않았다.
- L50/L95는 ‘조건 도착부터 표시까지’를 잰다. 조건 효과가 눈에 보이게 인식되는 의미적 응답(semantic response) 시점은 별도 측정으로 남겨져 있다(Appendix D).
- 실제 배포에서 $R$과 $Q$를 따로 계측한 값과, 예측 재사용이 실제로 일어난 비율 $w$의 실측값은 원문에 보고되어 있지 않다(원문 미보고). $A \simeq 1/(1-w)$는 샘플링 호출 회계식이며, $w$의 실측값이 아니다.
- 결과는 세 모델의 특정 청크·해상도·GPU 구성에서 확인된 것이므로, 다른 프레임율·VAE·백본에서 그대로 성립한다고 단정하기 어렵다. VAE 첫 프레임 경로 재인코딩이 만드는 부가 비용도 별도 비용 계산 대상이다.
운영 환경에서 언제 쓸 만한지는 이 분석에서 읽힌다. 갱신이 간헐적인 시나리오, 예컨대 한 씬 안에서 가끔 명령이 바뀌는 경우(실험 트레이스도 씬 안에서 행동을 바꾼다)에 가장 잘 맞는다. 큰 양방향 모델을 스트리밍 후학습 없이 서빙하고 싶을 때도 유망하다. 반대로 조건이 계속 변하거나, GPU 여유가 없어 $C$가 $T$에 근접하는 환경에서는 이득이 줄어든다. 극한인 $C=T$에서는 생성 워커가 항상 바빠 $E[R]=T/2$, $Q=0$이 되어 평균 $L$이 여전히 $3T/2$로, 고정 청크 경계 기준선과 같아진다(Appendix A.3). 세밀한 전달만으로는 개선되지 않는다.
이 방법은 결국 설계의 무게중심을 옮긴다. 청크 크기를 줄여야 한다는 고정된 제약을 걷어 내고, 대신 화질과 반응성을 함께 조절하는 결정 변수로 되돌린다. 최적화의 무게중심은 남은 병목인 $C$, 첫 출력의 생성 시간을 줄이는 쪽으로 옮겨진다.
논문 원문의 표
arXiv e-print 의 LaTeX 원본에서 기계적으로 옮긴 표입니다. 숫자는 논문의 값이며 모델을 거치지 않았습니다.
표 1. Wan1.3B quality measurements. Total is the reported VBench aggregate, with its quality and semantic components; the table also includes dynamic degree, VisionReward, and instruction following.
| Resolution | Steps | $K$ | Total | Quality | Semantic | Dynamic | VisionReward | Instruction |
|---|---|---|---|---|---|---|---|---|
| 480p | 1 | 1 | 79.11 | 81.80 | 68.34 | 4.00 | 6.50 | 90.00 |
| 1 | 3 | 80.38 | 83.40 | 68.29 | 58.00 | 4.81 | 94.00 | |
| 1 | 7 | 81.35 | 83.97 | 70.86 | 48.00 | 5.79 | 100.00 | |
| 1 | 21 | 81.68 | 84.83 | 69.08 | 85.00 | 9.93 | 94.00 | |
| 2 | 1 | 80.07 | 82.76 | 69.34 | 14.00 | 9.31 | 98.00 | |
| 2 | 3 | 81.62 | 84.63 | 69.57 | 57.00 | 9.82 | 100.00 | |
| 2 | 7 | 80.84 | 84.06 | 67.94 | 93.00 | 9.29 | 100.00 | |
| 2 | 21 | 81.84 | 84.62 | 70.74 | 71.00 | 10.17 | 100.00 | |
| 4 | 1 | 79.00 | 81.38 | 69.50 | 13.00 | 7.65 | 96.00 | |
| 4 | 3 | 81.66 | 84.70 | 69.51 | 80.00 | 9.64 | 100.00 | |
| 4 | 7 | 81.70 | 84.73 | 69.56 | 78.00 | 10.19 | 98.00 | |
| 4 | 21 | 82.13 | 85.03 | 70.54 | 85.00 | 9.66 | 98.00 | |
| 720p | 1 | 1 | 78.94 | 81.37 | 69.19 | 4.00 | 5.82 | 92.00 |
| 1 | 3 | 79.99 | 82.70 | 69.18 | 47.00 | 3.93 | 98.00 | |
| 1 | 7 | 80.78 | 83.05 | 71.67 | 41.00 | 5.23 | 96.00 | |
| 1 | 21 | 80.49 | 83.10 | 70.04 | 67.00 | 9.56 | 100.00 | |
| 2 | 1 | 79.86 | 82.40 | 69.70 | 9.00 | 9.43 | 98.00 | |
| 2 | 3 | 81.52 | 84.11 | 71.18 | 48.00 | 10.10 | 100.00 | |
| 2 | 7 | 80.97 | 83.79 | 69.67 | 84.00 | 9.25 | 94.00 | |
| 2 | 21 | 80.26 | 82.61 | 70.84 | 39.00 | 9.91 | 98.00 | |
| 4 | 1 | 78.84 | 81.19 | 69.44 | 22.00 | 7.18 | 92.00 | |
| 4 | 3 | 81.59 | 84.36 | 70.49 | 74.00 | 9.59 | 100.00 | |
| 4 | 7 | 81.86 | 84.62 | 70.83 | 73.00 | 9.77 | 96.00 | |
| 4 | 21 | 81.65 | 84.43 | 70.52 | 66.00 | 9.36 | 96.00 |
표 2. H200 single-forward profiles and LTX quality. Wan timings use one shared reference checkpoint across nominal step configurations; LTX timings are cached-forward measurements for each $(K,\mathrm{USP})$. LTX uses three steps. SC/BC denote subject/background consistency; visual scores are multiplied by 100 without a combined total.
| (a) Wan H200 forward (ms) | |||||
|---|---|---|---|---|---|
| tabularllrrrr Resolution | $K$ | USP1 | USP2 | USP4 | USP8 |
| 480p | 1 | 77.5 | 63.7 | 65.9 | 72.1 |
| 3 | 159.2 | 91.5 | 67.0 | 72.9 | |
| 7 | 358.3 | 194.7 | 105.2 | 78.6 | |
| 21 | 1406.2 | 750.0 | 384.1 | 211.0 | |
| 720p | 1 | 218.7 | 143.4 | 95.8 | 72.7 |
| 3 | 599.6 | 318.4 | 166.5 | 119.4 | |
| 7 | 1521.4 | 809.2 | 443.8 | 276.4 | |
| 21 | 6432.8 | 3335.5 | 1737.1 | 899.7 |
표 3. Online serving results at 480p class for Wan1.3B, LTX-2.3, and Sol-H3. Baseline denotes chunk-level commitment; Speculative Sampling denotes our method. LTX’s parenthesized CUDA Graph configurations apply graph capture and replay to the DiT; Long versus Short isolates chunk size among eager configurations, while parenthesized versus unparenthesized Short isolates this execution mode. $L_{50}/L_{95}$ are seconds; GPU kernel activity and stall ratio are percentages. GPU is the time-weighted mean over the monitored deployment GPUs, with model-specific scope described in the text.
| Model | Resolution | Configuration | Low-frequency updates $L_{50}$ | Low-frequency updates $L_{95}$ | Low-frequency updates GPU | Low-frequency updates Stall | High-frequency updates $L_{50}$ | High-frequency updates $L_{95}$ | High-frequency updates GPU | High-frequency updates Stall |
|---|---|---|---|---|---|---|---|---|---|---|
| Wan1.3B | 480p | Short-Baseline | 1.13 | 1.47 | 49.67 | 0.000 | 1.24 | 1.65 | 52.19 | 0.000 |
| Long-Baseline | 3.23 | 4.64 | 16.97 | 0.000 | 3.11 | 4.66 | 17.29 | 0.000 | ||
| Short–Speculative Sampling | 1.01 | 1.14 | 50.45 | 0.000 | 1.05 | 1.35 | 52.25 | 0.000 | ||
| Long–Speculative Sampling | 1.32 | 1.91 | 17.28 | 0.000 | 1.35 | 1.63 | 19.92 | 0.000 | ||
| LTX-2.3 | 480p | Short-Baseline | 2.12 | 2.58 | 22.02 | 19.669 | 2.01 | 2.64 | 22.69 | 20.339 |
| Short-Baseline (CUDA Graph) | 1.81 | 2.32 | 29.19 | 0.005 | 1.89 | 2.34 | 30.30 | 0.021 | ||
| Long-Baseline | 4.82 | 6.99 | 20.47 | 0.069 | 5.09 | 6.98 | 21.41 | 0.065 | ||
| Short–Speculative Sampling | 2.00 | 2.67 | 21.94 | 19.758 | 2.00 | 2.57 | 22.76 | 19.878 | ||
| Short–Speculative Sampling (CUDA Graph) | 2.01 | 2.82 | 29.03 | 1.781 | 1.94 | 2.54 | 29.99 | 4.407 | ||
| Long–Speculative Sampling | 2.39 | 4.13 | 21.29 | 0.204 | 2.39 | 4.24 | 24.51 | 0.524 | ||
| Sol-H3 | 480p | Short-Baseline | 1.87 | 2.11 | 48.62 | 0.000 | 1.87 | 2.04 | 49.10 | 0.000 |
| Long-Baseline | 4.49 | 6.44 | 17.42 | 0.000 | 4.45 | 6.59 | 18.25 | 0.000 | ||
| Short–Speculative Sampling | 1.11 | 1.50 | 48.85 | 0.000 | 1.15 | 1.53 | 50.00 | 0.000 | ||
| Long–Speculative Sampling | 1.42 | 2.47 | 18.45 | 0.000 | 1.41 | 1.95 | 22.67 | 0.000 |
이 글의 그림은 arXiv:2610.20556 원본에서 가져왔습니다 (CC BY 4.0). 크기와 형식만 바꿨습니다.
댓글