병렬 드래프트의 맥락 보정 — DCOCO: 스페큘레이티브 디코딩에서 잃어버린 토큰 간 의존성을 다시 찾는 법
TL;DR — DFlash 같은 병렬 확산 드래프터는 한 번에 토큰 블록을 뽑아내지만, 블록 내부에서는 앞 토큰의 정체를 모른 채 예측한다. DCOCO는 추가 드래프터 순방향 없이, 이미 뽑힌 후보들 사이의 인접 전이를 한 번의 배치 연산으로 점수화해 맥락에 맞는 토큰을 재선택하는 경량 보정기다. 4개 백본·10개 벤치마크에서 vanilla 대비 최대 6.6×, 최강 스페큘레이티브 베이스라인 대비 최대 18% 빠르고, 동시성 4–32 스트림에서도 6–23% 우위를 유지한다.
핵심 아이디어
스페큘레이티브 디코딩(speculative decoding)은 “가벼운 드래프터가 토큰을 제안하고, 무거운 타깃 모델이 이를 한 번에 검증한다"는 아이디어로 LLM 추론을 가속한다. 문제는 드래프팅 속도와 수용률(acceptance) 사이의 긴장 관계다.
저자들이 주목한 지점은 딱 하나다. 최근 유행하는 병렬 드래프터(DFlash처럼 확산 기반으로 블록 전체를 한 번에 예측)는 속도는 빠르지만, 블록 안에서 앞 슬롯의 실제 선택 결과를 보지 못한다. 그 결과 개별적으로는 그럴듯한 토큰들이 조합되면서 “New York"과 “San Diego"를 동시에 높게 예측하다가 “New Diego” 같은 부자연스러운 연속을 만들어낸다(§2). 이는 수용률 저하로 이어지고, 결국 속도 이득을 갉아먹는다.
기존의 DSpark·Domino는 이 문제를 순차 모듈로 해결하려 했지만, 그 순차 모듈이 매 디코딩 사이클의 크리티컬 패스(critical path) 위에 올라탄다. DCOCO(DFlash Contextual Co*rrector)는 순차 모듈을 되돌려 놓지 않고도 블록 내 의존성을 복원할 수 있느냐라는 질문에 “그렇다"고 답한다(§1).
핵심은 두 가지 관찰이다.
- 드래프터는 이미 정답을 갖고 있다. Qwen3-8B에서 top-1이 틀린 슬롯의 59% 에서, top-16 후보 안에 검증기의 실제 토큰이 들어 있다(§2). 보정은 “새 토큰 생성"이 아니라 “이미 있는 후보 안에서의 재선택(re-selection)“으로 환원할 수 있다.
- 검증은 앞에서 멈춘다. 스페큘레이티브 검증은 연속된 prefix만 수용하고 첫 거절 지점에서 중단한다. 따라서 뒤쪽 슬롯의 개선은 앞 슬롯이 전부 수용될 때만 의미가 있으므로, 보정은 초기 prefix의 품질에 집중해야 한다(§2).
이 둘을 결합하면 보정기는 “슬롯당 상위 $K$개 후보를 유지하고, 인접 슬롯 사이의 $K^2$개 전이를 전부 병렬로 점수화한 뒤, 앞에서부터 탐욕적으로 골라가는” 작업이 된다. 신경망 점수화는 병렬, 선택만 순차(단순 그리드 위 워크)라는 점이 DSpark·Domino와의 결정적 차이다.
배경: 그들이 해결한 문제
스페큘레이티브 디코딩의 구조
검증기는 제안된 블록 $\hat y_{1:B}$를 한 번의 순방향으로 점수화하고, 슬롯을 왼쪽에서 오른쪽으로 판정하며 가장 긴 수용 prefix를 커밋한 뒤 자기 토큰을 하나 더 추가한다. 탐욕 디코딩에서는 슬롯 $j$가 검증기의 greedy 선택과 일치하면 수용되고, 확률 디코딩에서는 표준 스페큘레이티브 샘플링 규칙 $\min\{1, q_j(\hat y_j)/p_j(\hat y_j)\}$로 수용된다(§3.1).
슬롯 $j$의 수용 여부를 $a_j\in\{0,1\}$로 쓰면, 수용 길이는
$$ A(\hat y) = \max\{ m : a_1 = a_2 = \dots = a_m = 1 \}, $$이고 각 라운드는 $A(\hat y)+1$개의 토큰을 커밋한다. 처리량은 결국 기대 수용 길이와 라운드당 벽시계 시간에 의해 결정된다. 그리고 “검증은 첫 거절에서 멈춘다"는 이 구조적 사실 하나가 DCOCO의 모든 설계 선택을 지배한다 — 슬롯 1에서 거절되면 슬롯 5의 보정 토큰은 아예 검토조차 되지 않기 때문이다(§3.1).
후보 커버리지: 놓치고 있던 헤드룸
저자들은 $T{=}0$ 스페큘레이티브 디코딩 동안 DFlash의 후보를 기록하고 실제 연속과 비교해 top-$k$ 커버리지를 측정했다 — “드래프트 슬롯의 상위 $k$개 후보 안에 검증기가 최종 커밋한 토큰이 들어 있는 비율"이다(§2).
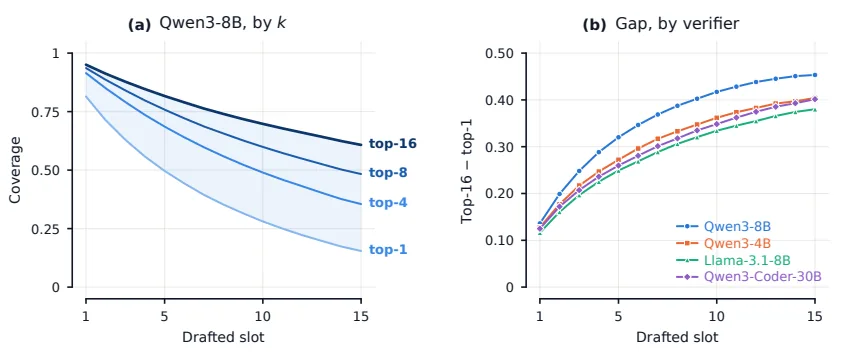
결과는 규칙적이다. Qwen3-8B에서 첫 슬롯은 top-16이 약 95.1% , top-1(드래프터 자신의 선택)이 81.4% 로 차이가 작지만, 마지막 슬롯에서는 top-16이 여전히 60.8% 인 반면 top-1은 15.4% 까지 떨어진다(Fig. 1, Tab. 7). 블록 전체 평균으로 보면 top-1 40.0% vs top-16 75.5%. 즉, 깊은 슬롯에서는 거의 두 슬롯 중 하나가 정답을 후보 풀에 갖고 있는데, 드래프터가 점점 그것을 고르지 못한다. 이 “놓친 정답"이 바로 보정기가 재선택할 헤드룸이다.
새로운 접근법: DCOCO
DCOCO는 두 단계로 동작한다. (1) 실현된(realized) 토큰을 전제로 드래프터의 슬롯별 후보들에 더 강한 맥락 점수를 재부여하고, (2) 그 점수에 따라 블록을 재선택한다(§3).
1) 블록 그리드 위의 학습된 보정기
각 슬롯 $i\in\{1,\dots,B\}$에서 DFlash는 히든 상태 $h_i\in\mathbb{R}^d$와 상위 $K$개 후보를 남긴다. $c_{ik}$는 슬롯 $i$의 $k$번째 후보 토큰 id, $\ell_i(k)$는 그 드래프트 로짓이다. 이 후보들은 $B\times K$ 노드의 조밀한 1차 그리드를 이루고, 슬롯 $p$의 모든 후보가 슬롯 $p+1$의 모든 후보와 연결된다.
각 전이에는 점수가 부여된다:
$$ S_p(a,b) = \underbrace{\ell_{p+1}(b)}_{\text{드래프트 단항 로짓}} + \underbrace{\Delta_\theta(s_p,\, z_{pa},\, z_{p+1,b},\, \ell_p(a),\, \ell_{p+1}(b))}_{\text{학습된 보정}}, $$여기서 $\Delta_\theta$는 공유된 2층 MLP이고, $z_{ik}$는 후보 표현, $s_p$는 후보와 무관한 쌍 상태(pair state) 다(§3.2). 보정기는 오직 단일 DFlash 패스가 남긴 히든 상태·후보 id·로짓만 읽는다.
- 후보 표현(candidate representation) $z_{ik}$: 동결된 토큰 임베딩 테이블 $E$에서 $c_{ik}$의 임베딩을 뽑아 투영·정규화한 $b_{ik}$와, 슬롯 히든 상태 $h_i$를 투영·정규화한 $g_i$를 연결(concatenate)해 융합한다. 토큰 임베딩과 히든 상태는 스케일이 두 자릿수 이상 다르기 때문에 비-아핀 레이어 정규화를 쓴다.
- 쌍 상태 $s_p$: 인접 슬롯의 히든 상태를 이어붙여 $s_p = W_{\text{pair}}[h_p; h_{p+1}]$로 계산한다. $s_p$는 슬롯에만 의존하므로 한 번 계산해서 그 사이 $K^2$개 전이에 전부 재사용된다.
핵심 설계 비결은 두 가지다. 첫째, MLP의 출력층이 0으로 초기화되어 처음에는 $\Delta_\theta\equiv 0$이고, 따라서 모든 전이 점수가 후속자의 드래프트 로짓 $S_p(a,b)=\ell_{p+1}(b)$로 수렴해 초기화 시점에 드래프터의 원본 제안을 그대로 재현한다(§3.2). 둘째, 모든 프로젝션·MLP 파라미터가 슬롯과 전이에 걸쳐 공유되며, $(B-1)K^2$개의 전이 점수가 경로 선택 전에 한 번의 배치 연산으로 계산된다.
2) Prefix-first 탐욕 선택
점수가 매겨진 그리드에서, 단순히 전체 경로 점수 합을 최대화하면 뒤쪽 슬롯의 높은 점수가 앞 슬롯의 낮은 점수를 보상해버린다 — 하지만 뒤쪽 토큰은 앞 prefix가 살아남아야만 기여한다. 이 비대칭성 때문에 DCOCO는 prefix-first 탐욕 규칙을 쓴다:
$$ k_1 = \arg\max_k \ell_1(k), \qquad k_{p+1} = \arg\max_b S_p(k_p, b) \quad (p=1,\dots,B-1). $$첫 슬롯은 드래프터의 top 후보를 유지하고, 이후 각 슬롯은 선택된 선행자로 조건화된 점수로만 후속자를 고른다. 미래 전이를 내다보는 룩어헤드가 없다는 점이 오히려 장점인데, 이 워크는 $O(BK)$에 불과하고(점수화 $O(BK^2)$ 위에 더해지는), $\Delta_\theta\equiv 0$이면 드래프터의 argmax와 정확히 일치한다(§3.3).
3) 학습: 검증기-정답 prefix만 지도
드래프터와 보정기는 함께 최적화된다. 전이 $p$의 라벨 $(a^\star_p, b^\star_p)$은 교사 강제(teacher-forced) 맥락 위에서 두 슬롯의 검증기 argmax 토큰 쌍이며, 각 슬롯의 top-$K$ 안에 존재할 때만 마스크 $m_p=1$로 활성화된다. 보정 손실은 $K^2$개 전이를 joint softmax로 정규화한 크로스엔트로피에 지수 감쇠 가중치를 곱한다:
$$ \mathcal{L}_{\text{corr}} \propto -\sum_{p=1}^{B-1} e^{-(p-1)/\rho}\, m_p \log \frac{\exp S_p(a^\star_p, b^\star_p)}{\sum_{a,b=1}^{K}\exp S_p(a,b)}, \qquad \rho = 4. $$이 softmax는 학습에만 존재하고, 추론 시 $S_p$는 정규화 없이 쓰인다. 지수 가중치는 “앞 슬롯이 수용되어야 뒤 전이가 기여한다"는 prefix 생존 구조를 반영한 고정 프록시다(§3.2, App. A). 지도는 드래프터가 도달 불가능한 전이를 억제하지 않고 그냥 드롭한다 — 검증기-정답 prefix만이 보정기의 출력이 실제 소비되는 상태이기 때문이다(App. A).
4) 확률 디코딩에서도 결정적 제안
흥미로운 이론적 정리다. DCOCO는 확률 디코딩에서도 결정적으로 토큰을 선택하므로, 각 슬롯의 제안 분포는 점 질량(point mass) $p_j(v)=\mathbf{1}[v=\hat y_j]$이 된다. 이때 표준 스페큘레이티브 샘플링의 수용 확률은 $\min\{1, q_j/p_j\}=q_j(\hat y_j)$로 단순화되고, 거절 시 잔차 분포는 $r_j(v)=q_j(v)\mathbf{1}[v\neq\hat y_j]/(1-q_j(\hat y_j))$가 된다. 이를 매 슬롯에 반복하면 검증기 분포가 정확히 보존된다 — 즉, 확률적 타깃 디코딩이 확률적 드래프트 선택을 요구하지 않는다(App. D). 전이 점수에 softmax 정규화도, 후보 분포 샘플링도 필요 없다.
작동 원리: 구체적인 예시로 살펴보기
“New Diego” 문제를 미니어처로 재현해 보자. 블록 크기 $B=4$, 슬롯당 후보 $K=3$이라고 하자. DFlash 한 번의 패스가 다음을 남겼다고 가정하자(논문의 Fig. 2와 동일한 예시 토큰·점수).
- Slot 1:
These(4.2),The(3.6),A(2.8) - Slot 2:
key(0.4),keys(2.7),locks(1.1) - Slot 3:
is(0.2),are(3.1),was(0.8) - Slot 4:
missing(2.8),here(1.6),broken(0.5)
드래프터가 그냥 각 슬롯의 top-1을 고르면 “These key is missing” 이 된다 — 각 단어는 그럴듯하지만 문법적으로 어긋난다. 문제의 정체는 “These” 뒤에 “keys"가, “keys” 뒤에 “are"가 와야 한다는 인접 맥락이 드래프터에게 전혀 반영되지 않았다는 것이다.
DCOCO는 이 블록을 $4\times 3$ 그리드로 펼친다. 각 슬롯의 후보 표현 $z_{ik}$(임베딩 + 슬롯 히든 상태)와 쌍 상태 $s_p$를 만들고, 인접 슬롯 사이의 모든 $3\times 3=9$개 전이를 공유 MLP $\Delta_\theta$로 점수화한다. 예컨대 (Slot1→Slot2)의 전이 9개는 전부 병렬로:
$$ S_1(\text{These}, b) = \ell_2(b) + \Delta_\theta(s_1, z_{1,\text{These}}, z_{2,b}, \dots) $$로 계산된다. $\Delta_\theta$는 학습 중에 “These + keys”, “keys + are” 같은 검증기가 실제로 선택하는 인접 쌍에 높은 점수를 주도록 훈련되었으므로, 드래프트 로짓 $\ell_2(\text{key})=0.4$에 보정을 더해 $S_1(\text{These}, \text{keys})$가 $S_1(\text{These}, \text{key})$를 넘어서게 된다.
그 다음은 prefix-first 워크다. Slot 1은 top-1 These로 고정(→ These). Slot 2는 $S_1(\text{These}, \cdot)$가 최대인 keys를 고른다(→ These keys). Slot 3은 이제 선택된 keys로 조건화된 $S_2(\text{keys}, \cdot)$가 최대인 are를 고른다(→ These keys are). 마지막 Slot 4는 $S_3(\text{are}, \cdot)$로 missing을 고른다. 최종 제안은 “These keys are missing” — 드래프터의 top-1 조합이 만들어낸 비문을, 추가 드래프터 순방향 없이 문법적으로 올바른 문장으로 바꿔냈다.
여기서 중요한 점은 선택만 순차이고, 9개의 점수화는 전부 한 배치 연산에 묶여 있다는 것이다. DSpark·Domino가 이 예시를 고치려면 슬롯을 하나씩 훑는 순환 모듈을 돌려야 하지만, DCOCO는 한 번의 병렬 점수화 + $O(BK)$ 워크로 끝난다.
성능 검증: 주요 결과
설정
검증기는 4개 백본 — Qwen3-4B, Qwen3-8B, Qwen3-Coder-30B-A3B, Llama-3.1-8B — 이고, 벤치마크는 수학(GSM8K, MATH-500, AIME-25)·코드(HumanEval, MBPP, LiveCodeBench)·일반(MT-Bench, Arena-Hard-v2, Alpaca, SpeedBench) 10개다. 모든 드래프터는 블록 크기 16, 약 800K 프롬프트(Nemotron Post-Training v2의 stem/math/code + CodeAlpaca-20k)로 학습했다. 서빙은 vLLM 0.27.0, 단일 NVIDIA B200, BF16, TP=1이다(App. C). 주 지표는 end-to-end 토큰/초(TPS) 이고, 보조 지표로 평균 수용 길이 $\tau$ 를 써서 “품질 향상"과 “서빙 오버헤드"를 분리한다(§4).
정확한 결론: TPS가 아니라 $\tau$ 로 읽어야 하는 이유
이 논문의 가장 정직한 선택은 TPS를 주 지표로 삼은 점이다. 보정기는 수용 길이를 늘리면서도 자기 점수화 비용으로 벽시계 시간을 깎아먹을 수 있고, 그 트레이드오프는 TPS에서만 드러난다(§4). 그래서 논문은 $\tau$(메커니즘)와 TPS(결과)를 병렬 보고한다.
Qwen3-8B(thinking off)에서 DCOCO는 평균 수용 길이 $\tau$가 4.985 로, Domino(4.613) 대비 +8.1%, DSpark(4.254) 대비 +17.2%, 무보정 DFlash(3.913) 대비 +27.4% 다. 그리고 이 $\tau$ 향상이 TPS 향상으로 그대로 이어진다(Fig. 3, Tab. 2).
전체 결과: 12개 셀 전부 1위
네 백본 × (thinking on/off) × ($T{=}0$/$T{=}1$)의 12개 모든 조합에서 DCOCO가 최고 평균 속도 향상을 기록했다(§4.1, Tab. 2). 각 셀에서 최강 베이스라인 대비 8–19% 우위다. Qwen3-8B 기준 수학·코드 벤치마크는 vanilla 대비 3.7–6.1× 까지, 개방형 챗은 1.8–1.9× 다(탐욕 디코딩 기준). abstract의 최대 6.6× 는 Qwen3-4B AIME-25에서 나온다.
Qwen3-8B(thinking off, $T{=}0$)의 10개 스위트 평균을 보면:
| 시스템 | 평균 TPS | vs vanilla |
|---|---|---|
| No-spec(vanilla) | 265.6 | 1.0× |
| DFlash(무보정) | 783.1 | 2.95× |
| DSpark | 765.6 | 2.88× |
| Domino | 839.3 | 3.16× |
| DCOCO | 959.7 | 3.62× |
즉, 최강 경쟁 보정기 Domino보다 14.3% 빠르고, 무보정 DFlash보다 22.6% 빠르다(Tab. 1).
동시성에서 드러나는 결정적 차이
LLM 서빙은 동시 요청을 배치해 GPU 활용도를 올린다. 동시성이 커지면 검증기의 사이클 시간이 스트림들 사이에서 분할 상환되므로, 보정기가 사이클당 추가하는 오버헤드의 비중이 점점 커진다. 이게 바로 순차 보정기의 무덤이다.
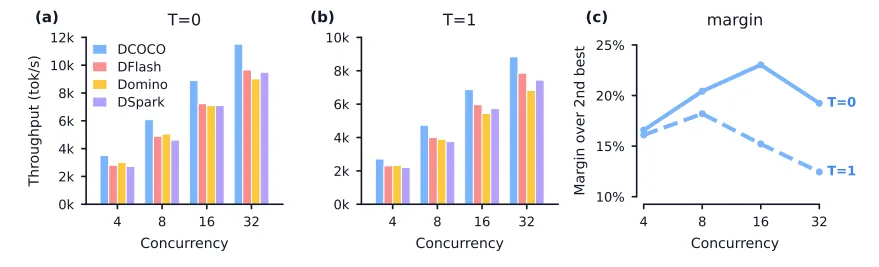
Qwen3-8B(thinking off)에서 DCOCO는 동시성 4→32 스트림 전 구간에서 최고 처리량을 기록하며, 최강 베이스라인 대비 $T{=}0$에서 +16.6%→+23.0%, $T{=}1$에서 +16.1%→+12.4% 의 마진을 낸다(Tab. 8). 반면 Domino와 DSpark는 수용 길이가 거의 그대로인데도 순차 보정 오버헤드가 쌓여 결국 무보정 DFlash보다 느려진다.
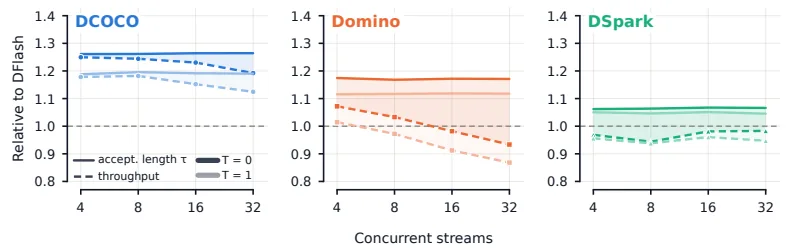
Fig. 3이 이 현상을 명확히 보여준다. 세로축은 DFlash 대비 비율이고, 실선은 수용 길이 $\tau$, 점선은 처리량, 음영은 둘 사이의 갭(=보정기의 사이클당 오버헤드)이다. Domino의 $\tau$ 곡선은 계속 parity(1.0) 위에 있지만 처리량 곡선은 아래로 미끄러진다 — 수용 이득을 오버헤드가 삼켜버린 것. 반면 DCOCO의 두 곡선은 음영이 얇아 거의 함께 움직이며 parity 위에 남는다. 이 현상은 4개 백본 모두에서 재현된다(App. B).
경로 선택과 ablation
경로 선택 규칙(§4.3)을 비교하면, 같은 학습된 점수 그리드 위에서 Global-Sum(전체 합 최대화)은 9개 스위트 전부에서 탐욕보다 $\tau$와 TPS 모두 낮았다. 기하 할인(geometric discount, $\lambda=0.75$)은 수용 길이에서 탐욕과 비슷했지만(평균 5.258 vs 5.254), 처리량은 탐욕이 평균 +2.8% 더 높았다. 결국 $O(BK)$ 워크 + 할인 하이퍼파라미터가 없는 탐욕이 승자다(Tab. 3).
Ablation(App. A)이 보정기의 두 입력 경로를 검증한다.
- 쌍 상태 제거(pair state 제거): 수용 길이 $-$7.3%/$-$5.6% ($T{=}0$/$T{=}1$), 처리량 $-$6.3%/$-$4.6%.
- 후보 표현 제거(cand state 제거): 수용 길이 $-$4.8%/$-$3.7%, 처리량 $-$4.6%/$-$3.3%.
- 백본 동결(드래프터 6-epoch 고정 + 보정기만 학습): 처리량 $-$15.9%/$-$12.9%.
즉, 두 입력 경로 모두 필수이고 그 기여는 수학·코드에서 가장 크다. 또 공동 학습(co-adaptation)이 핵심인데, 백본을 동결해도 보정기가 순수 드롭인으로 DFlash 대비 +4.4% TPS를 내지만, 공동 학습 대비 15.9% 낮다. 반대로 베이스라인들을 12 에폭으로 연장 학습해도 2% 이상 개선되지 않아, DCOCO의 이득이 “학습 예산"이 아니라 보정기 자체에서 온다는 걸 확인한다(Tab. 4).
우리의 관점: 강점, 한계, 그리고 이 연구가 중요한 이유
강점
- “순차 없이 의존성 복원"이라는 깔끔한 정답. DSpark·Domino가 “병렬 드래프트 + 순차 정정"이라는 절충을 택한 반면, DCOCO는 병렬성을 훼손하지 않고 의존성을 되살렸다. 신경망 점수화는 전부 병렬, 선택만 $O(BK)$ 워크라는 분리가 이 논문의 가장 우아한 기여다(§1, §3).
- “재선택"이라는 문제 재정의. “새 토큰 생성"이 아니라 “이미 있는 top-$K$ 후보 중 재선택"으로 보정을 환원한 점이 결정적이다. top-16 커버리지 75.5% vs top-1 40.0%라는 측정(Fig. 1)은 이 재정의가 공허한 게 아니라 실제 헤드룸에 기반함을 보여준다.
- 메트릭의 정직함. TPS를 주 지표로, $\tau$를 메커니즘 지표로 분리한 설계는 “수용 길이를 높였지만 벽시계에서 지는” 보정기의 함정을 정확히 파고든다. 동시성 실험이 이 트레이드오프를 실증한다는 점에서, 이 논문의 결론은 단일 벤치마크 숫자가 아니라 시스템 수준 주장이다.
- 저비용. Qwen3-8B에서 보정기는 약 223만 파라미터(드래프터 $d=4096$, 5층)에 불과하고, 사이클당 비용은 무보정 대비 3–4%에 그친다(App. A, §4.1). “충분히 싸게 만든 보정은 순수 이익"이라는 결론 문장이 숫자로 뒷받침된다.
한계
- 단일 GPU·단일 프레임워크. 모든 실험이 단일 NVIDIA B200 + vLLM 0.27.0 + TP=1에서 수행됐다(§4, App. C). 멀티 GPU 텐서 병렬이나 다른 런타임(예: TRT-LLM)에서의 거동은 미검증이다.
- 단일 시드 학습. 각 방법은 시드 42로 한 번만 학습됐고, 학습 시드 간 분산은 측정되지 않았다(App. A). $T{=}1$의 표준편차는 “생성 시드 3개"에 대한 것일 뿐, 독립 학습 런 간 변동성은 아니다.
- 베이스라인 공정성의 여지. 비교는 “각 방법의 네이티브 구성"으로 이루어졌고, DCOCO는 6+6 에폭(드래프터 6 + 공동 6)을 쓴 반면 베이스라인은 6 에폭이다. 저자들은 연장 학습이 베이스라인에 2% 미만 이득만 준다는 걸 보여 공정성을 방어했지만(Tab. 4), “정확히 같은 블록 크기·같은 예산"을 요구하는 독자에겐 여전히 논쟁 지점이 될 수 있다.
- 드래프터 의존성. DCOCO는 DFlash라는 특정 병렬 드래프터 위에 구축됐다. 다른 병렬/확산 드래프터로의 전이가 자연스럽긴 하지만 실증되지 않았고, 블록 크기·$K$·$\rho$ 등 하이퍼파라미터의 민감도 스윕도 제한적이다.
- 개방형 챗의 한계. 수학·코드는 3.7–6.1×까지 가속되지만 MT-Bench·Alpaca 같은 개방형 챗은 1.8–1.9×에 머문다(§4.1). 이는 드래프터의 기본 수용률 자체의 한계이며, DCOCO가 극복하는 게 아니라 증폭하는 구조다.
왜 중요한가
이 연구의 진짜 기여는 특정 숫자가 아니라 문제를 뒤집은 관점이다. “병렬 드래프트의 단점(블록 내 비의존성)을 되돌리려면 순차가 필요하다"는 암묵적 전제를, “이미 후보 풀 안에 정답이 있고, 인접 전이를 병렬로 점수화하면 순차 없이 복원된다“로 대체했다. 그리고 그 대체가 동시성 부하 아래에서도 — 오히려 그럴수록 더 — 빛난다는 걸 보임으로써, “정정을 싸게 만들면 스페큘레이티브 디코딩의 순수 이익"이라는 실용적 결론까지 끌어냈다. 스페큘레이티브 디코딩이 실제 서빙 스택에서 표준이 되어가는 시점에, 병렬 드래프트의 마지막 약점을 메우는 이 접근은 주목할 만하다.
다음 단계는?: 앞으로의 길
저자들은 명시적으로 거대한 미래 로드맵을 펼치진 않지만, 이 논문의 한계와 구조에서 자연스럽게 다음 단계가 도출된다.
- 다른 드래프터·다른 백엔드로의 일반화. DFlash 외의 병렬 드래프터(예: 다른 확산/CTC 기반)와, 멀티 GPU·다른 런타임에서 DCOCO의 “병렬 점수화 + prefix-first 워크"가 여전히 우위를 유지하는지 검증하는 일이 가장 직접적이다.
- $K$·블록 크기·$\rho$의 체계적 스윕. top-$K$ 후보 수와 지수 감쇠 $\rho$는 “후보 헤드룸"과 “점수화 비용"의 트레이드오프를 직접 제어하는 손잡이다. 이들의 비용-수용 곡선을 정량화하면 배포 시 튜닝 지침이 된다.
- 적응적(adaptive) 후보 수. 커버리지가 슬롯 깊이에 따라 급격히 떨어지는 사실(Fig. 1)을 역이용해, 얕은 슬롯은 작은 $K$로, 깊은 슬롯은 큰 $K$로 점수화 비용을 줄이는 방향이 유망하다.
- 수용률 기반의 학습 가중치. 현재 $\rho=4$ 지수 가중치는 prefix 생존의 “고정 프록시"다. 실제 수용 확률을 추정해 위치별 학습 가중치를 데이터 적응적으로 바꾸는 방향이 논리적 후속이다(§3.2의 명시적 언급).
- 배치 서빙을 겨냥한 설계. 동시성 실험이 이미 보정 오버헤드가 결정 변수임을 보여주므로, 점수화를 CUDA 커널 수준에서 더 미세하게 융합하거나, 미니배치 내 공유 연산을 활용하는 시스템 최적화가 다음 이득의 원천이 될 것이다.
요컨대 DCOCO는 “병렬 드래프트의 잃어버린 맥락을 되찾는 가장 저렴한 방법"이라는, 스페큘레이티브 디코딩의 새 기준선을 제시했다. 다음은 이 아이디어를 더 다양한 하드웨어·드래프터·부하 조건으로 확장해 “정정이 항상 순수 이익"이라는 명제의 경계를 그리는 일이 될 것이다.
논문 원문의 표
arXiv e-print 의 LaTeX 원본에서 기계적으로 옮긴 표입니다. 숫자는 논문의 값이며 모델을 거치지 않았습니다.
표 1. Throughput (output tokens/s, per-stream) and speedup over no-spec decoding, Qwen3-8B, thinking off, concurrency 1, max 2048 generated tokens. Each speculative cell reports TPS with its speedup over the no-spec column in parentheses. Bold: best method per row.
| Domain | Dataset | No-spec | DFlash | Domino | DSpark | DCOCO |
|---|---|---|---|---|---|---|
| Math | MATH-500 | 265.2 | 1293.8 (4.88$\times$) | 1412.3 (5.33$\times$) | 1257.9 (4.74$\times$) | 1625.2 (6.13$\times$) |
| AIME-25 | 263.7 | 1133.7 (4.30$\times$) | 1279.9 (4.85$\times$) | 1188.4 (4.51$\times$) | 1436.8 (5.45$\times$) | |
| GSM8K | 267.0 | 936.9 (3.51$\times$) | 1018.1 (3.81$\times$) | 921.6 (3.45$\times$) | 1175.8 (4.40$\times$) | |
| Code | HumanEval | 266.6 | 873.9 (3.28$\times$) | 950.5 (3.57$\times$) | 857.5 (3.22$\times$) | 1075.6 (4.04$\times$) |
| MBPP | 267.0 | 800.9 (3.00$\times$) | 891.7 (3.34$\times$) | 778.2 (2.92$\times$) | 979.1 (3.67$\times$) | |
| LiveCodeBench | 264.2 | 1080.1 (4.09$\times$) | 1161.6 (4.40$\times$) | 1084.7 (4.11$\times$) | 1328.5 (5.03$\times$) | |
| General | MT-Bench | 266.0 | 434.1 (1.63$\times$) | 425.6 (1.60$\times$) | 386.5 (1.45$\times$) | 494.7 (1.86$\times$) |
| Arena-Hard-v2 | 264.1 | 423.7 (1.60$\times$) | 390.1 (1.48$\times$) | 386.8 (1.46$\times$) | 486.9 (1.84$\times$) | |
| Alpaca | 265.9 | 428.8 (1.61$\times$) | 436.4 (1.64$\times$) | 392.9 (1.48$\times$) | 496.1 (1.87$\times$) | |
| SpeedBench | 266.5 | 425.3 (1.60$\times$) | 426.8 (1.60$\times$) | 401.7 (1.51$\times$) | 498.4 (1.87$\times$) | |
| Average | 265.6 | 783.1 (2.95$\times$) | 839.3 (3.16$\times$) | 765.6 (2.88$\times$) | 959.7 (3.62$\times$) |
표 2. All configurations at a glance: average speedup over vanilla decoding, unweighted mean over the ten evaluation suites. Bold: best per row and temperature. Qwen3-Coder-30B-A3B has no thinking mode. Per-dataset throughput and accepted length: App. .
| Verifier | Think. | DFlash $T{=}0$ | DFlash $T{=}1$ | Domino $T{=}0$ | Domino $T{=}1$ | DSpark $T{=}0$ | DSpark $T{=}1$ | DCOCO $T{=}0$ | DCOCO $T{=}1$ |
|---|---|---|---|---|---|---|---|---|---|
| Qwen3-4B | off | 2.98$\times$ | 2.52$\times$ | 3.27$\times$ | 2.71$\times$ | 2.66$\times$ | 2.28$\times$ | 3.62$\times$ | 2.95$\times$ |
| on | 2.08$\times$ | 1.87$\times$ | 2.17$\times$ | 1.93$\times$ | 1.85$\times$ | 1.69$\times$ | 2.38$\times$ | 2.12$\times$ | |
| Qwen3-8B | off | 2.95$\times$ | 2.45$\times$ | 3.16$\times$ | 2.53$\times$ | 2.88$\times$ | 2.37$\times$ | 3.62$\times$ | 2.87$\times$ |
| on | 1.95$\times$ | 1.78$\times$ | 1.97$\times$ | 1.79$\times$ | 1.83$\times$ | 1.68$\times$ | 2.26$\times$ | 2.03$\times$ | |
| Qwen3-Coder-30B-A3B | off | 1.89$\times$ | 1.67$\times$ | 1.94$\times$ | 1.67$\times$ | 1.84$\times$ | 1.62$\times$ | 2.31$\times$ | 1.98$\times$ |
| Llama-3.1-8B | off | 3.03$\times$ | 1.75$\times$ | 3.24$\times$ | 1.79$\times$ | 3.01$\times$ | 1.65$\times$ | 3.75$\times$ | 1.93$\times$ |
표 3. Path selection over identical trained scores (Qwen3-8B from-pretrained corrector, $T{=}0$, no thinking, 2048 max tokens). Bold: best rule per row and metric. Between greedy and geometric the $\tau$ differences carry both signs and are an order of magnitude smaller than either rule’s gap to Global-Sum; the throughput ordering is uniform.
| Domain | Dataset | Accepted length $\tau$ Greedy | Accepted length $\tau$ Geometric | Accepted length $\tau$ Global-Sum | Throughput (tok/s) Greedy | Throughput (tok/s) Geometric | Throughput (tok/s) Global-Sum |
|---|---|---|---|---|---|---|---|
| Math | MATH-500 | 8.039 | 8.053 | 7.999 | 1627.2 | 1543.6 | 1565.9 |
| AIME-25 | 7.263 | 7.292 | 7.226 | 1437.7 | 1404.1 | 1392.3 | |
| GSM8K | 6.118 | 6.115 | 6.075 | 1176.9 | 1160.5 | 1169.4 | |
| Code | HumanEval | 5.443 | 5.445 | 5.401 | 1077.0 | 1051.8 | 1059.0 |
| MBPP | 5.215 | 5.231 | 5.181 | 979.3 | 971.1 | 969.7 | |
| LiveCodeBench | 6.982 | 6.980 | 6.930 | 1326.4 | 1282.4 | 1275.5 | |
| General | MT-Bench | 2.930 | 2.913 | 2.902 | 498.1 | 487.9 | 488.3 |
| Arena-Hard-v2 | 2.736 | 2.738 | 2.731 | 484.8 | 470.9 | 477.3 | |
| Alpaca | 2.560 | 2.551 | 2.543 | 497.1 | 476.9 | 484.2 | |
| Average | 5.254 | 5.258 | 5.221 | 1011.6 | 983.2 | 986.8 |
표 4. Extending baseline training to match our total budget, Q8B no-thinking, max generated tokens 2048, T=0 averaged across the 10 benchmarks. Baselines show no more than 2% improvement from a second six epochs; the joint phase accounts for our arm’s improvement.
| Arm | $\tau$ @ 6 epochs | $\tau$ @ 12 epochs | $\Delta\tau$ | $\Delta$TPS |
|---|---|---|---|---|
| DFlash | 3.913 | 3.948 | +0.035 (+0.9%) | +11.0 (+1.4%) |
| Domino | 4.613 | 4.701 | +0.088 (+1.9%) | +10.9 (+1.3%) |
| DSpark | 4.254 | 4.321 | +0.067 (+1.6%) | +3.1 (+0.4%) |
| DCOCO (6 + 6 joint) | 3.913 (drafter-only @ 6) | 4.985 | +1.072 (+27.4%) | +176.6 (+22.6%) |
표 5. Ablations: throughput (output tokens/s, per-stream), Qwen3-8B, thinking off, concurrency 1, max 2048 generated tokens, all ten suites. Each ablation cell reports its value with the change relative to DCOCO in parentheses. $-$pair state removes the corrector’s dedicated previous-state channel; $-$cand state zeroes the candidate representations entering the transition scorer; Frozen backbone trains only the corrector on the fixed six-epoch DFlash backbone. Bold: best measured system per row.
| Domain | Dataset | DCOCO | $-$pair state | $-$cand state | Frozen backbone |
|---|---|---|---|---|---|
| Math | MATH-500 | 1599.3 | 1497.7 ($-$6.4%) | 1521.8 ($-$4.8%) | 1333.6 ($-$16.6%) |
| AIME-25 | 1475.6 | 1382.0 ($-$6.3%) | 1387.9 ($-$5.9%) | 1236.1 ($-$16.2%) | |
| GSM8K | 1130.3 | 1042.3 ($-$7.8%) | 1073.2 ($-$5.0%) | 920.2 ($-$18.6%) | |
| Code | HumanEval | 1113.9 | 1035.6 ($-$7.0%) | 1055.9 ($-$5.2%) | 929.5 ($-$16.6%) |
| MBPP | 1121.6 | 1048.7 ($-$6.5%) | 1067.8 ($-$4.8%) | 929.5 ($-$17.1%) | |
| LiveCodeBench | 1202.9 | 1121.2 ($-$6.8%) | 1139.7 ($-$5.3%) | 1019.2 ($-$15.3%) | |
| General | MT-Bench | 575.2 | 548.4 ($-$4.7%) | 565.2 ($-$1.8%) | 499.6 ($-$13.2%) |
| Arena-Hard-v2 | 516.2 | 493.4 ($-$4.4%) | 504.7 ($-$2.2%) | 450.1 ($-$12.8%) | |
| Alpaca | 485.2 | 461.5 ($-$4.9%) | 472.2 ($-$2.7%) | 429.3 ($-$11.5%) | |
| SpeedBench | 498.0 | 475.8 ($-$4.5%) | 481.1 ($-$3.4%) | 430.3 ($-$13.6%) | |
| Average | 971.8 | 910.7 ($-$6.3%) | 927.1 ($-$4.6%) | 817.7 ($-$15.9%) |
표 6. Ablations: accepted length $\tau$, Qwen3-8B, thinking off, concurrency 1, max 2048 generated tokens, all ten suites. Each ablation cell reports its value with the change relative to DCOCO in parentheses. $-$pair state removes the corrector’s dedicated previous-state channel; $-$cand state zeroes the candidate representations entering the transition scorer; Frozen backbone trains only the corrector on the fixed six-epoch DFlash backbone. Bold: best measured system per row.
| Domain | Dataset | DCOCO | $-$pair state | $-$cand state | Frozen backbone |
|---|---|---|---|---|---|
| Math | MATH-500 | 8.256 | 7.588 ($-$8.1%) | 7.802 ($-$5.5%) | 6.801 ($-$17.6%) |
| AIME-25 | 7.506 | 6.935 ($-$7.6%) | 7.043 ($-$6.2%) | 6.250 ($-$16.7%) | |
| GSM8K | 6.010 | 5.482 ($-$8.8%) | 5.697 ($-$5.2%) | 4.845 ($-$19.4%) | |
| Code | HumanEval | 5.746 | 5.340 ($-$7.1%) | 5.439 ($-$5.3%) | 4.764 ($-$17.1%) |
| MBPP | 5.858 | 5.379 ($-$8.2%) | 5.575 ($-$4.8%) | 4.800 ($-$18.1%) | |
| LiveCodeBench | 6.153 | 5.712 ($-$7.2%) | 5.790 ($-$5.9%) | 5.196 ($-$15.5%) | |
| General | MT-Bench | 2.930 | 2.760 ($-$5.8%) | 2.860 ($-$2.4%) | 2.539 ($-$13.4%) |
| Arena-Hard-v2 | 2.605 | 2.479 ($-$4.9%) | 2.550 ($-$2.1%) | 2.257 ($-$13.3%) | |
| Alpaca | 2.474 | 2.344 ($-$5.3%) | 2.407 ($-$2.7%) | 2.173 ($-$12.2%) | |
| SpeedBench | 2.561 | 2.434 ($-$5.0%) | 2.499 ($-$2.4%) | 2.207 ($-$13.8%) | |
| Average | 5.010 | 4.645 ($-$7.3%) | 4.767 ($-$4.8%) | 4.183 ($-$16.5%) |
표 7. Mechanism: mean accepted length $\tau$, Qwen3-8B, thinking off, companion to Table ; no-spec commits one token per round by construction and is omitted. $\tau$ explains the TPS movement; the corrector’s own overhead is visible only in throughput.
| Domain | Dataset | DFlash $T{=}0$ | DFlash $T{=}1$ | Domino $T{=}0$ | Domino $T{=}1$ | DSpark $T{=}0$ | DSpark $T{=}1$ | DCOCO $T{=}0$ | DCOCO $T{=}1$ |
|---|---|---|---|---|---|---|---|---|---|
| Math | MATH-500 | 6.173 | 4.7510.024 | 7.500 | 5.5180.022 | 6.815 | 5.2450.053 | 8.039 | 5.7550.073 |
| AIME-25 | 5.554 | 3.7510.064 | 6.803 | 4.2460.076 | 6.289 | 3.9750.059 | 7.263 | 4.4860.037 | |
| GSM8K | 4.632 | 4.2170.024 | 5.563 | 4.9600.122 | 4.992 | 4.5260.019 | 6.118 | 5.4400.141 | |
| Code | HumanEval | 4.245 | 3.7710.009 | 4.971 | 4.3190.075 | 4.576 | 4.0460.033 | 5.443 | 4.6460.043 |
| MBPP | 3.992 | 3.5070.014 | 4.857 | 4.1210.117 | 4.345 | 3.7670.009 | 5.215 | 4.4280.008 | |
| LiveCodeBench | 5.530 | 4.3980.140 | 6.503 | 4.9080.083 | 6.342 | 4.9200.089 | 6.982 | 5.4310.160 | |
| General | MT-Bench | 2.444 | 2.2490.010 | 2.736 | 2.4750.044 | 2.456 | 2.3180.016 | 2.930 | 2.5810.007 |
| Arena-Hard-v2 | 2.288 | 1.9670.029 | 2.473 | 2.1010.036 | 2.288 | 2.0190.009 | 2.736 | 2.2860.020 | |
| Alpaca | 2.147 | 1.9830.025 | 2.393 | 2.1690.026 | 2.242 | 2.0510.009 | 2.560 | 2.3130.024 | |
| SpeedBench | 2.124 | 1.9940.032 | 2.327 | 2.1560.036 | 2.195 | 2.0700.016 | 2.561 | 2.3730.101 | |
| Average | 3.913 | 3.259 | 4.613 | 3.697 | 4.254 | 3.494 | 4.985 | 3.974 |
표 8. Throughput (output tokens/s, per-stream) and speedup over no-spec decoding, Qwen3-8B, thinking on, concurrency 1, max 4096 generated tokens. Same format as Table .
| Domain | Dataset | No-spec | DFlash | Domino | DSpark | DCOCO |
|---|---|---|---|---|---|---|
| Math | MATH-500 | 262.0 | 608.8 (2.32$\times$) | 617.1 (2.36$\times$) | 567.4 (2.17$\times$) | 724.9 (2.77$\times$) |
| AIME-25 | 260.3 | 586.9 (2.26$\times$) | 612.5 (2.35$\times$) | 574.9 (2.21$\times$) | 703.1 (2.70$\times$) | |
| GSM8K | 264.1 | 555.6 (2.10$\times$) | 559.7 (2.12$\times$) | 518.6 (1.96$\times$) | 646.5 (2.45$\times$) | |
| Code | HumanEval | 260.6 | 562.9 (2.16$\times$) | 572.8 (2.20$\times$) | 524.7 (2.01$\times$) | 654.4 (2.51$\times$) |
| MBPP | 262.8 | 535.6 (2.04$\times$) | 548.2 (2.09$\times$) | 498.2 (1.90$\times$) | 618.1 (2.35$\times$) | |
| LiveCodeBench | 259.2 | 541.9 (2.09$\times$) | 554.5 (2.14$\times$) | 506.6 (1.95$\times$) | 624.2 (2.41$\times$) | |
| General | MT-Bench | 264.4 | 477.4 (1.81$\times$) | 481.9 (1.82$\times$) | 465.3 (1.76$\times$) | 545.6 (2.06$\times$) |
| Arena-Hard-v2 | 260.4 | 439.1 (1.69$\times$) | 421.9 (1.62$\times$) | 404.8 (1.56$\times$) | 508.3 (1.95$\times$) | |
| Alpaca | 265.8 | 388.1 (1.46$\times$) | 389.0 (1.46$\times$) | 364.2 (1.37$\times$) | 440.8 (1.66$\times$) | |
| SpeedBench | 264.3 | 403.3 (1.53$\times$) | 403.3 (1.53$\times$) | 380.9 (1.44$\times$) | 458.7 (1.74$\times$) | |
| Average | 262.4 | 510.0 (1.95$\times$) | 516.1 (1.97$\times$) | 480.6 (1.83$\times$) | 592.5 (2.26$\times$) |
이 글의 그림은 arXiv:2610.12570 원본에서 가져왔습니다 (CC BY 4.0). 크기와 형식만 바꿨습니다.
댓글