TokenRouter: 토큰 단위 LLM 라우팅을 위한 효율적 서빙 시스템
TL;DR — LLM을 세션·쿼리 단위가 아니라 토큰 단위로 라우팅하면 비용-품질 파레토 프론티어를 크게 끌어올릴 수 있지만, 단일 LLM 가정에 묶인 기존 서빙 스택(vLLM, SGLang)에서는 스텝 탈동기화·배치 수용 지연·구현 복잡성 때문에 실용화가 어려웠다. TokenRouter는 “요청 중심 프로그래밍, 모델 중심 실행"이라는 원칙 아래 비동기 서브서버와 지연 배칭(delayed batching) 스케줄러를 도입해, 다섯 가지 라우팅 알고리즘과 여러 모델 쌍에서 기존 구현 대비 2.01–64.15배의 디코딩 처리량을 달성한다 (근거: §Abstract, §1).
핵심 아이디어
모델 라우팅(model routing)은 각 요청을 “가장 적합한” LLM에 분배해 서빙의 비용-품질 파레토 프론티어를 개선하는 서빙 패러다임이다. 지금까지 생산 시스템에서 널리 쓰인 것은 세션/쿼리 단위(coarse-grained) 라우팅이다. 예를 들어 ChatGPT나 Cursor는 사용자 질문의 난이도나 주제를 예측해 요청 전체를 특정 백엔드 모델로 보낸다 (근거: §1). 문제는, 한 번 라우팅이 결정되면 응답 전체가 단일 모델에 의해 생성된다는 점이다.
최근 알고리즘 연구들은 토큰 단위(fine-grained) 라우팅이 쿼리 단위로는 도달할 수 없는 이점을 열어준다는 것을 보여줬다 (근거: §1, §2). 대표적으로 R2R은 32B 모델의 품질을 유지하면서도 토큰의 약 5%만 32B에 라우팅하고 나머지는 1.5B 모델로 디코딩한다. 쿼리 단위로는 약 40%의 쿼리를 32B에 보내야 같은 품질이 나온다 (근거: §1). 즉, 한 응답 내부에서도 생성 난이도가 급격히 변한다는 사실을 이용해, 어려운 토큰만 큰 모델에 맡기는 것이다.
이 논문의 중심 가설은 이렇게 요약된다:
저자들은 토큰 단위 라우팅을 “요청 중심 프로그래밍 + 모델 중심 실행"으로 재설계한 서빙 런타임을 제공함으로써, 기존 단일-LLM 서빙 시스템이 갖는 스텝 탈동기화·배치 수용 지연·구현 복잡성이라는 한계를 극복하고 이론적 이점을 실측 처리량 향상으로 전환할 수 있다고 가정한다.
핵심 기여는 세 가지로 구분된다 (근거: §1).
| # | 기여 | 유형 |
|---|---|---|
| 1 | route–send–receive 세 함수만 구현하면 되는 요청 중심 프로그래밍 인터페이스 | 프로그래밍 모델 |
| 2 | 탈동기화를 해결하는 비동기 “3중 루프(tri-loop)” 실행 + handoff-resume 메커니즘 | 시스템/런타임 설계 |
| 3 | 수리적 처리량 모델로부터 최적 임계값을 도출하는 지연 배칭 스케줄러 | 스케줄링 + 이론적 통찰 |
배경: 그들이 해결한 문제
라우팅의 세 가지 세분화 수준
라우팅은 어느 수준에서 모델을 바꾸느냐에 따라 세 가지로 나뉜다. 아래 그림이 이를 정리한다.
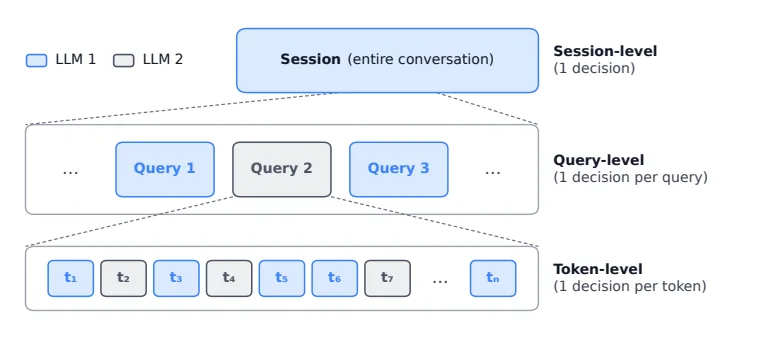
- 세션/쿼리 단위: 요청(또는 대화 턴) 전체를 하나의 모델이 담당. 기존 서빙 스택과 잘 호환되지만 파레토 프론티어 상의 이산적인 지점 몇 개만 선택 가능 (근거: §1, §2).
- 토큰 단위: 토큰 또는 짧은 구간마다 모델을 선택. 한 응답 안에서 여러 모델이 협력한다 (근거: §2).
토큰 단위 라우팅의 이점은 두 갈래다. 효율성 측면에서는 한 쿼리 내부의 난이도 편차를 공략할 수 있고, 품질 측면에서는 상호보완적 전문성을 가진 모델들이 한 응답에서 협력해 단일 LLM의 품질을 능가할 수 있다 (근거: §1). 또 비용-품질 트레이드오프를 이산적 몇 개 지점이 아니라 매끄럽게 제어할 수 있다.
세 가지 결정적 장애물
그런데 기존 서빙 시스템은 “모든 활성 요청이 매 디코딩 스텝마다 동기화되어 있다"는 단일-LLM 가정 위에 서 있다. 토큰 단위 라우팅은 매 스텝마다 목표 모델이 바뀌므로 이 가정을 깨뜨리고, 다음 세 가지 문제를 일으킨다 (근거: §1, §4).
- 스텝 탈동기화(step desynchronization): 모델마다 스텝당 지연이 크게 다르다. 단일 배치에 요청을 묶어 동기화하면 매 스텝이 가장 느린 모델을 기다려야 해서, 빠른 모델이 유휴 상태로 남는다.
- 배치 수용 지연(batch admission delay): 토큰 단위 라우팅은 잦은 모델 전환을 유발하므로, 라우팅된 요청이 목표 모델이 아직 이전 배치를 처리하는 중에 도착하기 쉽다. 요청은 다음 배치에 수용될 때까지 기다려야 해서 버블(bubble)과 배치 파편화가 생긴다.
- 구현 복잡성(implementation complexity): 기존 시스템은 스텝별 라우팅 결정을 위한 프로그래밍 인터페이스 자체를 제공하지 않는다. 토큰 단위 라우팅을 내부에 구현하려면 대규모 코드베이스를 광범위하게 수정하고, continuous batching·prefix caching 같은 기능과 정교하게 조율해야 한다.
기존의 표준 서빙 스택이 사실상 “라우팅을 서빙 최적화와 분리해서 생각할 수단"을 제공하지 않았기 때문에, 알고리즘 연구에서 증명된 이론적 이점이 실제 속도로 전환되지 못했다는 것이 이 논문이 짚는 연구 공백이다.
새로운 접근법: TokenRouter
TokenRouter는 토큰 단위 라우팅 추론을 위한 효율적이면서 개발자 친화적인 서빙 시스템이다. 설계의 중심 원칙은 한 문장으로 요약된다 (근거: §Abstract, §1):
요청 중심 프로그래밍(request-centric programming), 모델 중심 실행(model-centric execution)
개발자는 “단일 요청이 협력하는 LLM들 사이를 어떻게 흘러가는지"만 기술하면 되고, 효율적 서빙은 런타임이 비동기·모델 중심 서브서버로 처리한다. 이 분리가 라우팅 서빙의 복잡성을 개발자에게서 숨기고, 런타임이 교차-모델 실행과 배치 스케줄링을 전적으로 최적화하게 만든다. 외부에는 단일 서버 인터페이스 하나만 노출되므로, 기존 단일-LLM 서버(vLLM/SGLang)의 드롭인(drop-in) 대체재로 쓸 수 있다 (근거: §4).
1) 요청 중심 프로그래밍: route–send–receive
토큰 단위 라우팅 알고리즘들은 정책이 다르지만 공통의 실행 수명주기를 공유한다 (근거: §2, §3):
$$ \textbf{receive} \rightarrow \text{decode} \rightarrow \textbf{route} \rightarrow \textbf{send} \rightarrow \text{peer receive} \rightarrow \text{peer decode} \rightarrow \cdots $$이 수명주기를 세 함수로 추상화한 것이 TokenRouter의 인터페이스다 (근거: §3).
- route(
result): 각 디코딩 스텝 후 호출되어, 히든 스테이트·next-token 로짓·샘플링된 토큰 같은 forward 결과를 보고 배치 내 각 요청의 목적지 인덱스를 정한다. 목적지0은 로컬 계속 디코딩,0이 아닌 값은 해당 피어 모델로 위임을 의미한다. - send(
req): route가 요청을 위임할 때 호출되어 커스텀PeerReq메시지를 만든다. 요청 ID, 피어가 아직 보지 못한 토큰 접미사(suffix), 요청의 활성/종료 상태, 알고리즘 전용 필드를 담는다.req.loc라는 위치 앵커를 붙여 피어가 돌려보내야 할 최소 접미사를 결정할 수 있게 한다. - receive(
peer_req): 피어의PeerReq가 도착하면 호출되어 로컬 요청 형식으로 변환한다. 기본 동작은 전송된 토큰을 전부 커밋하는 것이고, handoff 의미가 알고리즘마다 다를 때만 오버라이드하면 된다.
이 세 함수로 다섯 가지 대표 알고리즘을 전부 표현할 수 있다 (근거: §3, Tab. methods):
| Algorithm | #Models | Model $i$ | Model $j$ |
|---|---|---|---|
| CITER | 2 | low-confidence 토큰 | 토큰 1개 후 |
| R2R | 2 | 예측-발산 토큰 | 토큰 1개 후 |
| R-Stitch | 2 | high-entropy 토큰 | low-entropy 토큰 |
| Co-LLM | 2 | high-deferral 토큰 | 토큰 1개 후 |
| ME | $\geq$2 | 매 토큰 후, 앙상블 가중치에 따라 |
이처럼 알고리즘들은 서로 다른 라우팅 신호(신뢰도·엔트로피·발산 예측·앙상블 가중치)를 쓰지만, 모두 컴팩트한 route/send 함수로 표현되고 기본 receive로 충분하다.
2) 비동기 실행: 분리된 3중 루프 + handoff-resume
스텝 탈동기화를 해결하기 위해 TokenRouter는 단일-LLM 서빙의 표준 구조에 분리된(decoupled) 인터-모델 루프를 추가한다 (근거: §4). 표준 서버는 두 개의 비동기 루프를 갖는다 — 요청 수용·응답 스트리밍을 담당하는 클라이언트-서버 루프(보라)와 요청 스케줄링·모델 실행을 담당하는 디코딩 루프(파랑). TokenRouter는 여기에 세 번째 인터-모델 루프(검정)를 더해 서브서버 간 피어 요청을 주고받는다.
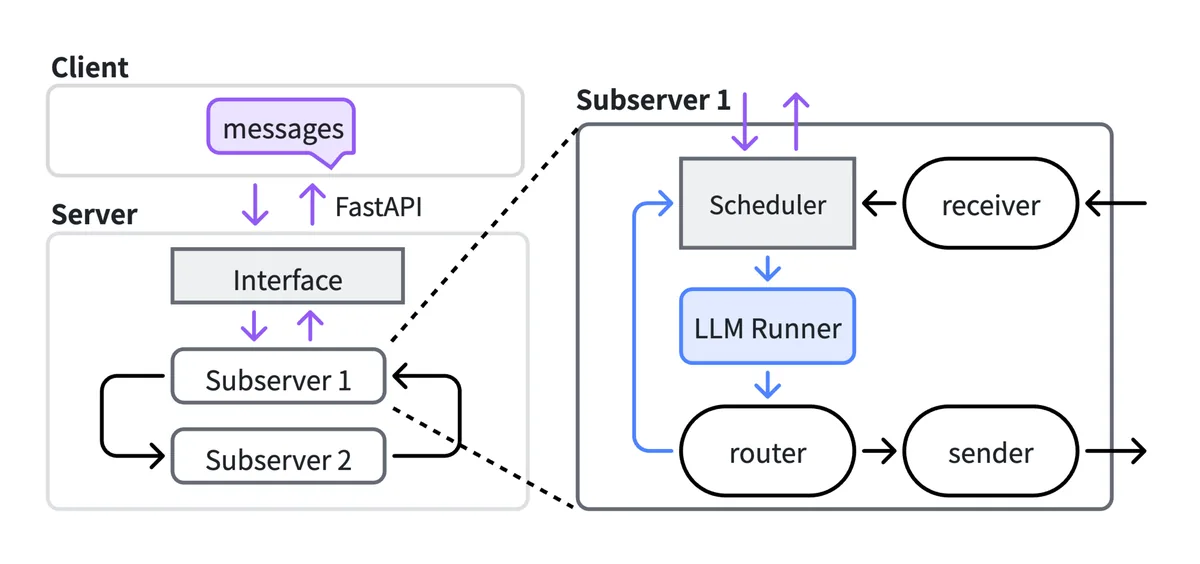
이 세 번째 루프 덕분에 라우팅된 요청은 로컬 배치를 떠났다가 피어 요청이 돌아오면 재개될 수 있다. 요청이 피어 모델에서 처리되는 동안 나머지 로컬 요청은 로컬 디코딩 루프의 속도로 계속 진행된다. 즉, 각 서브서버가 자기 속도로 진행하고, 라우팅된 요청은 비동기적으로 모델을 오간다 (근거: §4).
여기서 중요한 최적화가 handoff-resume 메커니즘이다. 나이브하게는 돌아오는 요청을 “새 요청"으로 취급해 prefix matching과 KV-cache 재할당을 다시 해야 한다. TokenRouter는 running/finished 두 표준 상태 사이에 pending 상태를 도입한다. pending 요청은 스케줄러에 의해 건너뛰지만(finished처럼) 서빙 상태는 그대로 보존된다(running처럼). 재개 시 피어 출력에 따라 running 또는 finished로 전환되고, 새 토큰을 붙여 “마치 떠난 적이 없던 것처럼” 배치에 재수용된다. 이렇게 prefix matching과 KV 재할당을 건너뛰어, 인터-모델 전환을 “토큰 하나 붙이기” 수준으로 줄인다 (근거: §4).
3) 지연 배칭(delayed batching) 스케줄러
비동기 실행이 서브서버 간 동기화를 제거했지만, 각 서브서버는 여전히 “희소하고 불규칙한 라우팅 토큰 도착"을 다룰 스케줄링 정책이 필요하다. 배치 수용 지연은 요청이 서브서버에 도착한 시점부터 실행이 시작될 때까지의 대기 시간으로 정의된다 (근거: §4).
핵심 아이디어는 짧고 제어된 간격만큼 기다려서 같은 모델로 향하는 요청을 모아 함께 실행하는 것이다. 스케줄러는 수신된 요청을 버퍼링하고, 버퍼 크기가 임계값 $B$에 도달할 때만 배치를 실행한다. 일찍 도착한 요청은 더 오래 기다리지만, 늦게 도착한 요청들은 훨씬 짧게 기다려도 되므로 워크로드 전체의 평균 배치 수용 지연이 줄어든다.
아래 그림이 네 가지 스케줄링 전략을 대비한다.
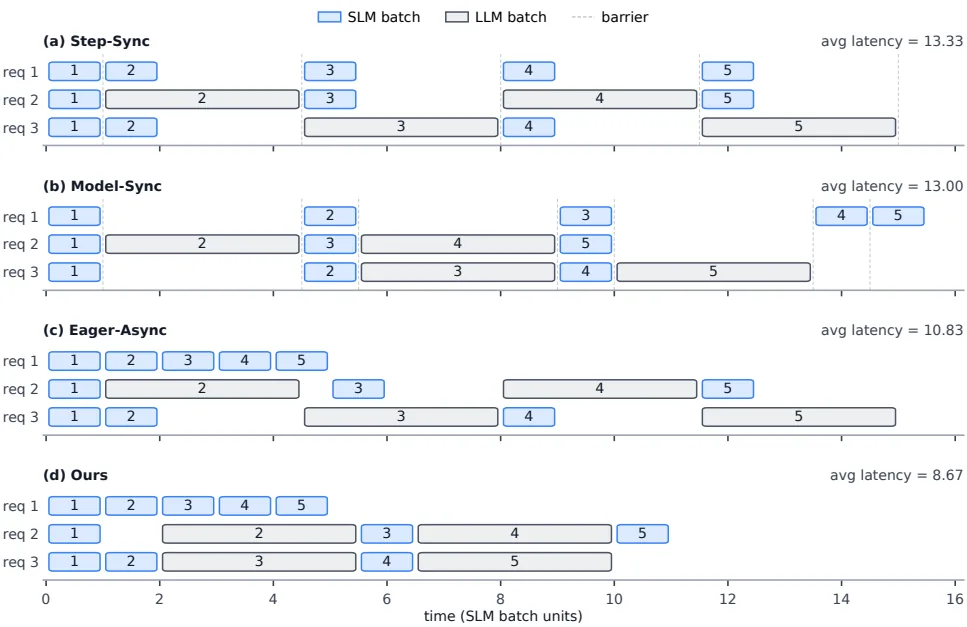
여기서 $B$를 어떻게 고르느냐가 관건이다. $B$가 너무 작으면 배치 수용 지연이 커지고, 너무 크면 요청이 큐에 갇혀 SLM이 할 일 없이 굶주리게(starvation) 된다. TokenRouter는 이 트레이드오프를 수리적으로 해결한다 (근거: §4, Appx. math_model). 이 내용은 아래 “작동 원리"에서 자세히 다룬다.
작동 원리: 구체적인 예시로 살펴보기
예시 1 — R-Stitch를 route–send–receive로 표현하기
작은 모델(SLM)과 큰 모델(LLM) 두 개가 협력하는 R-Stitch를 떠올려 보자. 아이디어는 “SLM이 불확실한(high-entropy) 토큰은 LLM에 맡기고, 확실한 토큰은 스스로 생성한다"는 것이다. LLM 쪽은 반대로 low-entropy 토큰을 SLM에 돌려보낸다.
SLM 쪽 구현은 세 함수로 끝난다 (근거: §3, Fig. rstitch):
class RStitchSLM(BaseRouter):
    # self.tau (threshold) 와 self.peer_idx (LLM 서브서버 인덱스) 는 config 에서 온다.

    def route(self, result):
        # high-entropy 토큰은 LLM 에 위임하고, 나머지는 로컬로 유지한다.
        probs = result.logits_output.next_token_logits.softmax(dim=-1)
        entropy = -(probs * probs.log()).sum(-1) / math.log(probs.shape[-1])
        destination = torch.zeros_like(entropy, dtype=torch.long)
        destination[entropy > self.tau] = self.peer_idx
        return destination.cpu()

    def send(self, req) -> PeerReq:
        # 방금 디코딩한 불확실 토큰을 버리고, LLM 이 그 위치부터 재생성하게 한다.
        token_ids = req.origin_input_ids + req.output_ids[:-1]
        peer_anchor = req.peer_locs[self.peer_idx] or 0
        return PeerReq(rid=req.rid, token_ids=token_ids[peer_anchor:],
                       loc=len(token_ids), finished=req.finished(), ...)

# receive 는 기본(전송된 토큰 전부 수용)으로 폴백한다.여기서 각 함수가 무엇을 하는지 한 단계씩 짚어 보자.
- route: forward 결과의 next-token 로짓을 softmax해 확률 분포를 얻고, 정규화된 엔트로피를 계산한다. 임계값
tau(R-Stitch에서는 $0.03$)를 넘는 토큰의 목적지를peer_idx로, 나머지는0(로컬)으로 설정한다. - send: 위임 시 “방금 샘플링된 불확실 토큰"을 제외한(
output_ids[:-1]) 접미사만 전달한다. LLM이 그 위치부터 다시 생성하도록 하기 위함이다.peer_anchor를 통해 피어가 이미 아는 부분은 잘라내 최소 접미사만 보낸다. - receive: LLM이 돌려보낸 토큰을 전부 수용한다(기본 동작).
핵심 통찰은 개발자가 배치, 스케줄링, 비동기 실행을 전혀 신경 쓰지 않아도 된다는 점이다. 그저 한 요청이 SLM→LLM→SLM으로 흘러가는 궤적을 따라 세 함수를 채우면 된다. LLM 쪽은 route의 >를 <=로 바꾸는 것만 다르다 (근거: §3).
예시 2 — 지연 배칭이 배치 파편화를 줄이는 과정
두 모델(SLM과 LLM)이 있고 LLM의 지연 배칭 임계값 $B=2$, SLM은 $B=1$(즉시 실행)이라고 하자 (근거: §4, Fig. schedule).
- 요청 1의 토큰이 LLM에 도착한다. 버퍼에 1개뿐이라 배치를 실행하지 않는다.
- 요청 2의 토큰이 도착한다. 버퍼가 $B=2$에 도달해 두 요청을 한 배치로 묶어 실행한다.
- LLM forward가 끝나면 두 토큰이 함께 커밋되고, 요청들은 SLM으로 돌아가 계속 진행한다.
즉시 실행(eager) 방식이라면 요청 1의 토큰을 위해 LLM을 즉시 호출하고, 그 실행 중 도착한 요청 2의 토큰은 다음 배치까지 기다려야 한다. 지연 배칭은 “LLM의 고정 오버헤드(커널 런칭, 메모리 접근 등)를 더 넓은 배치에 분산(amortize)“하기 때문에, 평균 수용 지연이 줄고 처리량이 올라간다.
예시 3 — 최적 임계값 $B^*$를 찾는 수리 모델
TokenRouter는 지연 배칭 임계값의 처리량 최적 값 $B^*$ 를 해석적으로 결정한다. 라우팅 과정을 이산시간 마르코프 체인(DTMC) 으로 모델링한다 (근거: §4, Appx. math_model).
시스템 상태는 각 모델의 (대기 큐 $k_i$, 실행 중 배치 $b_i$, 잔여 실행 시간 $r_i$)로 표현된다. 모델 $i$에서 한 스텝을 마친 요청은 확률 $p_{ij}$로 모델 $j$에 라우팅되고 $c_{ij}$개의 출력 토큰을 커밋한다. 라우팅 전이 행렬 $\mathbf{P}$와 토큰 커밋 행렬 $\mathbf{C}$를 정의한다.
예컨대 R2R(두 모델, $M=2$)의 경우:
$$ \mathbf{P} = \begin{bmatrix} 1-p & p\\ 1 & 0 \end{bmatrix}, \qquad \mathbf{C} = \begin{bmatrix} 1 & 0\\ 1 & 0 \end{bmatrix} $$여기서 $p$는 SLM이 한 토큰 생성 후 LLM에 넘길 확률이다. SLM이 직접 커밋하거나($1-p$), LLM이 수정한 토큰을 커밋($\mathbf{C}$의 두 번째 행)하는 구조다.
배치 완료 시점에서 시스템을 관찰하면 유한 상태 DTMC가 된다. 정상 분포 $\boldsymbol{\pi}_{\mathbf{B}}$를 풀면, 정상상태 처리량 $T(\mathbf{B})$는 “기대 커밋 토큰 수 ÷ 기대 홀딩 시간"이다:
$$ T(\mathbf{B})
\frac{ \sum_{\mathbf{s}\in\mathcal{R}{\mathbf{B}}} \pi{\mathbf{B}}(\mathbf{s}) \sum_{i\in\mathcal{A}(\mathbf{s})}\sum_{j=0}^{M-1} b_i, c_{ij}, p_{ij} }{ \sum_{\mathbf{s}\in\mathcal{R}{\mathbf{B}}} \pi{\mathbf{B}}(\mathbf{s}),\tau(\mathbf{s}) } $$
마지막으로, 데드락(어떤 모델도 배치를 시작할 요청이 부족한 상태)을 막기 위한 실행가능 조건 아래에서 처리량을 최대화하는 $\mathbf{B}^\star$를 찾는다:
$$ \sum_{i=0}^{M-1}(B_i - 1) < N $$저자들은 R2R에 대해 이 모델을 실측과 대조했다. SLM 스텝 지연 $L_0 = 6.0\,\mathrm{ms}$, LLM 스텝 지연 $L_1 = 27.9\,\mathrm{ms}$, 시간 양자 $\delta = 0.1\,\mathrm{ms}$, $p = 0.35$로 설정했고, 모델이 예측한 최적 임계값이 모든 동시성 수준에서 실측 최적 임계값과 일치했다 (근거: Appx. math_model).
이 세 가지 메커니즘의 역할을 정리하면 — route–send–receive는 표현력(expressiveness), 비동기 3중 루프는 탈동기화 제거, 지연 배칭은 배치 파편화 방지를 각각 담당한다. 여기에 CUDA 그래프 캡처, in-process 라우터, 자동 KV-cache 할당 같은 라우팅 전용 엔지니어링 최적화가 더해진다 (근거: Appx. opt).
성능 검증: 주요 결과
실험 설정
- 알고리즘 5종: CITER, R2R, R-Stitch, Co-LLM, ME. 앞의 넷은 Qwen3-0.6B ↔ Qwen3-32B, ME는 Qwen3-0.6B/8B/32B 세 모델 사이를 라우팅한다 (근거: §5).
- 하드웨어: 8×A100-80G 서버. 2-모델 알고리즘은 SLM 1 GPU, LLM 2 GPU(텐서 병렬), CUDA MPS로 공유 (근거: §5).
- 베이스라인: 알고리즘 공식 구현(Official Code)과, 공정 비교를 위해 구축한 SGLang 기반 Std. Serving (근거: §5).
- 워크로드 3종: Low-effort reasoning(AIME2024, 입력 ~100 토큰/출력 최대 2048), High-effort reasoning(출력 최대 8192), Agentic(SWE-Smith, 입력 ~8192/출력 최대 1024) (근거: §5).
처리량: 최대 64배
15개 알고리즘-워크로드 조합 전부에서 TokenRouter는 더 강한 베이스라인 대비 2.01–64.15배의 처리량을 기록했고, Std. Serving 대비 종단 지연(end-to-end latency)을 2.03–63.64배 줄였다 (근거: §5, Fig. throughput_bs4). 이득은 특히 Co-LLM과 CITER에서 크다. 공식 구현이 continuous batching조차 없는 경우가 많았고, Std. Serving은 handoff-resume이 없어 라우팅된 요청의 서빙 상태를 보존하지 못하기 때문이다.
원래 알고리즘 설정 그대로 비교한 표(동시성 4)를 보자 (근거: Tab. e2e_latency_bs4):
| Algorithm | Implementation | Throughput (token/s) | TTFT (s) | Latency (s) | |—|—:|—:|—:| | R2R | LLM-only | 145.30 | 0.13 | 411.98 | | | Official Code | 89.62 | 0.11 | 751.15 | | | TokenRouter | 244.56 | 0.11 | 270.19 | | CITER | LLM-only | 123.72 | 0.083 | 2.68 | | | Official Code | 17.16 | 0.036 | 7.64 | | | TokenRouter | 149.31 | 0.036 | 0.48 | | Co-LLM | LLM-only | 134.79 | 0.069 | 13.39 | | | Official Code | 3.46 | 1.14 | 247.61 | | | TokenRouter | 76.02 | 0.067 | 11.46 | | R-Stitch | LLM-only | 150.41 | 0.15 | 360.76 | | | Official Code | N/A | N/A | N/A | | | TokenRouter | 140.58 | 0.067 | 151.30 |
주목할 점: CITER는 처리량을 149.31 token/s까지 끌어올리면서 지연을 0.48초로 줄여, LLM-only(2.68초)보다도 훨씬 빠르다. 즉 라우팅을 통해 품질은 유지하면서 단일 대형 모델보다 빠르게 서빙할 수 있다는 뜻이다.
성능 이득은 어디서 오는가
동시성 8에서 이득을 분해하면 (근거: §5, Tab. gain_source):
| 구성 | $N=8$ throughput (token/s) |
|---|---|
| TokenRouter (전체) | 372.48 |
| − 지연 배칭 | 296.86 |
| − 비동기 실행 | 230.79 |
| − 라우터 CUDA 그래프 | 228.10 |
| − LLM CUDA 그래프 | 164.08 |
| − SLM CUDA 그래프 (≈ R2R 공식) | 132.78 |
| R2R 공식 코드 | 134.89 |
공학적 최적화(CUDA 그래프 캡처 확장)만으로도 기본 132.78 → 230.79 token/s(약 1.71배)로 오르고, 비동기 실행과 지연 배칭을 얹어 372.48 token/s(총 2.76배)까지 도달한다 (근거: §1, §5).
Std. Serving과의 격차를 이해하는 단서는 지연 분해에 있다. SLM 측 스텝당 지연(2048 토큰 생성의 마지막 128 스텝 평균)에서 (근거: Appx., Tab. slm_latency_breakdown):
| 연산 | 지연 (ms) | 비율 |
|---|---|---|
| Prefix matching | 7.78 | 20.94% |
| Update radix cache | 12.12 | 32.62% |
| Locking cache nodes | 6.49 | 17.47% |
| Releasing locks | 5.13 | 13.81% |
| SLM inference | 1.56 | 4.20% |
| Others | 4.08 | 10.98% |
충격적이게도 실제 SLM 추론은 4.20% 에 불과하고, 나머지는 전부 “돌아오는 요청을 새 요청으로 취급하는” 단일-모델 가정의 오버헤드다. TokenRouter는 모델 전환 간에 요청 수준 KV-cache 상태를 보존하고 피어 결과가 오면 바로 재개하므로, 이 오버헤드를 대부분 제거한다 (근거: Appx.).
처리량–속도 트레이드오프
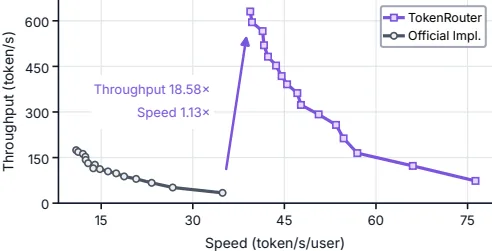
동시성을 1에서 16까지 올리면 TokenRouter의 처리량은 8.61배 증가하면서 단일-사용자 속도의 51.7%를 유지한다. 반면 공식 R2R은 5.14배 증가에 31.3% 유지에 그친다. 특히 동시성 16에서 TokenRouter는 동시성 1의 R2R보다 18.58배 높은 처리량을 내면서도 사용자당 속도는 1.13배 더 빠르다 — 즉 더 엄격한 속도 SLO 아래에서도 처리량이 압도적으로 높다 (근거: §5).
일반화 검증
- 모델 쌍 변화: 0.6B-8B, 0.6B-32B, 1.7B-8B, 4B-8B 네 쌍 모두에서 R2R 공식 대비 1.99–3.21배 (근거: §5, Tab. r2r_tokenrouter_gain_app).
- 출력 길이 확장: low-effort(최대 2048)에서 high-effort(최대 8192)로 가도 TokenRouter의 처리량은 유지되는 반면, Std. Serving은 처리량의 58.1–85.2%를 잃는다 (근거: §5).
- 분산 배치: 두 노드를 RoCE(3.7 GB/s)로 연결한 교차-노드 배치에서도 단일 노드와 비슷한 처리량(공식 대비 1.93–32.81배) (근거: Appx.).
- 파레토 프론티어: TokenRouter가 토큰 단위 라우팅을 새로운 파레토 프론티어로 끌어올려, SGLang 같은 SOTA 프레임워크 위의 조대한(coarse-grained) 쿼리 라우팅보다 경쟁력 있게 만든다 (근거: §5).
우리의 관점: 강점, 한계, 그리고 이 연구가 중요한 이유
강점
- 깔끔한 문제 정식화와 명확한 기여 분리. 세 가지 장애물(탈동기화·수용 지연·구현 복잡성)을 명시하고, 각각을 해결하는 메커니즘(비동기 3중 루프·지연 배칭·route-send-receive)을 일대일로 대응시킨 구조가 설득력 있다.
- “표현력"과 “실행"의 분리. 개발자는 요청 궤적만 그리면 된다는 추상화는 단순하면서도 강력하다. 다섯 가지 알고리즘을 동일 런타임 위에 얹었다는 사실이 그 범용성을 증명한다 (근거: §3, §5).
- 이론-실측 정합. 지연 배칭 임계값을 DTMC로 도출하고, 예측 최적값이 실측 최적값과 일치함을 보인 것은 엔지니어링 논문에서 드문 강점이다 (근거: Appx.).
- 정직한 베이스라인. 공식 구현이 없는 경우, 그냥 “N/A"로 두지 않고 SGLang 기반 Std. Serving을 직접 만들어 공정 비교를 시도했다. 오버헤드 분해표(Tab. slm_latency_breakdown)는 이득의 원인을 투명하게 보여준다.
한계와 주의할 점
- 수리 모델의 가정. 저자들 스스로 인정하듯, 모델은 연속된 두 send 사이의 토큰 수가 기하 분포(geometric distribution)를 따른다고 가정한다. 대부분의 알고리즘에는 성립하지만, 이를 위반하는 코너 케이스는 미해결로 남아 있다 (근거: §6).
- 하드웨어·규모의 범위. 평가는 단일 8×A100-80G 서버 중심이고, ME의 다중 모델(≥3) 시나리오의 심층 분석은 상대적으로 얇다. GPU 세대나 추론 특화 하드웨어(H100/MI300 등)에서의 확장성은 검증되지 않았다.
- 라우팅 알고리즘 자체의 품질은 검증 대상이 아니다. 이 논문은 “주어진 라우팅 알고리즘을 얼마나 빠르게 서빙하느냐"를 다룬다. 라우터의 정확도·품질 유지 여부는 각 원 논문의 문제다. 처리량–정확도 트레이드오프는 일부만 다뤄졌다.
- CUDA MPS 기반 GPU 공유가 만드는 비교의 미묘함. 두 모델이 GPU를 공유하는 설정은 자원 공정성과 관련해 해석이 필요하다. 논문은 non-overlap 배치(+6.43%)와 병렬 전략을 부록에서 다루며 이 점을 의식한다 (근거: Appx.).
왜 중요한가
토큰 단위 라우팅은 “작은 모델 + 선택적 대형 모델 호출"이라는, 실무적으로 매우 매력적인 비용 절감 전략이다. R2R이 “5% 토큰만 32B로” 같은 수치를 보여주면서도, 실제 서빙 속도가 기대를 못 따라가는 것이 걸림돌이었다. TokenRouter는 그 간극을 메우는 시스템 계층의 인프라를 제공한다. 앞으로 나올 토큰 단위 라우팅 알고리즘 연구들이 “이론적 이점"에서 “실측 속도"로 넘어갈 수 있는 토대라는 점에서 의미가 크다.
다음 단계는?: 앞으로의 길
저자들이 열어둔 문제를 중심으로, 합리적인 다음 단계는 다음과 같다.
- 수리 모델의 일반화. 기하 분포 가정을 완화해, 상태 의존적·시간 가변적 라우팅 확률과 비정상 도착을 처리할 수 있는 모델로 확장하는 것. 부록의 주석 처리된 일반 모델이 그 방향의 초안을 보여준다.
- 3개 이상 모델(ME)에 대한 심층 최적화. 현재는 ME를 기능 수준에서 검증했을 뿐, 다중 모델 간 handoff 비용과 지연 배칭 임계값의 조인트 최적화는 여지가 많다.
- 다양한 하드웨어·서빙 백엔드. SGLang 기반 구현을 넘어 vLLM, TensorRT-LLM 등과의 통합, 그리고 더 넓은 GPU 세대·추론 칩에서의 재현.
- 라우팅 정책과 스케줄러의 공동 설계. 지연 배칭 임계값 $B^*$ 는 라우팅 확률 $p$에 의존한다. 라우팅 정책과 서빙 스케줄러를 함께 학습/탐색하는 방향은 흥미로운 후속 연구가 될 수 있다.
- 품질 지표와의 정합. 처리량–정확도 파레토 프론티어를 더 넓은 벤치마크에서 체계적으로 검증해, 시스템 최적화가 라우팅 품질을 훼손하지 않음을 확증하는 작업.
논문 원문의 표
arXiv e-print 의 LaTeX 원본에서 기계적으로 옮긴 표입니다. 숫자는 논문의 값이며 모델을 거치지 않았습니다.
표 1. Routing behavior of the evaluated token-level routing algorithms. Each entry under Model $i$ or Model $j$ specifies the condition under which that model routes generation to another model.
| Algorithm | #Models | Model $i$ | Model $j$ |
|---|---|---|---|
| CITER | 2 | low-confidence token | after one token |
| R2R | 2 | predicted-divergent token | after one token |
| R-Stitch | 2 | high-entropy token | low-entropy token |
| Co-LLM | 2 | high-deferral token | after one token |
| ME | $\geq$2 | after every token, according to ensemble weights |
표 2. TTFT, throughput, and end-to-end latency at concurrency 4, comparing across serving systems under original settings.
| Algorithm | Implementation | Throughput/(token/s) | TTFT/s | Latency/s |
|---|---|---|---|---|
| R2R | LLM-only | 145.30 | 0.13 | 411.98 |
| Official Code | 89.62 | 0.11 | 751.15 | |
| TokenRouter | 244.56 | 0.11 | 270.19 | |
| CITER | LLM-only | 123.72 | 0.083 | 2.68 |
| Official Code | 17.16 | 0.036 | 7.64 | |
| TokenRouter | 149.31 | 0.036 | 0.48 | |
| Co-LLM | LLM-only | 134.79 | 0.069 | 13.39 |
| Official Code | 3.46 | 1.14 | 247.61 | |
| TokenRouter | 76.02 | 0.067 | 11.46 | |
| R-Stitch | LLM-only | 150.41 | 0.15 | 360.76 |
| Official Code | N/A | N/A | N/A | |
| TokenRouter | 140.58 | 0.067 | 151.30 |
표 3. Model pairs and benchmarks used by different token-level routing algorithms.
| System | Model Pair | Benchmark |
|---|---|---|
| R2R | DeepSeek-R1-Distill-Qwen-1.5B / 32B | AIME |
| CITER | Qwen2-1.5B / 72B | CommonsenseQA |
| Co-LLM | LLaMA2-7B (tuned) / 70B | GSM8K |
| R-Stitch | L1-1.5B-Short / QwQ-32B | AIME |
표 4. TTFT, throughput, and end-to-end latency at concurrency 1, comparing across serving systems under original settings.
| Algorithm | Implementation | Throughput/(token/s) | TTFT/s | Latency/s |
|---|---|---|---|---|
| R2R | LLM-only | 40.17 | 0.074 | 388.12 |
| Official Code | 54.77 | 0.12 | 330.69 | |
| TokenRouter | 105.81 | 0.11 | 144.10 | |
| CITER | LLM-only | 34.40 | 0.055 | 2.42 |
| Official Code | 14.26 | 0.031 | 2.41 | |
| TokenRouter | 50.63 | 0.031 | 0.36 | |
| Co-LLM | LLM-only | 36.06 | 0.049 | 12.66 |
| Official Code | 2.80 | 0.34 | 76.68 | |
| TokenRouter | 28.57 | 0.068 | 7.60 | |
| R-Stitch | LLM-only | 40.82 | 0.072 | 341.84 |
| Official Code | N/A | N/A | N/A | |
| TokenRouter | 55.78 | 0.102 | 119.29 |
표 5. Ablation study of different optimization components. Throughput is reported in token/s.
| Method | $N=8$ | $N=4$ | $N=1$ |
|---|---|---|---|
| TokenRouter | 372.48 | 210.61 | 73.02 |
| - Delayed batching | 296.86 | 161.26 | 73.02 |
| - Async execution | 230.79 | 143.88 | 73.02 |
| - Router CUDA graph | 228.10 | 142.33 | 72.62 |
| - LLM CUDA graph | 164.08 | 95.55 | 51.22 |
| - SLM CUDA graph ($\approx$ R2R) | 132.78 | 75.54 | 34.20 |
| R2R official code | 134.89 | 73.27 | 36.17 |
표 6. Throughput across parallel strategies. Throughput is reported in token/s.
| Total | #SLM | #LLM | Overlap | $N{=}1$ | $N{=}4$ |
|---|---|---|---|---|---|
| 2 | 1 | 1 | $\times$ | 50.37 | 160.74 |
| 1 | 2 | $\checkmark$ | 70.83 | 197.40 | |
| 2 | 2 | $\checkmark$ | 71.41 | 198.13 | |
| 8 | 4 | 4 | $\times$ | 93.23 | 284.62 |
| 1 | 8 | $\checkmark$ | 109.67 | 296.34 | |
| 2 | 8 | $\checkmark$ | 106.02 | 289.08 | |
| 4 | 8 | $\checkmark$ | 110.02 | 297.63 | |
| 8 | 8 | $\checkmark$ | 105.59 | 288.35 |
표 7. Throughput (token/s) comparison across routing strategies under different concurrency and overlap settings.
| Setup $N$ | Setup Deployment | Routing Algorithm R2R | Routing Algorithm R-Stitch | Routing Algorithm Co-LLM | Routing Algorithm CITER |
|---|---|---|---|---|---|
| 1 | Overlapping | 73.27 | 43.06 | 47.46 | 102.29 |
| Non-overlapping | 74.90 | 47.53 | 48.25 | 108.65 | |
| 4 | Overlapping | 205.05 | 108.42 | 165.96 | 281.27 |
| Non-overlapping | 228.94 | 116.14 | 170.20 | 308.36 |
표 8. Throughput comparison across single-node and multi-node settings.
| Setup $N$ | Setup Deployment | Routing Algorithm R-Stitch | Routing Algorithm R2R | Routing Algorithm CITER |
|---|---|---|---|---|
| 1 | Single-node | 47.53 | 74.90 | 108.65 |
| Multi-node | 46.19 | 69.92 | 93.99 | |
| 4 | Single-node | 116.14 | 228.94 | 308.36 |
| Multi-node | 104.20 | 202.43 | 277.56 |
이 글의 그림은 arXiv:2610.12242 원본에서 가져왔습니다 (CC BY 4.0). 크기와 형식만 바꿨습니다.
댓글