고정점(fixed point)에서 루프 모델 다시 생각하기 — 재귀 비용을 지우는 네 가지 지름길
한 줄 요약 (TL;DR)
루프형(looped) 언어 모델은 재귀 깊이가 깊어질수록 상태가 고정점 $z^\star = F_\theta(z^\star; x)$에 수렴하는데, 고정점 근처에서는 “끝점"이 전체 궤적을 대신할 수 있다. 이 논문은 그 성질 하나로 사전학습·서빙·RL의 네 가지 비용을 한꺼번에 줄인다: (1) 학습은 마지막 $b$개 재귀만 역전파(truncated BPTT), (2) 디코딩은 각 토큰의 마지막 KV 뱅크만 캐시(터미널 KV 공유, 캐시 $3\times$ 절감), (3) 프리필은 고정점을 직접 예측하는 경량 학생으로 증류해 최대 $1.79\times$ 가속, (4) RL은 저장된 롤아웃 상태에서 그래디언트를 재사용해 업데이트를 $2\times$ 가속. 그리고 이 고정점을 실제로 만들어내는 두 장치 — 깊이 사전(depth prior)과 입력 주입(input injection) — 를 각각 “학습형 사전"과 “직교 주입(OrthoInj)“으로 개선해, 100M부터 1.6B 파라미터까지 전 구간에서 퍼플렉서티를 낮췄다 (근거: §1).
핵심 아이디어
이 연구의 주장은 한 문장으로 요약된다: “고정점을 만드는 학습만 제대로 하면, 루프 모델이 지불하던 ‘깊이에 비례하는 비용’을 대부분 제거할 수 있다.”
구체적으로는 두 갈래로 나뉜다.
- 고정점이 주는 네 가지 지름길 (근거: §3): 끝점이 궤적을 대신할 수 있다는 사실이 학습·추론·포스트트레이닝 각 단계에서 비용 절감으로 직결된다는 것을 이론(Lemma)과 실험으로 보인다.
- 고정점을 만드는 두 장치의 개선 (근거: §4): 고정점을 실제로 형성하는 것은 깊이 사전(어느 깊이에서 감독을 받는가)과 입력 주입(입력이 고정점에 어떻게 남는가)인데, 기존 선택지(Huginn의 PLN 사전, Parcae의 주입)는 각각 한계가 있어 이를 학습형 사전과 직교 주입으로 바꾼다.
배경: 그들이 해결한 문제
루프 모델은 “깊이"가 곧 비용이다
루프형 언어 모델은 동일한 레이어 블록을 반복 적용한다 (근거: §2). Universal Transformer에서 시작해 최근 Huginn, Ouro 등이 테스트타임 컴퓨트 확장과 잠재적 추론(latent reasoning)에 쓰고 있다. 그런데 이 구조의 본질적인 비용은 “반복할 때마다” 발생한다 (근거: §1):
- 학습: 전체 재귀를 저장·역전파해야 하므로 활성화 메모리가 깊이에 비례한다.
- 디코딩: 각 재귀가 자기만의 KV를 쓰므로 KV 캐시가 깊이에 비례해 커진다.
- 프리필: 프롬프트 토큰마다 모든 재귀를 돌려야 한다.
- RL: 롤아웃마다 재귀를 다시 실행해 스코어링해야 한다.
“고정점을 배워야 하는가"는 아직 결론이 안 났다
학계는 두 진영으로 갈린다 (근거: §1). 한쪽은 고정점을 포기하고 루프 수를 작게 고정한다(Loopie, Smelt, Ouro). 다른 쪽은 고정점을 의도적으로 형성해 깊게 루프한다(DEQ, STaR, EQR 계열). 이 논문은 고정점이 비용 절감의 열쇠라는 후자 진영의 입장을 밀고 나간다.
핵심 관찰은 실증적이다. 터미널 KV 공유(마지막 KV만 재사용)는 Huginn에서는 GSM8K 성능을 거의 안 떨어뜨리지만, Ouro에서는 네 루프에서 붕괴한다. 이 차이는 수렴 여부와 정확히 일치한다: Huginn의 상태는 고정점에 접근하고, Ouro의 상태는 그렇지 않다 (근거: §1, §2).
고정점이란 무엇인가
입력 $x=(x_1,\dots,x_N)$에 대해 $r$번 재귀한 상태를 $z^r=(\mathbf{H}^r, C^r)$라 하자. $\mathbf{H}^r$는 은닉 상태, $C^r$는 $r$번째 업데이트 때 기록된 KV 뱅크다. 공유된 업데이트 맵 $F_\theta$가 $z^{r+1}=F_\theta(z^r;x)$를 정의하고, $F_\theta(z^\star;x)=z^\star$를 만족하면 $z^\star$가 고정점이다 (근거: §2).
수렴은 토큰별 상대 변화량 $\rho_{r,t}=\lVert h_t^r-h_t^{r-1}\rVert_2/(\lVert h_t^{r-1}\rVert_2+\epsilon)$ ($\epsilon=10^{-8}$)로 측정한다. 중요한 발견: 수렴은 이질적(heterogeneous) 이다. 같은 시퀀스 안에서도 토큰마다 서로 다른 깊이에서 수렴하고, 인과적 순서도 아니며, 수렴 깊이와 위치의 Spearman 상관은 $0.14$로 약하다 (근거: §2). 이 이질성이 바로 “어느 깊이에서 감독을 받는가"가 중요한 이유다.
실험 모델 구성
실험은 Huginn을 기반으로 한 밀집 Llama 블록 루프 모델에서 이뤄진다 (근거: §5.1, Tab. 1). 레이아웃은 1+2×R+1: 프리루드(prelude) 블록 1개 → 2-블록 재귀 코어를 $R$번 반복 → 코다(coda) 블록 1개. 즉 $R=5$ 재귀면 논리적 깊이 $12$ 블록이 된다. 규모는 Small(100M, 21.5B 토큰), Medium(400M, 85.9B), Large(1.6B, 343.6B) 세 가지다. Jais64k 토크나이저, TxT360 다국어 혼합 데이터, 시퀀스 길이 8,192, WSD 스케줄의 AdamW를 쓴다.
새로운 접근법: 학습형 깊이 사전(Learned Depth Prior) + 직교 입력 주입(OrthoInj)
고정점의 이점을 실제로 얻으려면 학습이 고정점을 형성해야 한다. 그 형성을 좌우하는 두 장치가 깊이 사전과 입력 주입이고, 이 논문은 둘 다 개선한다.
1) 학습형 깊이 사전 — “어느 깊이에서 감독할까"를 학습한다
샘플링된 학습 깊이는 “감독이 도달했을 때 상태가 얼마나 수렴했는가"를 결정하고, 따라서 터미널 KV 공유에 얼마나 잘 견디는가를 결정한다 (근거: §4.1).
- 고정 깊이 학습: 한 깊이에 감독을 집중하므로 그 깊이에서 예측은 최고지만, KV 공유를 깨뜨린다. 1.6B 모델에서 공유 시 GSM8K가 $50.6 \to 21.2$로 반토막 난다 (근거: §1).
- Huginn의 PLN 사전: 시프트된 포아송–로그정규 분포로 깊이를 퍼뜨려 공유를 지원하지만, 목표 깊이에서의 감독을 공유가 요구하는 수준 이상으로 희석한다.
따라서 저자들은 깊이 사전을 학습한다. PLN 대신 깊이 집합 $\mathcal R=\{1,\dots,R_{\max}\}$ 위의 범주형 분포 $p_\phi=\operatorname{softmax}(\phi)$를 두고, 예측 피드백으로 로짓 $\phi$를 갱신한다 (근거: §4.1, Alg. 1):
$$ \mathcal J_{\mathrm{prior}}(\phi) = -\widehat{\mathbb E}{n}\bigl[\operatorname{sg}(A_n)\log p\phi(r)\bigr]
- \lambda_H, H(p_\phi)
- \lambda_m\bigl(\mathbb E_{p_\phi}[R] - \bar R\bigr)^2 $$
세 항의 역할은 명확하다.
- 예측 품질: 마이크로배치마다 깊이 $r$를 뽑고, 그 깊이의 다음-토큰 CE $\ell$을 보상 $u=\exp(-\ell)$(역퍼플렉서티)로 매핑한 뒤, EMA 베이스라인으로 센터링하고 PopArt 방식으로 재스케일한 어드밴티지 $A_n$을 곱한다. 잘 예측하는 깊이의 확률이 올라간다.
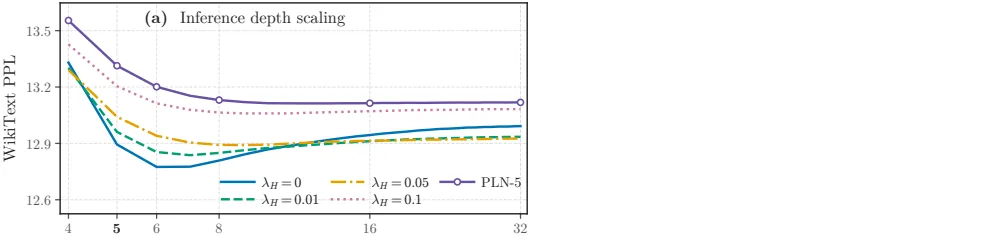
- 엔트로피 정규화 $H(p_\phi)=-\sum_r p_\phi(r)\log p_\phi(r)$: 피드백만 두면 감독이 좁은 깊이에 집중돼 고정점 형성이 약해진다. $\lambda_H$를 키우면 할당이 위쪽 깊이(정착된 프리픽스 컨텍스트가 공유를 지원하는 영역)로 퍼진다. 즉 $\lambda_H$는 성능 vs 메모리 효율을 조절하는 손잡이다.
- 예산 제어: 기대 깊이가 목표 $\bar R$에서 벗어나지 않게 잡는다. 사전은 학습에서만 쓰이므로, 이 항이 순전파 연산량을 $\bar R$에 고정한다.
이 사전은 RL-Halting·Ouro의 “상태 의존적 엑시트 분포"와 달리 무조건부라서 (1) 미리 정해진 사전(PLN)에서 시작할 수 있고, (2) 샘플링한 깊이까지만 순전파를 돌려 연산을 아끼며, (3) 추론의 정지 지점을 결정하지 않아 엔트로피 항이 KV 공유를 의도적으로 키운다 (근거: §6, Appx.).
2) 직교 입력 주입(OrthoInj) — “입력이 고정점에 그대로 남게” 한다
입력 주입은 임베딩을 모든 재귀에 더해 고정점이 입력에 조건화되게 만든다. 일반적인 덧셈 형태는 $\zeta_t^r = M h_t^r + q_t$다 (근거: §4.2). 여기서 $M$은 상태 이월(carryover)을, $q_t$는 주입 벡터를 제어한다. Parcae는 대각 이월 $M=\Lambda=\operatorname{diag}(\exp(-\Delta\odot\alpha))$ ($\Lambda$의 항은 $(0,1)$, $\lVert\Lambda\rVert_2<1$)를 쓴다.
문제는 이월 $\Lambda h_t^r$이 주입 벡터 $q_t$ 방향 성분을 가질 수 있다는 점이다. 이 성분의 부호에 따라 입력을 증폭하거나 상쇄한다. 실측으로 Parcae-Decay에서 이월과 $q_t$의 코사인은 S/M/L에서 각각 $0.81/0.87/0.91$에 달해, 입력이 주입된 크기의 $2.2\times/2.8\times/3.4\times$로 코어에 들어간다 (근거: Appx.). OrthoInj는 이 성분을 투영해 제거한다:
$$ \zeta_t^r = Q_{q_t}\Lambda h_t^r + q_t, \qquad Q_{q_t} = I - \frac{q_t q_t^{\top}}{\lVert q_t\rVert_2^2 + \epsilon} $$$Q_{q_t}$는 $q_t$ 방향 성분을 지우는 투영이다. 결과적으로 모든 재귀(고정점 포함)에서 $\zeta_t^r$의 $q_t$ 방향 성분은 정확히 $q_t$ 가 되고, 직교 성분만 자유롭게 진화한다. $\lVert Q_{q_t}\rVert_2\le1$이므로 이월의 수축성($\lVert Q_{q_t}\Lambda\rVert_2\le\lVert\Lambda\rVert_2<1$)도 보존된다.
작동 원리: 구체적인 예시로 살펴보기
토이 예제: 수축 맵의 고정점
아이디어를 아주 단순한 1차원 맵으로 보자. 상태 갱신이 $z^{r+1} = 0.5\, z^r + 3$이고 $z^0=0$이라면, 고정점은 $z^\star = 0.5 z^\star + 3 \Rightarrow z^\star = 6$이다. 반복을 돌리면:
| $r$ | 0 | 1 | 2 | 3 | 4 | 5 | … |
|---|---|---|---|---|---|---|---|
| $z^r$ | 0 | 3 | 4.5 | 5.25 | 5.625 | 5.8125 | $\to 6$ |
수축 계수 $a=0.5<1$ 때문에 인접 상태의 차이는 기하급수적으로 줄어든다: $|z^{r+1}-z^r|=0.5^r \cdot 3$. 즉 고정점 근처에서는 더 돌려도 상태가 거의 안 변한다. 이것이 이 논문의 모든 지름길이 공유하는 원리다: 궤적 대신 끝점 $z^\star$를 써도 된다.
그래디언트 관점에서도 같은 이야기다. 손실을 $z^\star$에 대해 미분하면 $\mathrm dz^\star/\mathrm d b = 1/(1-a)=2$인데, 이는 Neumann 급수 $1+a+a^2+\cdots$의 합이다. 실제 학습에서는 이 무한 합을 $b$항에서 잘라도 되고(트렁케이션), 그 오차 $a^b$는 $b$에 대해 기하급수적으로 줄어든다 (근거: §3.1).
이 원리가 네 지름길이 되는 과정
학습 — 트렁케이티드 BPTT: $R$번 전부 역전파하는 대신 마지막 $b$번만 역전파해도 된다. 고정점 근처에서 방문 상태들이 $z^\star$로 수렴하므로, TBPTT의 그래디언트는 평형 그래디언트(implicit gradient)의 절단 Neumann 추정에 수렴한다 (근거: §3.1, eq. 1). 놀라운 것은 트렁케이션 자체가 고정점을 형성한다는 점이다. $R=5$ 고정 깊이에서 전체 BPTT는 $R=64$로 외삽 시 퍼플렉서티가 $25\%$ 이상, 터미널 KV 공유 시 $21\%$ 오르는 반면, 마지막 2개만 역전파하는 TBPTT($b=2$)는 각각 $2\%$, $3\%$ 이하로 오른다 (근거: §3.1).
디코딩 — 터미널 KV 공유: 각 프리픽스 토큰의 마지막 KV 뱅크만 유지하고, 이후 토큰의 모든 재귀가 그것을 읽는다. $R=5$에서 $12$개 뱅크 중 $4$개만 유지해 캐시가 $3\times$ 줄고, 퍼플렉서티 증가는 $0.85\%$ 이하다 (근거: §3.2). 이론적으로는 Lemma가 뒷받침한다: 프리픽스 KV가 $C^\star_{
프리필 — 증류: 디코딩이 마지막 뱅크만 읽으니, 프리필은 “각 재귀의 KV를 전부 재현"할 필요 없이 끝점만 예측하면 된다. 경량 학생 $S_\psi$가 프리루드 출력 $e$로부터 $\widehat z = S_\psi(e)\approx z_\theta^R(x)$를 예측하고, 교사가 $\widehat z$에 재귀를 한 번만 적용해 모든 KV 뱅크를 만든다. 손실은 정규화된 은닉 상태 회귀 + 다음-토큰 KL이다:
$$ \mathcal L_{\mathrm{distill}}(\psi) = \mathbb E_x\left[ \frac{\lVert\widehat z - z_\theta^R(x)\rVert_F^2}{N d \sigma_T^2}
- \frac{1}{N}\sum_{t=1}^{N}\operatorname{KL}\bigl(p_t ,\Vert, \widehat p_t\bigr) \right] $$
학생은 교사의 재귀 코어에서 초기화되므로, 학습 전에는 대략 “1회 재귀 후 상태"를 출력하고, 손실이 이를 깊이-$R$ 끝점으로 밀어낸다 (근거: §3.2, §5.5).
- RL — 롤아웃 상태 재사용: RL은 보통 순전파를 두 번(샘플링 1회, 스코어링 1회) 돈다. 고정점 근처에서는 저장된 끝점 $z^R$에서 바로 Neumann-$(b-1)$ 그래디언트를 계산해 재귀를 다시 실행하지 않는다 (근거: §3.1, Alg. 2). 재귀 블록을 $z^R$에서 한 번만 돌려 그 autograd 그래프를 기록하고, $v \leftarrow g + J_R^{\top} v$를 $b-1$번 반복해 그래디언트를 얻는다. 업데이트 비용이 $R$과 무관해진다.
성능 검증: 주요 결과
깊이 사전: 공유를 유지하면서 전 규모에서 우월
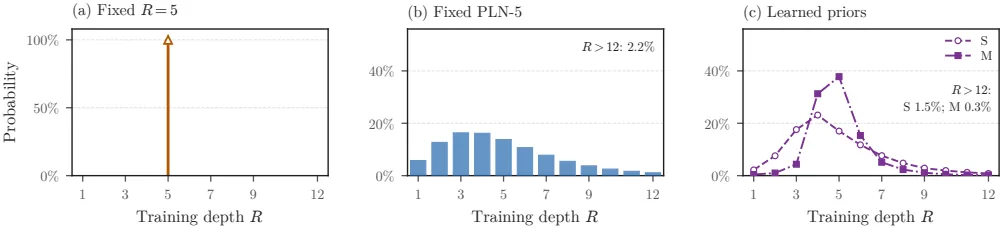
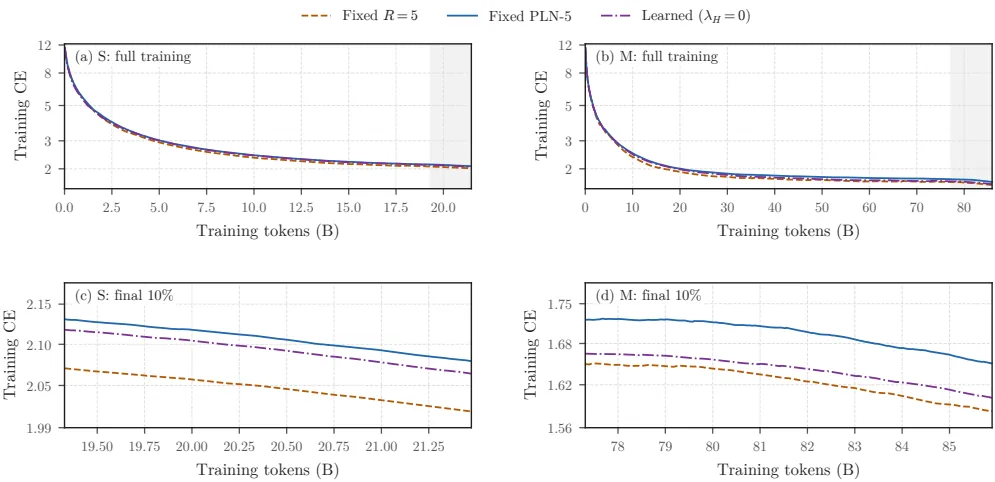
네 가지 사전(고정 $R{=}5$, 고정 PLN-5, 학습형 $\lambda_H{=}0$, 학습형 $\lambda_H{=}0.01$)을 평균 깊이 5로 비교했다 (근거: §5.2, Tab. 3).
- 고정 깊이 학습은 KV 공유를 깨뜨린다: M·L에서 공유 시 GSM8K가 반 이하로 떨어지고, 퍼플렉서티가 가장 높다.
- 학습형 사전은 고정 PLN-5 대비 검증 PPL을 $0.7$–$1.8\%$ 낮춘다 (최대 $1.6\%$의 학습 FLOPs만 더 쓰고), 다운스트림 평균도 모든 규모에서 높다.
- 엔트로피 항은 L에서 필수다: 없으면 GSM8K가 $47.92 \to 36.47$로 떨어진다 (근거: §5.2).
- 같은 물리 깊이의 Untied 4를 압도하고, 같은 논리 깊이의 Untied 12에 근접한다: 다운스트림 평균 리드는 S→M→L에서 $2.2 \to 5.0 \to 8.9$ 포인트로 커진다. L에서 Untied 12와의 격차는 다운스트림 평균 $1.5$, GSM8K $0.9$ 포인트로 좁아진다 (근거: §5.2).
즉, 1.6B에서 학습형 사전은 $3\times$ 작은 KV 캐시로, 전체 캐시를 쓰는 고정 깊이 학습의 다운스트림 평균에 맞먹는다 (근거: §1, Tab. 3).
학습 곡선과 깊이 분포는 아래 그림이 보여준다. 고정 깊이는 한 점에 몰리고, 고정 PLN은 넓게 퍼지며, 학습형 사전은 그 사이에서 “예측이 좋은 깊이"로 질량을 옮긴다.
엔트로피 계수 $\lambda_H$를 $0$에서 $0.1$로 키우면 $p_\phi(5)$가 $67.4\% \to 14.0\%$로 줄면서 감독이 위쪽 깊이로 퍼진다. 그 결과 KV 공유 페널티는 단조 감소(공유 시 $+0.96\% \to -0.22\%$)하고, $R=5$에서의 PPL은 약간 오르지만 깊은 깊이($R=32$)에서의 PPL은 낮아진다 — 성능과 메모리 사이의 명확한 트레이드오프다 (근거: Appx.).
직교 주입: 가장 강한 베이스라인(Parcae)을 넘다
OrthoInj는 DEQ-QKV, Huginn-Linear, Parcae-Decay와 비교해 (근거: §5.3, Tab. 2):
- 검증 PPL을 최강 베이스라인 Parcae-Decay보다 $0.3$–$1.4\%$ 낮춘다.
- 모든 규모에서 다운스트림 평균이 가장 높고, 학습 종료 시점의 학습 손실도 전 규모에서 가장 낮다.
두 스위치(직교 투영, 프리루드 RMSNorm 제거) 각각이 손실을 낮추고, 그 효과가 더해진다 (근거: Appx.).
RL: 롤아웃 상태 재사용이 업데이트를 $2\times$ 가속
L 학습형 사전 모델을 Dr. GRPO로 $R=6$에서 파인튜닝해 비교했다 (근거: §5.4, Tab. 4).
- 재사용 + Neumann-4는 스코어링·역전파 시간을 $1.99\times$ (GSM8K), $2.02\times$ (MBPP+) 단축한다.
- 네 방법 모두 GSM8K pass@1을 $40.6\% \to 60$–$63\%$, MBPP+를 $30.9\% \to 37$–$41\%$로 올린다.
- 정확도는 BPTT와 런-투-런 편차 내: 재사용과 재계산 컨트롤의 그래디언트 코사인은 $0.997$–$0.999$로 사실상 동일해, pass@1 격차($1.6$점 GSM8K)는 런 간 변동 수준이다 (근거: §5.4).
- RL에서 학습하지 않은 MATH500으로도 $3.9$–$5.4$ 포인트 전이가 일어난다.
증류 프리필: 지연 시간을 정확도와 맞바꾸다
학습형 사전 모델을 2-블록 학생으로 증류했다(교사 사전학습 토큰의 $1/4$만 사용) (근거: §5.5, Tab. 5).
- 8K 프롬프트에서 최대 $1.79\times$ 빠른 프리필 (S $1.55\times$, M $1.66\times$, L $1.79\times$).
- 다운스트림 평균 손실은 $1.0$ (S), $2.3$ (M), $4.5$ (L) 포인트로 규모가 클수록 커진다.
- 같은 지연 시간에서 교사를 일찍 멈추는 것보다 낫다: $R=2$ 교사 대비 $0.5$–$0.9$ 포인트 높다.
- 교사 초기화가 품질의 핵심이고, KL 항이 생성 성능을 끌어올린다 (근거: Tab. 6).
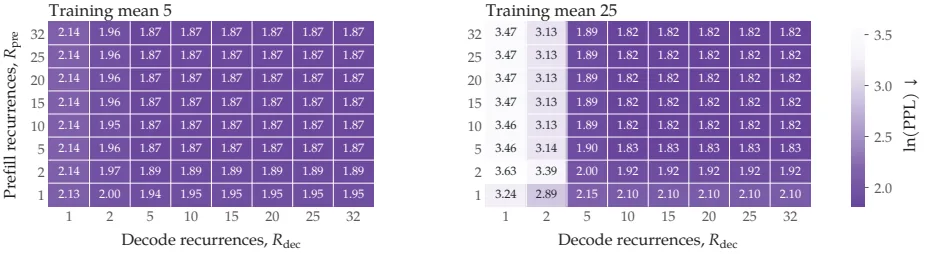
프리필 깊이와 디코드 깊이를 분리할 수 있다는 것(터미널 공유 덕분)도 흥미로운 결과다. 아래 그림처럼 프리필 이득은 $R_{\mathrm{pre}}=5$에서 포화하는 반면, 디코드 깊이는 훨씬 더 큰 영향을 준다 (근거: Appx.).
우리의 관점: 강점, 한계, 그리고 이 연구가 중요한 이유
강점: 하나의 원리로 여러 문제를 관통한다
이 논문의 가장 큰 미덕은 하나의 개념(고정점)으로 네 개의 서로 다른 비용 문제를 정리했다는 점이다. 트렁케이티드 BPTT와 터미널 KV 공유는 기존에 이미 쓰이던 지름길인데, 저자들은 “왜 이게 되는가"를 고정점 수렴이라는 단일 프레임워크로 설명하고, 여기서 자연스럽게 두 개의 새로운 지름길(증류 프리필, 롤아웃 상태 재사용) 을 도출해낸다 (근거: §1, §3). 설명력이 곧 새로운 발명으로 이어지는 드문 구조다.
이론과 실험의 정합성도 높다. Lemma는 “프리픽스가 수렴하면 터미널 공유가 손실 없이 성립한다"는 극한을 증명하고, 실험은 $R$이 커질수록 공유 페널티가 $0.85\%$에서 $0.11\%$로 줄어드는 것을 보여줘 정성적으로 일치한다 (근거: §3.2, Appx.).
마지막으로, “고정점을 형성하는 것은 트렁케이션·깊이 사전·주입 같은 학습 설계다"라는 프레이밍은 실용적으로 매우 강력하다. 단순히 $b$를 줄이는 것만으로 고정점이 생기고, 그 위에 학습형 사전과 직교 주입이 얹혀지는 식으로, 각 개선이 명확한 메커니즘으로 연결된다.
한계: 규모와 실증의 한계는 분명하다
비판적으로 볼 지점도 명확하다.
- 규모: 최대 $1.6$B 파라미터, 구성당 단일 시드, 단일 다국어 혼합 데이터다. 7B 이상에서도 이 이득이 유지될지는 열려 있다 (근거: §7).
- 증류 격차의 스케일링: 증류 프리필의 다운스트림 손실이 S→M→L에서 $1.0 \to 2.3 \to 4.5$ 포인트로 규모가 클수록 커진다. 이 추세가 계속되면 대형 모델에서 증류의 매력이 약해질 수 있고, 저자들도 이를 명시적으로 인정한다 (근거: §5.5, §7). 실제로 $R=25$ 교사 증류는 더 빨라지지만 품질 손실이 더 크다.
- 평가 폭: 다운스트림은 비교적 “쉬운” 과제(LAMBADA, PIQA, ARC 등) 중심이고, 강한 추론 벤치마크(코딩·수학 하드)에서의 검증은 제한적이다.
- 가정: 이론(Lemma)은 수축성($\kappa<1$)과 국소 Lipschitz 조건에 의존하는데, 실제 대형 트랜스포머에서 이를 검증하거나 보장하는 것은 별개 문제다.
왜 중요한가
“추론 비용을 깊이에서 떼어낸다"는 목표는 오늘날 LLM 서빙·에이전트 시대에 직접적인 가치를 가진다. 특히 터미널 KV 공유로 캐시를 $3\times$ 줄이면서 정확도를 거의 유지한다는 결과와, RL 업데이트를 $2\times$ 가속한다는 결과는 각각 메모리 병목과 포스트트레이닝 병목이라는 실무의 두 고통점을 정면으로 겨냥한다. 게다가 이 프레임워크는 특정 모델(Huginn)에 국한되지 않고, 상태가 수렴하는 재귀 구조 일반에 적용 가능하다.
다음 단계는?: 앞으로의 길
저자들이 직접 남긴 열린 질문과, 한계에서 자연스럽게 도출되는 방향을 정리하면:
- 더 큰 규모: 1.6B를 넘어 7B 이상에서 네 지름길이 어떻게 스케일하는지가 최우선 검증 과제다 (근거: §7).
- 더 나은 증류: MoE 학생 아키텍처, 증류 토큰 예산의 재배분, 더 나은 손실 목적이 증류 격차를 줄일 수 있다. 나아가 학생을 독립 언어 모델이나 추측 디코딩의 드래프터로 쓰는 것, 재귀 상태 정제와 flow 기반 언어 모델링의 연결도 저자가 남긴 미래 과제다 (근거: §5.5, §3.2).
- 강건성과 실무 배포: 단일 시드, 단일 데이터라는 한계를 넘어 여러 구성·데이터에서의 재현과 실서비스 배치 가능성 검증이 필요하다 (근거: §7).
한 문장으로 갈무리하자면, 이 논문은 “루프 모델의 고정점"이라는 다소 학술적인 개념을, 학습·서빙·포스트트레이닝의 비용을 동시에 줄이는 실용적 엔진으로 탈바꿈시켰다. 그 성과가 대규모에서도 견고하게 유지되느냐가 이 접근의 운명을 결정할 것이다.
논문 원문의 표
arXiv e-print 의 LaTeX 원본에서 기계적으로 옮긴 표입니다. 숫자는 논문의 값이며 모델을 거치지 않았습니다.
표 1. Evaluation tasks. Choice tasks are zero-shot and score candidates by log likelihood (length-normalized for HellaSwag and ARC-C, summed otherwise). Generation tasks decode greedily except MBPP+, which averages eight samples at temperature $0.8$.
| Task | Split | Metric | Examples | Shots | Used in |
|---|---|---|---|---|---|
| LAMBADA (OpenAI) | test | accuracy, last-word PPL | 5,153 | 0 | main tables |
| HellaSwag | validation | accuracy | 10,042 | 0 | main tables |
| PIQA | validation | accuracy | 1,838 | 0 | main tables |
| ARC-Easy | test | accuracy | 2,376 | 0 | main tables |
| ARC-Challenge | test | accuracy | 1,172 | 0 | main tables |
| OpenBookQA | test | accuracy | 500 | 0 | main tables |
| SciQ | test | accuracy | 1,000 | 0 | main tables |
| WinoGrande | validation | accuracy | 1,267 | 0 | app:prior-results, app:architecture-results |
| DROP | frozen subset | F1 | 500 | 3 | main tables |
| GSM8K | test | accuracy | 1,319 | 8 | main tables, app:posttraining |
| MBPP+ v0.2.0 | frozen subset | pass@1 | 100 | 3 | main tables, app:posttraining |
표 2. Model configurations at three scales. Blocks count prelude, recurrent-core, and coda blocks of the looped models; Untied 4 and Untied 12 stack $4$ and $12$ blocks. Width and FFN give hidden and feedforward dimensions, and Q and KV give query and key–value head counts. Non-emb. and Total give Untied 4 parameter counts without and with embeddings; the looped rows add Huginn’s width$\times$width input adapter. The main text rounds the scales to $100$M, $400$M, and $1.6$B. Parameter and token counts are in billions; the peak learning rate is tuned per run (app:setup-lr).
| S | M | L | |
|---|---|---|---|
| A: Architecture and attention geometry Blocks (prelude/core/coda) | 1 / 2 / 1 | ||
| Width | 1,536 | 3,072 | 6,144 |
| FFN | 4,352 | 8,704 | 17,408 |
| Q heads | 24 | 48 | 96 |
| KV heads | 6 | 12 | 24 |
| Head dim. | 64 | 64 | 64 |
| B: Parameters (B) Non-emb. | 0.104 | 0.415 | 1.661 |
| Total | 0.301 | 0.810 | 2.451 |
| Looped non-emb. | 0.106 | 0.425 | 1.699 |
| Looped total | 0.304 | 0.819 | 2.488 |
| C: Batch and token budget Sequence length | 8,192 | ||
| Global batch (sequences) | 512 | ||
| Tokens per update | 4,194,304 | ||
| Updates | 5,120 | 20,480 | 81,920 |
| Tokens (B) | 21.47 | 85.90 | 343.60 |
| D: Optimizer Optimizer | AdamW | ||
| $(\beta_1,\beta_2)$ | $(0.90,\,0.98)$ | ||
| $\epsilon$ | $10^{-8}$ | ||
| Weight decay | 0.10 | ||
| Gradient clipping | 1.00 | ||
| LR schedule | WSD | ||
| Linear warmup | first 5% of updates | ||
| Cosine decay | last 10%, to $0.1\times$ peak |
표 3. Input-injection recipes. $e=P_\theta(x)$ is the prelude output, $\tilde e$ is the injected input, and RMSNorm uses learned gains. DEQ-QKV injects at internal sites (superscript $(j)$ indexes a recurrent layer); the others inject at the core entrance. $\Lambda=\operatorname{diag}(\exp(-\Delta\odot \alpha))$ with $\Delta=\operatorname{softplus}(\Delta_{\rm raw})$ and $\alpha=\exp(\alpha_{\rm raw})$, and OrthoInj applies $Q_q$ of equation with $q=\Delta\odot W\tilde e$ and $\epsilon=10^{-6}$.
| Injection recipe | Injected input $\tilde e$ | Input to recurrent core |
|---|---|---|
| DEQ-QKV | $e$ | $W_{\rm QKV}^{(j)}h^{r,(j)}+W_e^{(j)}\tilde e$ |
| Huginn-Linear | $e$ | $W_{\rm lin}[h^r;\tilde e;1]$ |
| Parcae-Decay | $\operatorname{RMSNorm}(e)$ | $\Lambda h^r+\Delta\odot W\tilde e$ |
| Parcae w/o norm | $e$ | $\Lambda h^r+\Delta\odot W\tilde e$ |
| OrthoInj (ours) | $e$ | $Q_q\Lambda h^r+q$ |
이 글의 그림은 arXiv:2610.06833 원본에서 가져왔습니다 (CC BY 4.0). 크기와 형식만 바꿨습니다.
댓글