arXiv:2610.05739 · Monash University · The University of Adelaide · Zhejiang University
한 줄 요약 (TL;DR)
비디오 세계 모델의 순환 선형 어텐션(Gated DeltaNet)은 메모리를 고정 크기 상태로 압축해 효율적이지만, 카메라가 떠났다 돌아왔을 때 멀리 있던 장면을 점점 잊어버린다. HLA-WM은 학습 없이(training-free), 청크 단위의 아핀(affine) 요약을 캐시하고 카메라 기하(프러스텀 겹침) 로 관련 장면을 검색해 재구성함으로써, 60초 롤아웃에서 PSNR +0.74 dB, 회전 오차 −28.5%, Full KV 대비 메모리 약 12× 절감(GDN 대비 약 6× 사용)을 달성한다 (근거: §Abstract, Fig. 1).
핵심 아이디어
재방문(revisit) 일관성을 유지하려면 “전체 이력에 대한 토큰 단위 KV 캐시"와 “단일 순환 상태” 사이의 중간 지점이 필요하다. HLA-WM의 핵심 주장은 다음과 같다:
GDN의 순환 상태 전이가 가진 아핀(affine) 구조를 활용해, 각 시간 청크를 하나의 전이 요약 $(A_i, B_i)$ 로 압축하고, 쿼리 시점의 카메라 기하와 겹치는 청크만 골라 시간순으로 재합성하면, 무관한 중간 장면이 끼워 넣는 감쇠를 우회할 수 있다.
즉, “기억을 저장하는 방식"을 바꾸는 것이 아니라 “기억을 주소 지정하고 접근하는 방식"을 바꾸는 훈련-무관 기법이다 (근거: §1, §4.1).
Key Numbers
| 항목 | 값 |
|---|---|
| 기반 모델 | SANA-WM 1.6B (Stage-1: 4-step 증류된 자기회귀 스트리밍) |
| 컨텍스트 | 961 프레임 @ 16 fps ≈ 60초, 해상도 1280×704 |
| 청크 구성 | 40개 청크, 청크당 약 24개 카메라 포즈 |
| 검색 예산 | 싱크 1 + 최근 1 + Top-$K$ (기본 $K{=}1$) |
| 하드웨어 | 단일 NVIDIA H200 (140 GB) |
| 메모리(60초) | HLA-WM 2.15 GiB vs Full KV 25.82 GiB vs GDN 0.359 GiB (12× 절감) |
| 처리량 손실 | 최대 1.6% (Stage-1 FPS 22.403 → 22.053) |
배경: 그들이 해결한 문제
세계 모델(world model)은 환경의 역학을 예측해 에이전트가 미래 관측과 행동의 결과를 시뮬레이션하게 한다. 최근의 비디오 세계 모델은 카메라 궤적이나 액션에 조건화된 자기회귀 생성으로 이를 구현한다 (근거: §1). 단기 시간 연속성을 넘어 장기 시뮬레이션이 되려면, “최근 컨텍스트를 벗어난 과거 장면"이 나중에 다시 복구 가능해야 한다. 카메라가 돌아왔을 때 모델은 의미상 비슷하지만 공간적으로 불일치한 뷰가 아니라 이전 장면 구조를 복원해야 한다 (근거: §1).
여기서 두 극단이 갈린다:
- 소프트맥스 어텐션 + Full KV 캐시: 전체 이력에 직접 접근하지만, 저장 비용이 롤아웃 길이에 비례해 계속 커진다 (근거: §1, Fig. 4).
- 순환 선형 어텐션: 이력을 고정 크기 상태로 압축해 메모리는 저렴하지만, 먼 정보가 후속 업데이트에 의해 감쇠·간섭에 취약해진다 (근거: §2).
저자들은 Gated DeltaNet(GDN)에서 장거리 망각(long-range forgetting) 문제를 정량적으로 포착한다. GDN의 청크 단위 순환 전이는 다음과 같다:
$$S_i = S_{i-1}A_i + B_i,$$여기서 $A_i$ 는 과거 메모리에 가해지는 상태 전이, $B_i$ 는 현재 청크가 새로 쓰는 정보이다. 이를 여러 청크로 풀면 (근거: §3, Eq. 1–2)
$$S_j = \cdots + B_i\,A_{i+1}A_{i+2}\cdots A_j + \cdots + B_j,$$즉 초기 청크 $i$ 가 쓴 정보 $B_i$ 는 이후의 모든 전이 행렬을 차례로 통과해야 멀리 떨어진 $j$ 에 영향을 줄 수 있다. 저자들은 이 감쇠를 평균 노름으로 측정한다:
$$W_{i\to j} = \mathrm{AvgNorm}(A_{i+1}A_{i+2}\cdots A_j).$$그 결과는 극적이다. 대표 궤적에서 카메라가 Chunk 3 지역을 떠나 큰 루프를 돌고 Chunk 35에서 인근 시점으로 복귀하는데, Chunk 3의 유지 영향력 $W_{3\to 35}$ 는 0.0416까지 떨어진다 (근거: Fig. 2). Chunk 3과 Chunk 35는 겹침이 큰 지역을 보지만, 중간의 무관한 시점들이 순차적으로 전이를 곱하며 원래 기억을 반복 변형시킨 것이다.
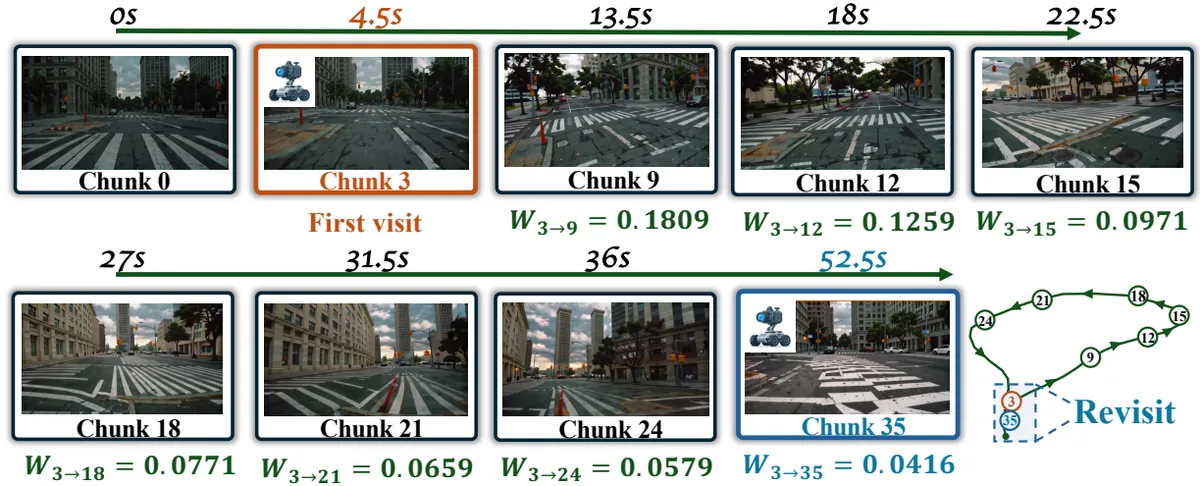
핵심 통찰: GDN 메모리는 “시간 진행"에 따라 갱신되는데, 세계 모델에서 정보의 관련성은 시간이 아니라 공간·기하 근접성으로 결정된다. 이 불일치가 망각의 근본 원인이다 (근거: §3).
새로운 접근법: HLA-WM
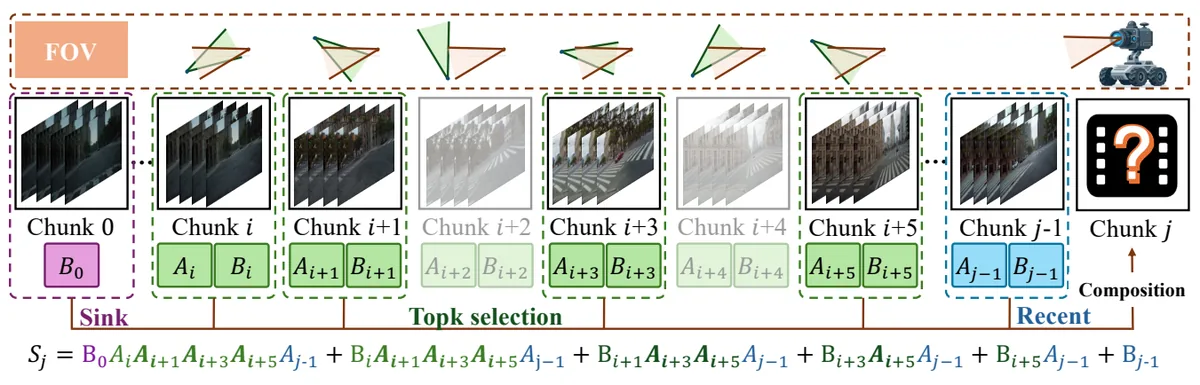
HLA-WM은 단일 누적 GDN 메모리를 독립적으로 주소 지정 가능한 청크별 메모리 컬렉션으로 대체한다 (근거: §4.1). 세 단계로 구성된다.
- 청크별 GDN 메모리 — 각 시간 청크를 하나의 아핀 전이 요약 $(A_i, B_i)$ 로 캐시한다.
- 기하 기반 검색 — 카메라 포즈·내적 파라미터·장면 중앙 깊이로 프러스텀 겹침 점수를 계산해 관련 청크를 고른다.
- 선택적 상태 재합성 — 선택된 요약을 시간순으로 합성해 쿼리 전용 순환 상태를 만든다.
작동 원리: 구체적인 예시로 살펴보기
1) GDN의 아핀 구조. 토큰 단위 GDN 업데이트는 다음과 같다 (근거: §4.2, Eq. 4):
$$S_t = \gamma_t S_{t-1} + \beta_t (v_t - S_{t-1}k_t)\, k_t^{\top},$$여기서 $k_t, v_t$ 는 현재 토큰에서 투영된 키·밸류, $\gamma_t$ 는 메모리 감쇠, $\beta_t$ 는 델타 업데이트 강도다. 이를 정리하면 아핀 형태 $S_t = S_{t-1}A_t + B_t$ 가 되고,
$$A_t = \gamma_t I - \beta_t k_t k_t^{\top},\qquad B_t = \beta_t v_t k_t^{\top}.$$청크 $i$ 안의 $L$ 개 토큰을 풀면, 청크 전체를 하나의 아핀 전이 $(A_i, B_i)$ 로 나타낼 수 있다. 이 요약들은 결합 법칙을 만족한다 (근거: Eq. 9):
$$(A_i, B_i) \star (A_j, B_j) = (A_i A_j,\; B_i A_j + B_j).$$이것이 핵심이다. 결합 법칙 덕분에 임의의 이력 청크 부분집합을 원본 시각 토큰을 다시 통과시키지 않고도 효율적으로 재합성할 수 있다 (근거: §4.2).
2) 기하 검색. 각 쿼리 청크 $q$ 와 이력 청크 $i$ 의 겹침은 RGB나 학습된 특징이 아니라 카메라 기하만으로 추정한다. 샘플 픽셀 위치 $(u,v)$ 에서 카메라 공간 광선을
$$r(u,v) = \Big[\tfrac{u-c_x}{f_x},\ \tfrac{v-c_y}{f_y},\ 1\Big]^{\top}$$로 만들고, 장면 중앙 깊이 주변 $D = \{0.5d_{\text{med}}, d_{\text{med}}, 1.5d_{\text{med}}\}$ 의 세 프록시 깊이에 3D 점을 뿌린 뒤, 상대 청크의 카메라 뷰로 투영해 가시 비율 $V$ 를 구한다. 대칭 프러스텀 겹침 점수는 (근거: §4.3, Eq. 12)
$$R(i,q) = \tfrac{1}{2}\big[V(i \to q) + V(q \to i)\big].$$3) 선택과 재합성. 첫 청크를 싱크(sink) 로 항상 유지하고, 최근 청크로 지역 연속성을 보존하며, 나머지 이력 중 $R(i,q)$ 상위 $K$ 개를 골라 (근거: Eq. 13)
$$I_q = I_{\text{sink}} \cup I_{\text{recent}} \cup \underset{i \in H_q}{\mathrm{TopK}}\; R(i,q),$$선택된 청크를 시간순으로 정렬해 합성한 뒤 쿼리 전용 이력 상태를 만든다 (근거: Eq. 17):
$$S_q^{\text{hist}} = S_0\, A_{\pi_q} + B_{\pi_q}.$$구체 예시. Fig. 2의 루프 궤적으로 돌아가 보자. 카메라는 Chunk 3(첫 방문) → Chunk 4~34(무관한 원거리 이탈) → Chunk 35(재방문) 순서로 돈다. 기존 GDN은 $S_{35}$ 를 만들 때 Chunk 3이 쓴 정보를 Chunk 4~34의 약 32개 전이에 차례로 통과시켜 $W_{3\to 35} = 0.0416$ 까지 깎는다. 반면 HLA-WM은 Chunk 35를 생성할 때 Chunk 3과의 프러스텀 겹침 $R(3, 35)$ 가 높음을 감지하고, Chunk 3의 요약 $(A_3, B_3)$ 를 싱크·최근 컨텍스트와 함께 골라 Chunk 4~34의 전이를 건너뛴 채 합성한다. 원거리이지만 관련 있는 기억이 재사용 전에 노출되는 무관한 전이의 수를 대폭 줄이는 셈이다 (근거: §4.4).
성능 검증: 주요 결과
실험은 SANA-WM-Bench(simple/hard 각 80궤적, 4개 장면 카테고리)와 MBench-A(547 샘플, 4개 서브셋)에서 진행됐고, 기반 모델은 공식 1.6B SANA-WM이다. HLA-WM은 Stage-1 메모리 메커니즘만 수정하고 파인튜닝은 하지 않는다 (근거: §5.1).
SANA-WM-Bench. Stage-1(순환 메모리를 직접 수정하는 단계)에서 HLA-WM은 두 스플릿의 재방문 일관성·카메라 제어 지표를 모두 개선한다 (근거: §5.2, Tab. 1):
| Pipeline | 지표 | SANA-WM | HLA-WM | Δ | |—|—:|—:|—:| | Hard · Stage-1 | PSNR ↑ | 9.37 dB | 10.11 dB | +0.74 dB | | Hard · Stage-1 | SSIM ↑ | 0.1774 | 0.1997 | +0.0223 | | Hard · Stage-1 | LPIPS ↓ | 0.6044 | 0.5848 | −0.0196 | | Hard · Stage-1 | RotErr ↓ | 20.38° | 15.09° | −26.0% | | Simple · Stage-1 | PSNR ↑ | 9.18 dB | 9.91 dB | +0.73 dB | | Simple · Stage-1 | RotErr ↓ | 19.70° | 13.59° | −31.0% |
즉 추상의 헤드라인 수치인 “PSNR +0.74 dB, 회전 오차 −28.5%“는 Hard(+0.74 dB, −26.0%)와 Simple(−31.0%)의 Stage-1 결과를 합친 것이다 (근거: §Abstract, §5.2). 흥미로운 점은 카메라 제어 지표도 함께 개선된다는 것이다. 보존된 장면 기하가 구조적 드리프트를 줄여 카메라 조건부 생성에 더 안정적인 공간 기준을 제공하기 때문이다 (근거: §5.2).
다운스트림 정제 후에도 유지. 양방향(bidirectional) 정제에서는 6개 지표 전부가 개선되고(PSNR +0.52/+0.46 dB, RotErr −22.0%/−20.1%), 인과 AR 정제에서도 재방문 일관성은 일관되게 좋아진다. 다만 정제 단계에서는 모드에 따라 일부 지표의 소폭 악화(Simple의 TransErr·CamMC)가 나타나는 트레이드오프가 있다 (근거: §5.2, Tab. 1).
일반화: MBench-A. 547 샘플 전체에서 세 가지 추론 모드 모두 PSNR·SSIM·LPIPS가 일관되게 개선된다. Stage-1에서 PSNR +0.84 dB, SSIM +0.0303, LPIPS −0.0428로 가장 큰 폭의 향상이 나타난다 (근거: §5.2, Tab. 2). 이득이 특정 서브셋에 몰리지 않고 12개 모드–서브셋 조합 전부에서 세 지표가 동시에 좋아진다 (근거: Appx. A.8.2).
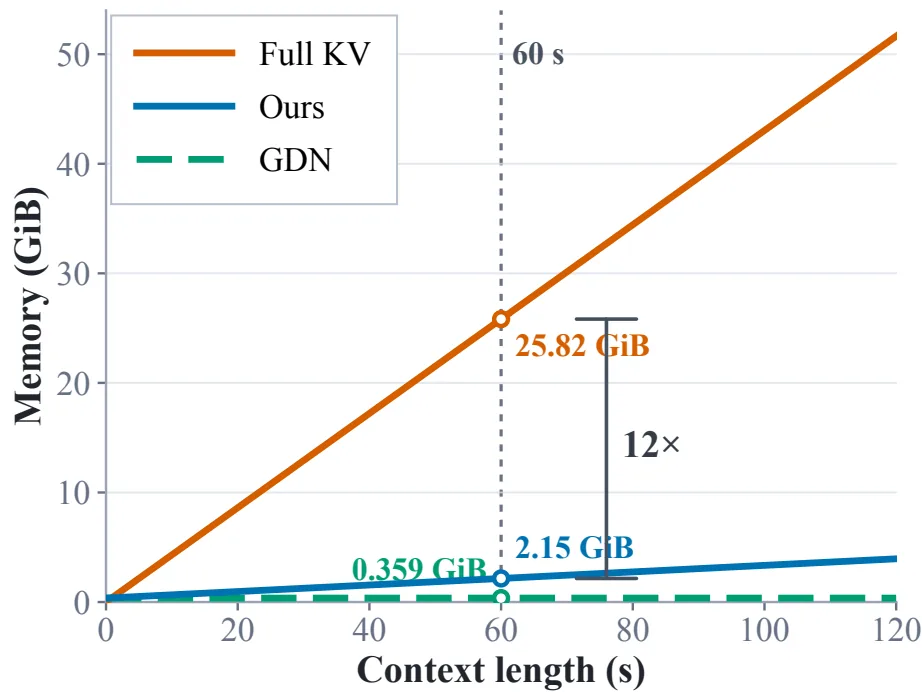
효율성. HLA-WM은 Full KV 어텐션과 순환 선형 어텐션 사이의 실용적 절충을 제공한다. 이력이 토큰이 아니라 청크 단위로 캐시되므로 메모리는 토큰 수가 아닌 청크 수에 비례한다. 60초 컨텍스트에서 2.15 GiB(Full KV 대비 12× 절감)만 쓰면서 처리량 손실은 최대 1.6%에 그친다 (근거: §5.2, Fig. 4).
핵심 소거 실험. 저자들은 두 가지 질문에 답한다 (근거: Appx. A.3–A.5).
- 어느 성분이 중요한가? 싱크 제거, 전이 선택 비활성화(“w/o Select A”), 쓰기 선택 비활성화(“w/o Select B”), 턴 인식 최근 컨텍스트 제거 모두가 재방문 일관성과 카메라 제어를 악화시킨다. 특히 무관한 중간 전이를 남기면 PSNR·SSIM이 크게 떨어져, “무관 전이가 망각의 원인"이라는 주장을 뒷받침한다 (근거: Appx. A.3, Tab. 3).
- GDN 재합성 vs KV 정렬 중 무엇이 더 중요한가? GDN-only가 KV-only보다 훨씬 큰 이득을 주며, 둘을 합쳐야 최고 성능이 나온다. 양방향 정제의 Hard 궤적에서 GDN-only는 SSIM을 올리지만 RotErr를 13.17°→33.04°로 악화시키는 “메모리 경로 불일치"를 보이는데, KV 캐시에도 동일 선택을 적용하면 다시 안정된다 (근거: Appx. A.4, Tab. 4).
검색 예산과 선택 전략. 놀랍게도 $K{=}1$(가장 관련 있는 이력 청크 1개)이 PSNR·SSIM·LPIPS에서 최고다. 더 많이 가져와도 일관된 개선이 없다 (근거: Appx. A.5, Tab. 6). 또 기하 기반 선택은 Random·Recent·Uniform 같은 휴리스틱보다 재방문 일관성이 좋아, “광범위한 시간 커버리지"를 넘어 뷰 관련 이력을 명시적으로 고르는 것이 추가 이득을 준다는 점을 보여준다 (근거: Appx. A.6, Tab. 7).
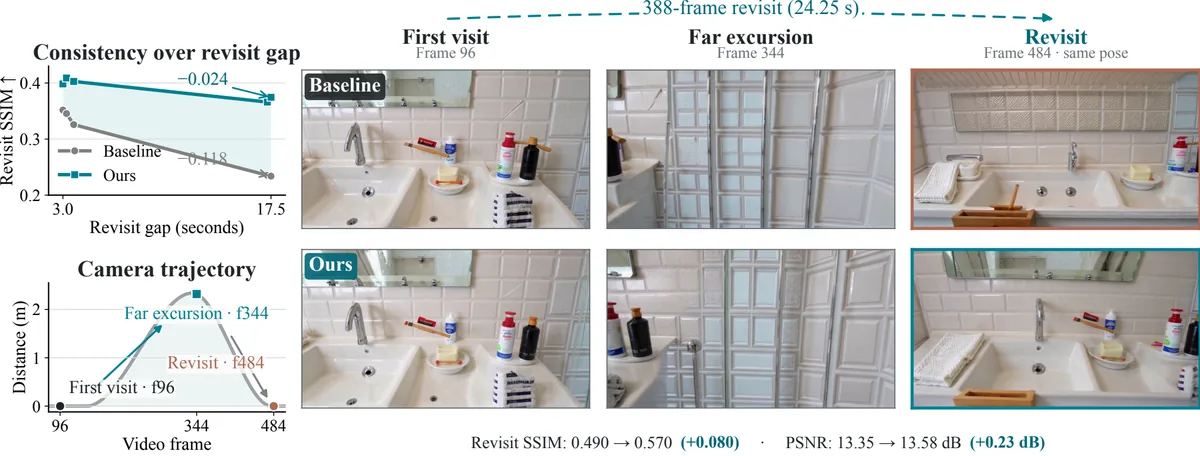
재방문 간격의 영향. 이득은 재방문 간격이 길수록 커진다(PSNR 개선이 단기 <10초에서 +0.375 dB → 장기 ≥40초에서 +0.992 dB로 증가). 선택적 장기 메모리의 이점이 “망각이 심한” 장거리 재방문일수록 두드러진다는, 방법의 취지와 정확히 일치하는 결과다 (근거: Appx. A.7, Fig. 6).
우리의 관점: 강점, 한계, 그리고 이 연구가 중요한 이유
강점. 가장 눈에 띄는 것은 훈련-무관(training-free) 이라는 실용성이다. 사전학습된 1.6B 모델을 그대로 두고, 추론 시 메모리 접근 방식만 바꿔 장거리 일관성을 끌어올린다. GDN의 아핀 구조를 분석적으로 활용해 $O(\text{토큰})$ 이 아니라 $O(\text{청크})$ 로 메모리를 스케일링하면서도 12× 절감과 1.6% 수준의 처리량 손실을 동시에 달성한 점은, “선택적으로 주소 지정 가능한 순환 메모리"라는 아이디어의 실현 가능성을 잘 증명한다 (근거: §4.4, Fig. 4). 또한 GDN-only vs KV-only 소거로 “순환 상태 재합성이 주 동력"임을 분리해낸 점도 분석적으로 깔끔하다 (근거: Appx. A.4).
한계. 저자가 명시적으로 인정하듯, 훈련-무관이라는 특성 자체가 상한을 제약한다. 검색은 카메라 기하와 FOV 겹침에만 의존해 가림(occlusion), 가시성, 의미적 관련성을 모델링하지 않는다 (근거: §6). 우리가 추가로 지적하고 싶은 한계는 세 가지다. 첫째, 검색은 처방된(prescribed) 카메라 궤적을 전제하는데, 실제 에이전트 개루프 생성에서는 포즈를 별도로 추정해야 하므로 그 오차가 검색 품질로 전파된다. 둘째, “24프레임 고정 청크"와 “싱크 1 + 최근 1 + Top-1"이라는 설계는 SANA-WM-Bench·MBench-A라는 특정 파이프라인에서 튜닝된 값이라, 다른 청킹·fps에 대한 강건성은 열려 있다. 셋째, $K{=}1$ 이 최적이라는 결과는 반대로 “더 풍부한 검색이 도움이 안 된다"는 뜻이기도 해서, 검색 신호 자체의 표현력 한계를 시사한다 (근거: Appx. A.5).
이 연구가 중요한 이유. 이 논문은 LLM의 KV 캐시 압축·long-context 문헌과 비디오 세계 모델 문헌을 잇는다. “완전 이력 캐시"와 “단일 압축 상태” 사이의 스펙트럼에서, 기하 정보를 주소 신호로 삼는 선택적 재합성이라는 제3의 지점을 제시하고, 그것이 학습 없이도 동작함을 보였다. 앞으로 비디오 세계 모델이 더 길어질수록 “기억을 어떻게 주소 지정할 것인가"가 병목이 될 텐데, 이 논문은 그 질문에 대한 구체적이고 측정 가능한 한 가지 답이다.
다음 단계는?: 앞으로의 길
저자들은 선택적 상태 검색을 학습에 통합하는 것과, 가림·가시성·의미적 관련성을 포함한 더 풍부하거나 학습된 검색 신호를 미래 방향으로 제시한다 (근거: §6). 이에 더해 우리가 기대하는 방향은 다음과 같다.
- 학습형 라우터와의 결합. 지금은 카메라 기하가 “무료” 주소 신호지만, 의미적 재방문(같은 장소가 아니라 같은 객체의 재등장)에는 한계가 있다. 기하 신호를 프라이어로 두고 경량 라우터가 보정하는 하이브리드가 자연스럽다.
- 가림 인지 검색. 프러스텀 겹침은 “벽 뒤"를 보지 못한다. 깊이 버퍼나 점유(occupancy) 신호를 얹으면 실내 장면의 가림 오류를 줄일 수 있다.
- 청킹과 검색 예산의 자동화. 고정 24프레임·Top-1 대신, 장면 변화율이나 이동량에 따라 청크 크기와 $K$ 를 동적으로 조절하면 효율-품질 절충을 더 잘 탈 수 있다.
- 재합성 커널의 최적화 심화. 저자들이 Triton 커널 위에 구현한 전향 스캔은 출발점이다. 배칭·메모리 레이아웃 최적화로 그 1.6%의 처리량 손실을 더 줄일 여지가 있다 (근거: §4.4, Appx. A.2).
요약하면 HLA-WM은 “순환 선형 어텐션의 망각"이라는 명확한 진단에서 출발해, 기하 기반의 선택적 재합성이라는 우아하고 실용적인 해법을 제시하고, 두 벤치마크에서 그 효과를 탄탄하게 검증했다. 학습 없이도 이만큼의 장거리 일관성 개선을 이끌어냈다는 점에서, 이 연구는 효율적 장기 세계 모델을 향한 중요한 발판이 될 것이다.
논문 원문의 표
arXiv e-print 의 LaTeX 원본에서 기계적으로 옮긴 표입니다. 숫자는 논문의 값이며 모델을 거치지 않았습니다.
논문 원문 표 전체 펼치기
표 1. Main results on SANA-WM-Bench under different generation stages and refinement modes. We report revisit consistency, camera controllability, and inference throughput. Best results within each setting are shown in bold.
| Pipeline | Method | Revisit Consistency PSNR $\uparrow$ | Revisit Consistency SSIM $\uparrow$ | Revisit Consistency LPIPS $\downarrow$ | Camera Control RotErr ($^\circ$) $\downarrow$ | Camera Control TransErr $\downarrow$ | Camera Control CamMC $\downarrow$ | Efficiency FPS $\uparrow$ |
|---|---|---|---|---|---|---|---|---|
| Simple-Trajectory Split | ||||||||
| Stage-1 | SANA-WM | 9.18 | 0.1729 | 0.6327 | 19.7040 | 2.2625 | 2.3974 | 22.403 |
| HLA-WM | 9.91 | 0.1999 | 0.6049 | 13.5864 | 2.0928 | 2.1798 | 22.053 | |
| Stage-1 + AR Refine | SANA-WM | 14.44 | 0.2770 | 0.5738 | 20.9315 | 2.1587 | 2.3121 | 8.280 |
| HLA-WM | 14.82 | 0.2872 | 0.5682 | 20.2933 | 2.1910 | 2.3240 | 8.211 | |
| Stage-1 + Bi. Refine | SANA-WM | 13.04 | 0.2945 | 0.5786 | 11.3848 | 1.9893 | 2.0545 | 7.701 |
| HLA-WM | 13.56 | 0.3148 | 0.5614 | 8.8823 | 1.8637 | 1.9127 | 7.700 | |
| Hard-Trajectory Split | ||||||||
| Stage-1 | SANA-WM | 9.37 | 0.1774 | 0.6044 | 20.3759 | 1.9952 | 2.1507 | 22.403 |
| HLA-WM | 10.11 | 0.1997 | 0.5848 | 15.0887 | 1.8388 | 1.9482 | 22.053 | |
| Stage-1 + AR Refine | SANA-WM | 14.12 | 0.2719 | 0.5621 | 25.6330 | 2.0099 | 2.2079 | 8.280 |
| HLA-WM | 14.47 | 0.2812 | 0.5557 | 22.0165 | 1.9351 | 2.1043 | 8.211 | |
| Stage-1 + Bi. Refine | SANA-WM | 13.05 | 0.2972 | 0.5468 | 13.1713 | 1.6649 | 1.7694 | 7.701 |
| HLA-WM | 13.51 | 0.3142 | 0.5384 | 10.5268 | 1.5449 | 1.6230 | 7.700 |
표 2. Component ablation on the Hard-Trajectory split using Stage 1 outputs. Best results are shown in bold.
| Variant | Revisit Consistency PSNR $\uparrow$ | Revisit Consistency SSIM $\uparrow$ | Revisit Consistency LPIPS $\downarrow$ | Camera Control RotErr ($^\circ$) $\downarrow$ | Camera Control TransErr $\downarrow$ | Camera Control CamMC $\downarrow$ |
|---|---|---|---|---|---|---|
| HLA-WM | 10.11 | 0.1997 | 0.5848 | 15.0887 | 1.8388 | 1.9482 |
| w/o Sink | 9.71 | 0.1867 | 0.6019 | 15.9351 | 1.9326 | 2.0531 |
| w/o Select $A$ | 9.61 | 0.1887 | 0.5901 | 15.2426 | 1.8552 | 2.0562 |
| w/o Select $B$ | 9.64 | 0.1892 | 0.5921 | 15.2326 | 1.9830 | 2.0564 |
| w/o Turn-aware | 9.96 | 0.1917 | 0.5876 | 15.1784 | 2.1096 | 1.9899 |
표 3. Ablation of GDN-state recomposition and KV-cache alignment on SANA-WM-Bench under Top-$1$ retrieval. Best results within each split and inference setting are shown in bold.
| Pipeline | Method | PSNR $\uparrow$ | SSIM $\uparrow$ | LPIPS $\downarrow$ | RotErr ($^\circ$) $\downarrow$ | TransErr $\downarrow$ | CamMC $\downarrow$ |
|---|---|---|---|---|---|---|---|
| Simple-Trajectory Split | |||||||
| Stage 1 | Baseline | 9.18 | 0.1729 | 0.6327 | 19.7040 | 2.2625 | 2.3974 |
| GDN-only | 9.45 | 0.1812 | 0.6219 | 17.9934 | 2.2832 | 2.4083 | |
| KV-only | 9.50 | 0.1866 | 0.6149 | 14.4283 | 1.9569 | 2.0556 | |
| HLA-WM | 9.91 | 0.1999 | 0.6049 | 13.5864 | 2.0928 | 2.1798 | |
| Stage 1 + AR Refine | Baseline | 14.44 | 0.2770 | 0.5738 | 20.9315 | 2.1587 | 2.3121 |
| GDN-only | 14.65 | 0.2784 | 0.5687 | 21.2344 | 2.3596 | 2.5147 | |
| KV-only | 13.88 | 0.2703 | 0.5812 | 20.9084 | 2.2087 | 2.3662 | |
| HLA-WM | 14.82 | 0.2872 | 0.5682 | 20.2933 | 2.1910 | 2.3240 | |
| Stage 1 + Bi. Refine | Baseline | 13.04 | 0.2945 | 0.5786 | 11.3848 | 1.9893 | 2.0545 |
| GDN-only | 13.26 | 0.2998 | 0.5746 | 10.7564 | 1.8627 | 1.9310 | |
| KV-only | 13.17 | 0.2999 | 0.5762 | 9.6939 | 1.8866 | 1.9417 | |
| HLA-WM | 13.56 | 0.3148 | 0.5614 | 8.8823 | 1.8637 | 1.9127 | |
| Hard-Trajectory Split | |||||||
| Stage 1 | Baseline | 9.37 | 0.1774 | 0.6044 | 20.3759 | 1.9952 | 2.1507 |
| GDN-only | 9.78 | 0.1890 | 0.5929 | 20.0838 | 1.9502 | 2.1075 | |
| KV-only | 9.52 | 0.1805 | 0.6000 | 13.3992 | 1.7635 | 1.8616 | |
| HLA-WM | 10.11 | 0.1997 | 0.5848 | 15.0887 | 1.8388 | 1.9482 | |
| Stage 1 + AR Refine | Baseline | 14.12 | 0.2719 | 0.5621 | 25.6330 | 2.0099 | 2.2079 |
| GDN-only | 14.35 | 0.2797 | 0.5576 | 23.1860 | 1.9519 | 2.1296 | |
| KV-only | 13.54 | 0.2599 | 0.5721 | 24.1145 | 2.0425 | 2.2302 | |
| HLA-WM | 14.47 | 0.2812 | 0.5557 | 22.0165 | 1.9351 | 2.1043 | |
| Stage 1 + Bi. Refine | Baseline | 13.05 | 0.2972 | 0.5468 | 13.1713 | 1.6649 | 1.7694 |
| GDN-only | 13.49 | 0.3304 | 0.5601 | 33.0406 | 2.1843 | 2.4584 | |
| KV-only | 13.26 | 0.3047 | 0.5469 | 11.4688 | 1.5860 | 1.6696 | |
| HLA-WM | 13.51 | 0.3142 | 0.5384 | 10.5268 | 1.5449 | 1.6230 |
표 4. Ablation of GDN-state recomposition and KV-cache alignment on MBench-A under Top-$1$ retrieval. Best results within each inference setting are shown in bold.
| Pipeline | Method | PSNR $\uparrow$ | SSIM $\uparrow$ | LPIPS $\downarrow$ |
|---|---|---|---|---|
| Stage 1 | Baseline | 10.17 | 0.2545 | 0.6251 |
| GDN-only | 10.61 | 0.2626 | 0.6052 | |
| KV-only | 10.43 | 0.2606 | 0.6091 | |
| HLA-WM | 11.01 | 0.2848 | 0.5823 | |
| Causal AR Refine | Baseline | 12.36 | 0.2996 | 0.6554 |
| GDN-only | 12.57 | 0.3064 | 0.6492 | |
| KV-only | 12.35 | 0.3016 | 0.6547 | |
| HLA-WM | 12.73 | 0.3122 | 0.6447 | |
| Bidirectional Refine | Baseline | 12.94 | 0.3310 | 0.5597 |
| GDN-only | 13.28 | 0.3389 | 0.5477 | |
| KV-only | 13.04 | 0.3325 | 0.5563 | |
| HLA-WM | 13.52 | 0.3431 | 0.5470 |
표 5. Ablation on the retrieval budget $K$ on the Hard-Trajectory split using Stage 1 outputs. Best results are shown in bold.
| $K$ | Revisit Consistency PSNR $\uparrow$ | Revisit Consistency SSIM $\uparrow$ | Revisit Consistency LPIPS $\downarrow$ | Camera Control RotErr ($^\circ$) $\downarrow$ | Camera Control TransErr $\downarrow$ | Camera Control CamMC $\downarrow$ |
|---|---|---|---|---|---|---|
| $1$ | 10.11 | 0.1997 | 0.5848 | 15.0887 | 1.8388 | 1.9482 |
| $3$ | 10.06 | 0.1973 | 0.5865 | 14.1537 | 1.7658 | 1.8661 |
| $4$ | 10.00 | 0.1936 | 0.5885 | 12.2795 | 1.6985 | 1.7832 |
| $5$ | 9.89 | 0.1886 | 0.5915 | 11.5435 | 1.7200 | 1.7970 |
표 6. Comparison of historical state selection strategies on Hard80 under Stage 1 inference with $K=4$. Higher PSNR and SSIM are better, while lower LPIPS and camera errors are better.
| Selection Policy | PSNR $\uparrow$ | SSIM $\uparrow$ | LPIPS $\downarrow$ | RotErr ($^\circ$) $\downarrow$ | TransErr $\downarrow$ | CamMC $\downarrow$ |
|---|---|---|---|---|---|---|
| Random | 9.70 | 0.1864 | 0.6049 | 14.1883 | 1.7822 | 1.8924 |
| Recent | 9.29 | 0.1696 | 0.6179 | 27.6876 | 2.0142 | 2.2408 |
| Uniform | 9.91 | 0.1910 | 0.5957 | 12.3324 | 1.6881 | 1.7838 |
| HLA-WM | 10.00 | 0.1936 | 0.5885 | 12.2795 | 1.6985 | 1.7832 |
표 7. Category-level results on SANA-WM-Bench using Stage 1 outputs. Best results within each category are shown in bold.
| Category | Method | PSNR $\uparrow$ | SSIM $\uparrow$ | LPIPS $\downarrow$ | RotErr ($^\circ$) $\downarrow$ | TransErr $\downarrow$ | CamMC $\downarrow$ |
|---|---|---|---|---|---|---|---|
| Simple-Trajectory Split | |||||||
| Game Style | SANA-WM | 9.85 | 0.2070 | 0.6197 | 16.5064 | 1.9242 | 2.0482 |
| HLA-WM | 11.06 | 0.2639 | 0.5866 | 12.8640 | 2.0047 | 2.0939 | |
| Indoor | SANA-WM | 9.38 | 0.2105 | 0.6576 | 38.6940 | 1.6993 | 2.0227 |
| HLA-WM | 10.05 | 0.2338 | 0.6306 | 29.0323 | 1.6196 | 1.8481 | |
| Outdoor City | SANA-WM | 8.96 | 0.1323 | 0.6390 | 12.2424 | 2.0782 | 2.1372 |
| HLA-WM | 9.25 | 0.1561 | 0.6240 | 5.9851 | 1.5976 | 1.6170 | |
| Outdoor Nature | SANA-WM | 8.52 | 0.1419 | 0.6145 | 11.3733 | 3.3483 | 3.3814 |
| HLA-WM | 9.29 | 0.1459 | 0.5785 | 6.4643 | 3.1493 | 3.1603 | |
| Hard-Trajectory Split | |||||||
| Game Style | SANA-WM | 9.84 | 0.2023 | 0.5823 | 14.2161 | 1.8745 | 1.9719 |
| HLA-WM | 11.41 | 0.2550 | 0.5505 | 14.3713 | 1.8250 | 1.9349 | |
| Indoor | SANA-WM | 9.22 | 0.2085 | 0.6390 | 36.5361 | 1.2446 | 1.6297 |
| HLA-WM | 9.63 | 0.2305 | 0.6330 | 26.6061 | 1.0675 | 1.3277 | |
| Outdoor City | SANA-WM | 9.17 | 0.1463 | 0.6206 | 16.0176 | 1.8409 | 1.9254 |
| HLA-WM | 9.56 | 0.1611 | 0.6122 | 9.9119 | 1.6669 | 1.7070 | |
| Outdoor Nature | SANA-WM | 9.23 | 0.1526 | 0.5756 | 14.7337 | 3.0208 | 3.0760 |
| HLA-WM | 9.84 | 0.1521 | 0.5437 | 9.4654 | 2.7958 | 2.8233 |
표 8. Category-level results on SANA-WM-Bench after causal AR refinement. Best results within each category are shown in bold.
| Category | Method | PSNR $\uparrow$ | SSIM $\uparrow$ | LPIPS $\downarrow$ | RotErr ($^\circ$) $\downarrow$ | TransErr $\downarrow$ | CamMC $\downarrow$ |
|---|---|---|---|---|---|---|---|
| Simple-Trajectory Split | |||||||
| Game Style | SANA-WM | 15.19 | 0.3225 | 0.5582 | 19.8894 | 2.1729 | 2.3106 |
| HLA-WM | 15.79 | 0.3505 | 0.5492 | 16.5280 | 2.0506 | 2.1496 | |
| Indoor | SANA-WM | 13.64 | 0.3127 | 0.6013 | 35.3855 | 1.5308 | 1.8652 |
| HLA-WM | 14.08 | 0.3172 | 0.5956 | 34.3931 | 1.6263 | 1.9040 | |
| Outdoor City | SANA-WM | 14.21 | 0.2353 | 0.5803 | 15.1111 | 1.9558 | 2.0376 |
| HLA-WM | 14.26 | 0.2510 | 0.5777 | 14.4444 | 1.9104 | 1.9801 | |
| Outdoor Nature | SANA-WM | 14.70 | 0.2375 | 0.5555 | 13.3400 | 2.9753 | 3.0350 |
| HLA-WM | 15.13 | 0.2302 | 0.5503 | 15.8077 | 3.1768 | 3.2625 | |
| Hard-Trajectory Split | |||||||
| Game Style | SANA-WM | 14.95 | 0.3220 | 0.5269 | 23.5136 | 1.8901 | 2.0707 |
| HLA-WM | 15.73 | 0.3398 | 0.5140 | 18.0932 | 1.8923 | 2.0223 | |
| Indoor | SANA-WM | 13.81 | 0.3003 | 0.5923 | 35.8487 | 1.2361 | 1.6201 |
| HLA-WM | 13.71 | 0.3139 | 0.5920 | 30.6444 | 1.1457 | 1.4865 | |
| Outdoor City | SANA-WM | 13.56 | 0.2507 | 0.5812 | 20.0231 | 1.8331 | 1.9407 |
| HLA-WM | 13.74 | 0.2570 | 0.5877 | 19.7262 | 1.8103 | 1.9228 | |
| Outdoor Nature | SANA-WM | 14.18 | 0.2147 | 0.5478 | 23.1465 | 3.0804 | 3.2001 |
| HLA-WM | 14.71 | 0.2143 | 0.5290 | 19.6023 | 2.8921 | 2.9858 |
이 글의 그림은 arXiv:2610.05739 원본에서 가져왔습니다 (CC BY 4.0). 크기와 형식만 바꿨습니다.
댓글