위상 감수성(Phase Sensitivity): 청크 단위 KV 캐시 압축이 만드는 ‘주기적 약점’
TL;DR — 청크 단위 KV 캐시 압축을 쓰는 모델(DeepSeek-V4 계열 등)에서, 같은 정보라도 압축 창 경계를 기준으로 한 ‘위상(phase)‘에 따라 검색 성능이 최대 40pp까지 주기적으로 달라진다. 평균 벤치마크 점수는 이 약점을 완전히 숨긴다.
핵심 아이디어
긴 문맥 추론의 병목은 KV 캐시다. 메모리와 어텐션 비용이 문맥 길이에 비례해 커지기 때문이다(근거: §1). 이를 해결하기 위해 DeepSeek-V4 같은 모델은 **청크 단위 KV 캐시 압축(chunked KV-cache compression)**을 쓴다. 연속된 토큰을 고정 크기 창(window)으로 묶고, 각 창을 더 적은 수의 캐시 엔트리로 요약한 뒤 그 요약으로 장거리 검색을 수행한다(근거: §1).
이 논문의 통찰은 여기서 시작한다. 압축이 매 $S$ 토큰마다 새 창이 시작되는 주기 구조를 문맥에 강제한다는 점이다. $S$는 압축 스트라이드(stride)다. 그러면 각 토큰은 절대 위치 말고 위상(phase) 이라는 새 좌표를 갖게 된다(근거: §1):
$$\text{phase} = t \bmod S$$입력을 몇 토큰 밀기만 해도, 내용과 상대 위치는 그대로인데 어떤 토큰끼리 같은 창에 묶이는지가 바뀐다. 즉 같은 정보가 위상에 따라 다르게 압축되고, 따라서 다른 충실도로 보존될 수 있다.
저자들은 이렇게 정의한다. 스트라이드 $S$에 대해, 위치 $t$에서 시작하는 키-값 쌍의 위상은 $t \bmod S$다. 어떤 검색 지표(정확도, 정답 확률 등)가 정보의 위상에 따라 체계적으로 달라질 때, 검색이 **위상 감수성(phase sensitivity)**을 가진다고 말한다(근거: §2).
핵심 주장은 이 한 문장으로 요약된다. “청크 단위 KV 캐시 압축을 쓴 모델에서는, 평균 점수로는 보이지 않는 주기적인 검색 실패(주기적 약점)가 존재하며, 그 주기는 압축 스트라이드와 일치한다.”
배경: 그들이 해결한 문제
KV 캐시의 비용은 문맥 길이에 비례해 자란다. 대략적으로, $L$개 레이어, $H$개 헤드, 헤드 차원 $d_\text{head}$인 모델에서 시퀀스 길이 $\text{seq}$·배치 $\text{batch}$일 때 캐시 용량은 다음과 같이 커진다:
$$ \text{KV-Cache(GB)} \approx \frac{2 \cdot L \cdot H \cdot d_\text{head} \cdot \text{seq} \cdot \text{batch} \cdot \text{bytes/elt}}{10^9} $$이 비용을 줄이기 위해 등장한 것이 학습형 압축 메모리 계열이다. Compressive Transformer, LoMA, Activation Beacon, CAT, 그리고 스파스 어텐션(NSA, MOBA, DeepSeek-V4의 CSA)과 캐시 축출(H2O, SnapKV)까지 모두 같은 목표를 공유한다(근거: §6).
그런데 기존 평가 방식에는 맹점이 있다. “Lost in the Middle"은 정보가 문맥의 어느 깊이에 있는지가 검색 품질을 좌우한다는 것을, RULER는 쉬운 needle 테스트가 실제 사용 가능한 문맥 길이를 과대평가한다는 것을 보였다(근거: §6). 이 논문이 주목한 것은 전혀 다른 차원이다. 정보의 문맥 깊이나 쿼리 위치가 아니라, 정보가 압축 창 경계에 대해 놓인 위상이라는, 매 스트라이드마다 되풀이되는 미시적 좌표다.
저자들이 발견한 것은 놀랍다. 이 위상에 따라 같은 정보의 검색 성능이 주기적으로 요동친다는 것이다. 그리고 이는 평균 지표로는 완전히 가려진다.
새로운 접근법: Phase Sensitivity + Phase Specialization
이 논문은 새 모델이나 새 아키텍처를 제안하지 않는다. 대신 새로운 실패 모드를 정의하고, 그 기원을 메커니즘·이론적으로 규명한 분석 논문이다. 기여는 크게 세 갈래다(근거: §1, §3, §4, §5).
새 실패 모드의 식별 (경험적 발견). 청크 단위 KV 압축 모델에서 검색 정확도가 위상에 따라 주기적으로 변하는 ‘위상 감수성’을 최초로 보고했다. DeepSeek-V4, V4.1, 그리고 저자들이 직접 사전학습한 모든 압축 모델에서 재현된다.
메커니즘 규명 (인과 개입). KV 헤드 녹아웃(knockout)과 게이트 순환(gate cycling) 같은 인과 개입으로, 서로 다른 헤드가 서로 다른 위상의 검색에 비대칭적으로 기여한다는 **위상 전문화(phase specialization)**를 입증했다.
이론적 설명 (최적화 동역학). 이상화된 바이그램 검색 과제에서, 압축 게이트의 농축(concentration)이 최적해임을 보이고, 경사 흐름(gradient flow)이 그 농축을 **정적(static)**으로 굳히는 것을 정리로 증명했다.
이들이 기존 연구와 다른 점은 ‘평균 정확도’라는 렌즈를 버렸다는 것이다. 벤치마크 점수는 같은데도, 내부에는 주기적으로 반복되는 위치적 실패가 숨어 있다는 사실을 파고든다.
작동 원리: 구체적인 예시로 살펴보기
청크 압축은 어떻게 이뤄지는가
제어된 실험에서 쓰는 압축 커널을 보면 동작이 명확하다(근거: §3). 창 크기 $W$의 창 $j$에서 오프셋 $i$ ($0 \le i < W$)의 히든 상태를 $h_{j,i} \in \mathbb{R}^d$라 하자. 각 오프셋은 페이로드 맵(payload map) $C_i$로 “무엇을 기여할지"를, 압축 게이트(compression gate) $Z_i$, $b_i$로 “얼마나 강하게 들어갈지"를 정한다. 키 브랜치에서 게이트 로짓은:
$$ s_{j,i}^{K} = Z_{i}^{K} h_{j,i} + b_{i}^{K} $$창 전체에 소프트맥스를 취해 게이트 점수를 만들고, 이를 페이로드에 곱해 합산한다:
$$ \alpha_{j,i}^{K} = \frac{\exp(s_{j,i}^{K})}{\sum_{u=0}^{W-1} \exp(s_{j,u}^{K})}, \qquad \widehat{K}_j = \sum_{i=0}^{W-1} \alpha_{j,i}^{K} \odot \left( C_i^K h_{j,i} \right) $$핵심은 이 압축이 쿼리를 알기 전에 일어난다는 점이다. 나중에 어떤 정보를 회상해야 할지 모른 채, 모든 창을 ‘쿼리-무관(query-agnostic)‘하게 요약해야 한다. 이 구조가 주기성을 낳는다.
토이 예시: 8토큰 창, 스트라이드 8
$S=8$인 모델을 상상해 보자. 위치 $0,8,16,\dots$에서 새 창이 시작된다. 위치 $t$의 토큰은 위상 $t \bmod 8$을 갖는다. 즉 $t=0$과 $t=8$은 모두 위상 $0$, $t=1$과 $t=9$는 모두 위상 $1$이다.
이제 키-값 쌍 “키: banana, 값: yellow“가 위치 $t$에 있다고 하자. 검색할 때는 쿼리 banana를 던지고 yellow를 회수해야 한다.
- $t=7$이라면 키는 창 $j$의 마지막 오프셋에, 값
yellow는 다음 창 $j{+}1$의 첫 오프셋에 떨어진다. 키와 값이 창 경계를 가로질러 분리되므로, 하나의 압축 엔트리 안에 둘 다 들어가지 못한다. 직관적으로 회수가 어렵다(근거: §3). - $t=0$부터 $t=6$까지는 키와 값이 같은 창 안에 있다. 그런데도 실험에서는 이 위상들 사이에서 정확도가 50pp 이상 벌어진다(근거: §3). 즉 경계만으로는 전체 주기를 설명할 수 없다.
이 “경계를 가로지른 경우 vs. 창 내부에서도 계속 벌어지는 차이"라는 두 겹의 비대칭이 이 논문의 분석 축이다.
게이트는 위상을 배운다
위상 전문화의 실마리는 게이트에 있다. 게이트 점수는 입력에 의존하므로, 두 가지 방식으로 농축될 수 있다(근거: §4).
- 정적 농축(static concentration): 어떤 입력이 와도 항상 같은 오프셋을 선호. → 특정 위상에 고정됨.
- 입력 의존 농축(input-dependent concentration): 내용에 따라 선호 오프셋이 달라짐. → 위상과 무관.
이 둘은 유효 오프셋 수(effective number of offsets) 로 구분한다. 엔트로피 $H$에 대해 $\exp(H(\alpha))$로 정의되는 값으로, 원-핫이면 $1$, 균등이면 $W$가 된다. 초기화 직후에는 모든 게이트가 균등($\exp(H(\mathbb{E}[\alpha])) \approx 8$)에 가깝지만, 사전학습이 진행되면서 일부 헤드가 대각선을 타고 내려와 정적 농축을 형성한다(근거: §4).
구체적으로 기준 모델(W8/S8)에서 레이어 9, 10, 14의 게이트가 각각 창의 후반부, 중간, 초반부 오프셋에 피크를 만들고, 값 게이트는 그보다 한 오프셋 뒤에 피크를 만든다. 마치 키-값 쌍(바이그램)을 한 헤드가 전담하는 모양새다(근거: §4). 이 피크 위상은 정확히 그 헤드의 녹아웃 손실이 집중되는 위상과 일치한다.
성능 검증: 주요 결과
DeepSeek-V4 계열의 주기적 약점
가장 눈에 띄는 증거는 코드 완성이다. DeepSeek-V4-Flash-Base에게 자신의 추론 코드(FP8 양자화 함수)의 타입 캐스트를 완성시키는데, 앞에 장식용 독스트링을 붙이고 그 길이 $L$만 24~39토큰으로 바꿔 봤다. 코드는 그대로인데 top-1 예측이 주기적으로 뒤집힌다. 정답 8과 오답 32 사이의 확률 차이 $P(8) - P(32)$는 $-0.79$에서 $+0.95$까지 요동치고, 뒤집힘은 매 4토큰마다 반복된다(근거: §2, Fig. headline). 이 4라는 주기가 바로 DeepSeek-V4 CSA의 스트라이드 $S=4$다. 같은 현상은 스트라이드 $S=2$인 DeepSeek-V4.1-Flash에서 주기 2로 나타나고, 청크 압축이 없는 DeepSeek-V3.1-Base에서는 64개 입력 중 단 4개에서만 32가 위로 오는 등 사실상 사라진다(근거: §2).
이를 체계화한 것이 128K 문맥에서의 NIAH(needle-in-a-haystack) 검색 실험이다. 128K 토큰 프롬프트에 16k개의 키-값 쌍을 넣고, 중간쯤의 원본 키 값을 회수하게 한다(근거: §2). 원본 키의 위치를 8로 나눈 나머지(위상 그룹)별로 정확도를 보면, 기준(base) 체크포인트에서 최대 40.2pp까지 벌어진다(근거: §2, Fig. v4_niah). 사후학습(post-training)이 정확도를 올리고 격차를 좁히긴 하지만, DeepSeek-V4-Flash-0731의 격차는 여전히 19.14pp, DeepSeek-V4-Pro-0813은 14.84pp에 달한다(근거: Tab. v4-niah-residue-accuracy). 가장 격차가 작은 V4.1-Flash조차 6.09pp이며, 네 개의 짝수 위상 그룹이 모두 네 개의 홀수 그룹보다 위에 놓인다(근거: §2).
제어된 사전학습: 압축이 원인임을 확인
DeepSeek-V4는 청크 압축 외에도 표준 트랜스포머와 다른 점이 많아, 압축을 빼고 다시 학습시켜 주기성이 사라지는지 확인할 수 없다. 그래서 저자들은 Qwen3-0.6B를 백본으로, KV 압축을 유일한 아키텍처 변경으로 삼은 모델 가족을 처음부터 사전학습했다. 총 26개 실행(압축 23개 + 전체 어텐션 기준선 3개)을 스텝 47,518까지 학습했다(근거: §3, Tab. controlled-sweep-results).
결과는 명확하다. 모든 압축 모델은 스트라이드에 맞춰 주기적으로 변동하고, 전체 어텐션 기준선은 평평하다(근거: §3).
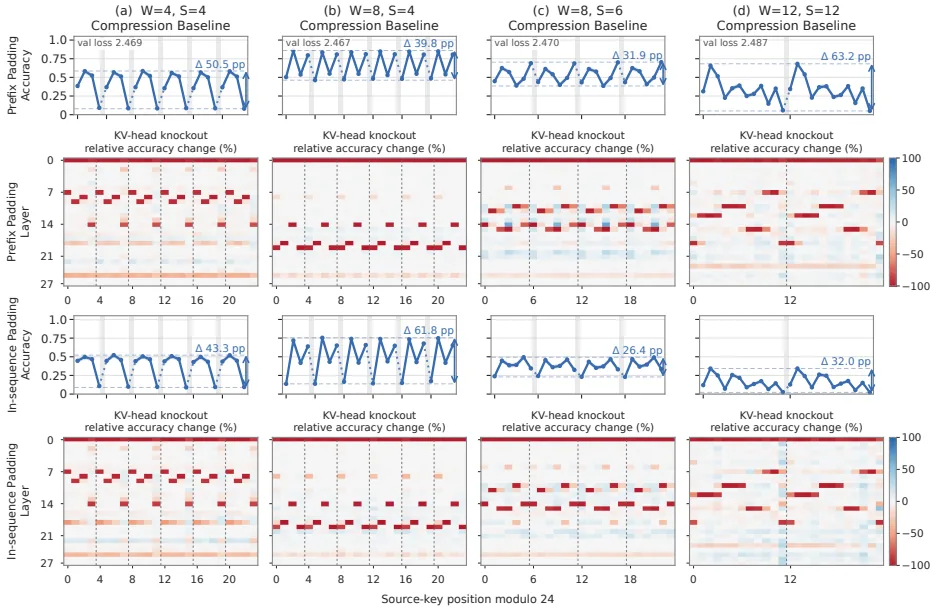
특히 주기 자체가 스트라이드를 따른다. 창 $W=8$에서 스트라이드 $S\in\{4,6,8\}$일 때 주기는 각각 약 4, 6, 8토큰, $W{=}12/S{=}12$면 약 12토큰이다(근거: §3). 그리고 이 현상은 RoPE나 학습된 게이트 없이도 남는다. 균일 평균 풀링으로 게이트를 대체해도, 위치 인코딩을 빼도 위상 감수성은 지속된다(근거: §3).
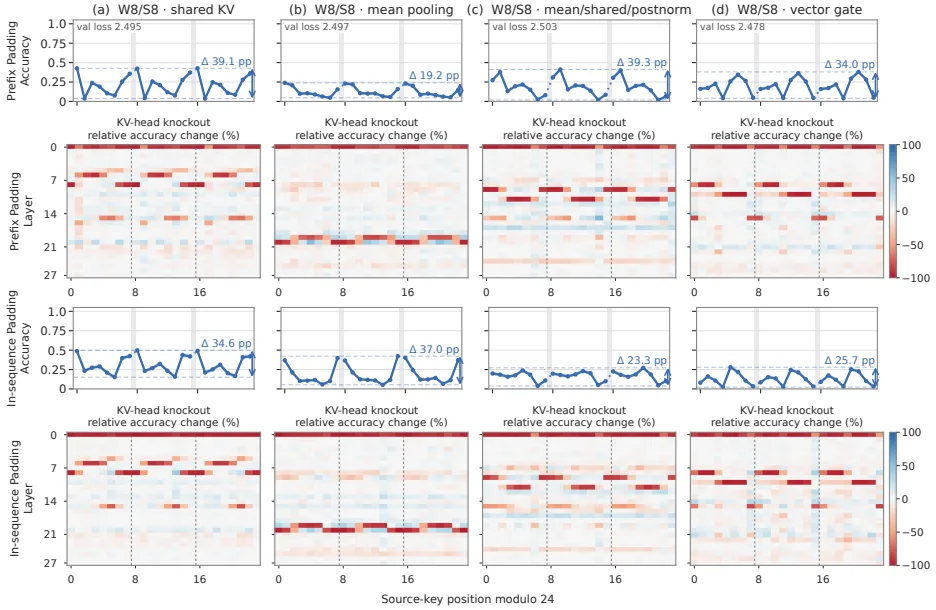
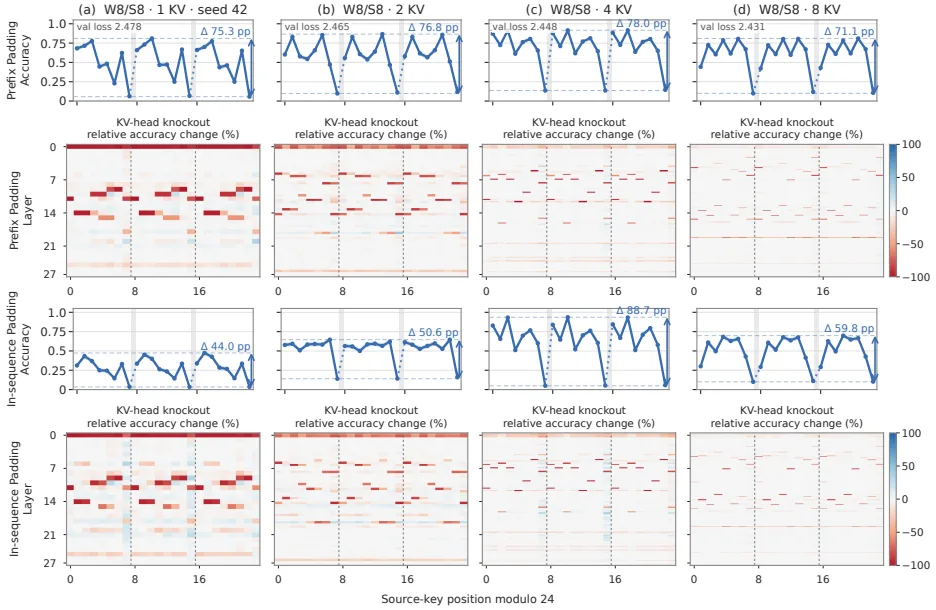
가장 섬뜩한 숫자는 ‘평균 지표가 얼마나 이 차이를 숨기는가’다. KV 헤드 8개짜리 W8/S8 압축 모델은 평균 정확도(59.4%)와 검증 손실에서 전체 어텐션 기준선(61.1%)에 거의 근접하지만, 최악의 위상 그룹 정확도는 **9.9%**에 불과하다. 기준선의 최저는 58.4%다(근거: §3, Tab. controlled-sweep-results). Prefix Padding 기준 격차(gap)는 압축 모델에서 최대 78pp에 달하는 반면, 기준선은 기껏해야 6.1pp다(근거: §3).
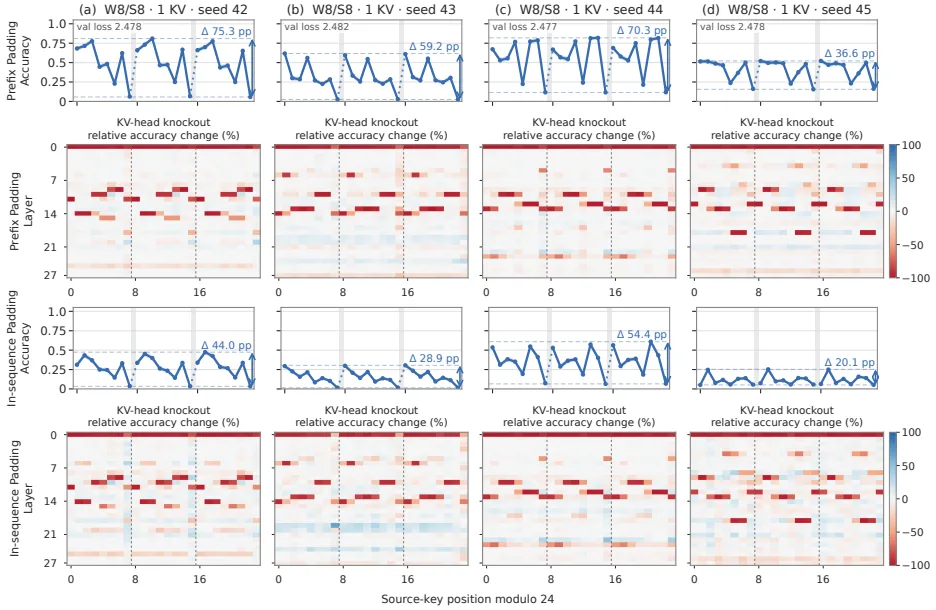
이 현상은 시드에 강건하다. 시드를 바꾸면 위상별 정확도 패턴은 달라지지만, 주기적 약점 자체는 모든 시드에서 재현된다(근거: Appx).
메커니즘: 위상 전문화
원인을 찾기 위해 KV 헤드 녹아웃을 수행했다. 한 번에 한 헤드의 출력을, 여러 프롬프트에 걸친 평균값으로 치환(mean replacement)해 “이 프롬프트 특유의 정보"를 지운다(근거: §4). 전체 어텐션 기준선에서는 각 레이어의 손실이 모든 위상에 고르게 퍼진 가로 줄무늬로 나타난다. 반면 압축 모델에서는 손실이 특정 위상에 집중되고, 헤드마다 다른 위상 의존 패턴을 보인다(근거: §4, Fig. phase-knockouts). DeepSeek-V4-Flash-Base에서도 같은 패턴이 4토큰 주기로 반복된다.
이어서 게이트 순환(cycling) 개입으로 인과성을 확인한다. 정적으로 농축된 게이트의 오프셋별 파라미터를 $k$ 오프셋만큼 순환시키면, 정확도 패턴도 대략 $k$ 위상만큼 이동한다(근거: §4). 이는 학습된 게이트 선호가 위상별 검색 비대칭의 원인임을 보여준다.
이론: 왜 게이트는 위상에 농축되는가
마지막으로 저자들은 이상화된 유도 과제(induction task)로 “왜"를 묻는다. $LS$개의 토큰을 스트라이드 $S$의 청크로 나눈 문맥에서, 쿼리가 한 토큰을 반복하면 그 후속 토큰을 예측하게 한다(근거: §5). 각 헤드는 청크를 하나의 압축 키/값으로 요약한다. 두 개의 정리가 나온다(근거: §5).
정리 1 (최적 압축은 농축된다). 충분히 큰 어휘 $N$과 작은 오차 $\varepsilon$에서, 전역 최소해는 모든 문맥·청크·헤드에서 키 가중치를 단일 위치 $r$에, 값 가중치를 $r{+}1$에 원-핫으로 집중한다. 즉 쿼리를 미리 모르더라도, 손실은 가장 농축된 압축을 선호한다.
정리 2 (경사 흐름은 정적 농축을 만든다). 작은 랜덤 초기화에서 시작한 경사 흐름은 각 헤드 $h$를 고정 위치 $r_h$로 수렴시켜, 키 게이트는 $r_h$의 원-핫, 값 게이트는 $r_h{+}1$의 원-핫이 된다. 정리 1에서는 선택 위치가 입력마다 달라질 수 있지만, 정리 2에서는 학습이 이를 헤드별로 고정시킨다.
이는 앞서 관찰한 레이어 9, 10, 14의 “키는 특정 오프셋, 값은 그 다음 오프셋"이라는 인접 선호와 정확히 맞아떨어진다(근거: §5).
우리의 관점: 강점, 한계, 그리고 이 연구가 중요한 이유
강점. 이 논문의 가장 큰 가치는 ‘평균 정확도’라는 관성에 균열을 냈다는 점이다. 벤치마크 점수는 같으면서도 내부에는 최대 40pp의 주기적 실패가 숨을 수 있다는 사실은, 청크 압축을 쓰는 모든 장문맥 모델의 평가 프로토콜에 직접적 함의를 준다. 방법론적으로도 깔끔하다. 단일 모델의 수동 관찰에 그치지 않고, (1) 대규모 상용 모델군, (2) 유일 변수 통제 사전학습, (3) 인과 개입, (4) 이론 정리까지 네 겹으로 쌓아올렸다. 특히 “입력을 몇 토큰 밀어 같은 정보의 위상을 바꾸는” 실험 설계는 재현이 쉽고, 이 분야의 표준 도구가 될 만하다.
한계. 저자들도 명시하듯, 메커니즘 결론은 제어된 소규모 설정에서 가장 강하다. 대형 이종 모델에서의 보편적 원인을 확립한 것은 아니다(근거: §7). 더 중요한 미해결 지점은 이중성이다. 게이트 순환이 경계 위상(키와 값이 창을 가로지른 경우)을 복원하지 못하므로, 경계 비대칭과 창 내부 비대칭을 하나의 설명으로 통합하지 못했다(근거: §7). 이론 역시 바이그램 유도 과제라는 이상화에 국한되어, 실제 사전학습의 복잡한 손실 풍경까지 이어지지는 않는다. 정량 지표도 상당수가 NIAH와 코드 완성 같은 통제 과제에 집중되어, 실제 하류 응용에서의 체감 영향은 아직 열려 있다.
이 연구가 중요한 이유. 성능 최적화가 급격히 진행되는 장문맥 추론에서, 이 논문은 “비용을 줄인 만큼 어딘가에 대가가 숨어 있다"는 것을 구체적인 좌표로 짚어냈다. 평균을 높이는 데 성공한 압축 설계도, 정보가 어느 위상에 놓이느냐에 따라 신뢰성을 잃을 수 있다. 이는 평가 방법론(평균이 아닌 위상 분해 측정)과 아키텍처 설계(위상 균일화) 양쪽 모두에 새로운 질문을 던진다.
다음 단계는?: 앞으로의 길
저자들이 남긴 가장 실질적인 과제는 위상 균일화다. 헤드와 레이어 간 명시적 조정을 통해 위상별 검색 품질을 고르게 만들 수 있는지, 평균 성능이나 압축 효율을 희생하지 않으면서 가능한지는 아직 열려 있다(근거: §7).
우리가 보기에 자연스러운 후속 단계는 세 가지다.
평가 프로토콜의 표준화. 기존 장문맥 벤치마크(Lost in the Middle, RULER 등)에 ‘입력을 $k$ 토큰 밀어가며 위상별로 측정’하는 절차를 추가하고, 평균 대신 최솟값·격차를 함께 보고하는 관행을 만든다.
견고성 함의 탐구. 저자들이 명시한 대로, 의미를 보존하는 입력 이동이 응답 거부(refusal)나 준수(compliance)를 바꾸는지, 그 변화가 압축 위상을 추적하는지는 아직 미검증이다(근거: §7). 프롬프트 인젝션, 탈옥, 일관성 등 안전 관련 거동과의 연결은 시급한 질문이다.
설계 수준의 대응. 게이트의 정적 농축이 원인의 하나라면, 이를 정규화하거나 위상-무관한 압축 연산자를 유도하는 손실 항, 혹은 위상을 섞는 입력 전처리를 통해 약점을 펼치는(pipeline) 방향도 실험해 볼 만하다. 이론 정리는 “학습이 자연스럽게 농축을 선호한다"고 말하므로, 단순히 학습을 더 오래 시키는 것으로는 해결되지 않을 것이다.
궁극적으로 이 논문이 남기는 교훈은 단순하다. 평균은 안심의 지표가 아니다. 청크 단위 압축을 쓰는 모델을 평가할 때는, 점수의 평균뿐 아니라 그것이 위상에 따라 어떻게 요동치는지까지 물어야 한다.
논문 원문의 표
arXiv e-print 의 LaTeX 원본에서 기계적으로 옮긴 표입니다. 숫자는 논문의 값이며 모델을 거치지 않았습니다.
표 1. Summary of the plotted pretrained models. Prefix Padding results for the 26 runs shown in the cited main-text and appendix figures: 23 compressed runs and three full-attention baselines, evaluated at the end of training (step 47,518). For full-vocabulary retrieval accuracy $A_\rho$ at source-key residue $\rho=t_K\bmod24$, we report the mean over all 24 residues, the minimum, and the gap $\max_\rho A_\rho-\min_\rho A_\rho$ in percentage points. The same coordinate is used for full-attention baselines, which have no compression phase. Validation loss is reported separately from retrieval.
| Configuration / change | $W/S$ | KV | Val. loss | Retrieval accuracy Mean (%) | Retrieval accuracy Min. (%) | Retrieval accuracy Gap (pp) |
|---|---|---|---|---|---|---|
| Full-attention baselines (fig:phase-accuracy) | ||||||
| Full attention | – | 1 | 2.466 | 18.8 | 17.2 | 3.1 |
| Full attention | – | 4 | 2.448 | 47.1 | 44.8 | 6.1 |
| Full attention | – | 8 | 2.437 | 61.1 | 58.4 | 4.3 |
| Reference and random-seed replication (fig:controlled-group-random-seed-replication) | ||||||
| Reference, seed 42 | 8/8 | 1 | 2.478 | 50.6 | 5.7 | 75.3 |
| Reference, seed 43 | 8/8 | 1 | 2.482 | 32.1 | 2.5 | 59.2 |
| Reference, seed 44 | 8/8 | 1 | 2.477 | 56.1 | 11.6 | 70.3 |
| Reference, seed 45 | 8/8 | 1 | 2.478 | 40.5 | 15.6 | 36.6 |
| Native KV-head count (fig:controlled-group-native-kv-head-count) | ||||||
| Two KV heads | 8/8 | 2 | 2.465 | 58.3 | 9.8 | 76.8 |
| Four KV heads | 8/8 | 4 | 2.448 | 68.7 | 13.6 | 78.0 |
| Eight KV heads | 8/8 | 8 | 2.431 | 59.4 | 9.9 | 71.1 |
| Compression-window size and stride (fig:controlled-group-compression-geometry) | ||||||
| Non-overlapping windows | 4/4 | 1 | 2.469 | 38.5 | 8.0 | 50.5 |
| Overlapping windows | 8/4 | 1 | 2.467 | 66.9 | 46.2 | 39.8 |
| Overlapping windows | 8/6 | 1 | 2.470 | 53.4 | 38.5 | 31.9 |
| Larger windows, one KV head | 12/12 | 1 | 2.487 | 33.0 | 5.0 | 63.2 |
| Compression kernels (fig:controlled-group-compression-operator) | ||||||
| Tied K/V branches | 8/8 | 1 | 2.495 | 21.8 | 3.6 | 39.1 |
| Uniform averaging | 8/8 | 1 | 2.497 | 12.5 | 4.7 | 19.2 |
| Uniform averaging, tied K/V, postnorm | 8/8 | 1 | 2.503 | 18.6 | 1.9 | 39.3 |
| Vector gates | 8/8 | 1 | 2.478 | 19.4 | 4.0 | 34.0 |
| Positional encoding and normalization (fig:controlled-group-position-and-normalization) | ||||||
| No Q/K normalization | 8/8 | 1 | 2.485 | 38.5 | 23.8 | 34.6 |
| No positional gate biases | 8/8 | 1 | 2.479 | 34.3 | 4.4 | 60.7 |
| No RoPE (NoPE) | 8/8 | 1 | 2.504 | 29.4 | 5.0 | 40.9 |
| RoPE on 16 dimensions | 8/8 | 1 | 2.482 | 74.2 | 32.9 | 57.2 |
| Local-memory policy and DeepSeek-style kernels (fig:controlled-group-memory-policy-and-implementation) | ||||||
| Uncompressed open tail | 8/8 | 1 | 2.520 | 75.0 | 57.4 | 33.9 |
| Uncompressed open tail | 8/8 | 8 | 2.460 | 53.0 | 25.5 | 49.3 |
| DeepSeek-style, vector gates | 8/4 | 1 | 2.476 | 35.6 | 18.7 | 38.3 |
| DeepSeek-style, scalar gates | 8/4 | 1 | 2.473 | 21.5 | 14.2 | 18.7 |
표 2. Filler-family constructions. Quoted sentences are reproduced verbatim. Repeated symbols are separated by spaces in the actual inputs.
| Family | Fixed text or 24-token endpoint | Length variation |
|---|---|---|
| A | Triple-quoted docstring: ``This module contains optimized tensor kernels used by the model inference runtime.’’ | The next docstring line contains 9–24 = characters before the closing triple quotes. |
| B | Comment: ``This module contains optimized tensor kernels used by the model inference runtime.’’ | A second comment line contains 9–24 = characters. |
| C | Comment: ``Internal model inference kernel implementations.’’ | A second comment line contains 16–31 * characters, with one added at each successive length. |
| D | At 24 tokens: ``This file defines TileLang kernels for block-wise FP8 quantization and the related low-precision operations for model inference.’’ | One natural-language comment is used at each length, with no padding line. |
표 3. DeepSeek-V4-Flash-Base (left) and DeepSeek-V4-Flash-0731 (right) results on the FP8 example. Each entry is \(\Delta=P(8)-P(32)\), computed from the reported probabilities and rounded to three decimal places. Green marks \(\Delta>0\), where the reference 8 is ranked above 32, and red marks \(\Delta<0\). ``Tokens’’ is the filler length, and thin rules separate groups of four lengths, matching the stride of four. DeepSeek-V4-Flash-Base receives the raw prefix with fillers of 24–39 tokens, and DeepSeek-V4-Flash-0731 receives the chat-formatted prompt of app:v4-code-posttrained with fillers of 23–38 tokens.
| DeepSeek-V4-Flash-Base (raw prefix) Tokens | DeepSeek-V4-Flash-Base (raw prefix) A | DeepSeek-V4-Flash-Base (raw prefix) B | DeepSeek-V4-Flash-Base (raw prefix) C | DeepSeek-V4-Flash-Base (raw prefix) D | DeepSeek-V4-Flash-Base (raw prefix) | DeepSeek-V4-Flash-0731 (chat prompt) Tokens | DeepSeek-V4-Flash-0731 (chat prompt) A | DeepSeek-V4-Flash-0731 (chat prompt) B | DeepSeek-V4-Flash-0731 (chat prompt) C | DeepSeek-V4-Flash-0731 (chat prompt) D |
|---|---|---|---|---|---|---|---|---|---|---|
| 24 | -0.786 | -0.791 | -0.007 | +0.060 | 23 | -0.910 | -0.775 | -0.364 | -0.789 | |
| 25 | -0.636 | -0.383 | -0.415 | -0.484 | 24 | +0.615 | +0.451 | +0.644 | -0.829 | |
| 26 | +0.586 | +0.751 | +0.845 | +0.614 | 25 | -0.831 | -0.854 | -0.822 | -0.989 | |
| 27 | +0.914 | +0.862 | +0.809 | +0.681 | 26 | -0.936 | -0.939 | -0.824 | -0.875 | |
| 28 | -0.248 | -0.410 | -0.354 | -0.337 | 27 | -0.679 | -0.668 | -0.266 | -0.151 | |
| 29 | -0.043 | +0.119 | -0.533 | -0.764 | 28 | +0.860 | +0.073 | +0.241 | -0.420 | |
| 30 | +0.826 | +0.808 | +0.724 | +0.696 | 29 | -0.901 | -0.238 | -0.713 | -0.813 | |
| 31 | +0.927 | +0.933 | +0.822 | +0.737 | 30 | -0.960 | -0.954 | -0.803 | -0.608 | |
| 32 | -0.219 | -0.660 | -0.119 | -0.129 | 31 | -0.882 | -0.159 | -0.160 | -0.715 | |
| 33 | -0.644 | -0.276 | -0.118 | -0.624 | 32 | +0.282 | -0.384 | +0.822 | -0.566 | |
| 34 | +0.746 | +0.806 | +0.543 | +0.524 | 33 | -0.917 | -0.828 | -0.874 | -0.946 | |
| 35 | +0.904 | +0.829 | +0.895 | +0.653 | 34 | -0.968 | -0.940 | -0.786 | -0.968 | |
| 36 | -0.468 | -0.503 | +0.527 | +0.249 | 35 | -0.869 | -0.438 | -0.826 | -0.787 | |
| 37 | -0.553 | -0.198 | -0.510 | -0.532 | 36 | +0.706 | +0.597 | +0.715 | -0.895 | |
| 38 | +0.887 | +0.852 | +0.768 | +0.591 | 37 | -0.945 | -0.824 | -0.834 | -0.892 | |
| 39 | +0.948 | +0.953 | +0.866 | +0.790 | 38 | -0.903 | -0.790 | -0.770 | -0.880 |
표 4. Filler constructions for the post-trained models. The fixed sentences and formats follow tab:v4-filler-constructions, and each family spans filler lengths \(L=23,\ldots,38\).
| Family | Format | Length variation |
|---|---|---|
| A | Triple-quoted docstring | 8–23 space-separated = characters on the second line. |
| B | Two-line Python comment | 8–23 space-separated = characters on the second line. |
| C | Shorter two-line comment | 15–30 space-separated * characters on the second line. |
| D | Single-line comment | 16 natural-language rephrasings, with no repeated-symbol line. |
표 5. DeepSeek-V4.1-Flash (left) and DeepSeek-V3.1-Base (right) results on the FP8 example. Entries, shading, and ``Tokens’’ follow tab:v4-filler-family-results. DeepSeek-V4.1-Flash receives the chat-formatted prompt with fillers of 23–38 tokens, and thin rules separate pairs of lengths, matching its stride of two. DeepSeek-V3.1-Base receives the same raw-prefix inputs as DeepSeek-V4-Flash-Base, grouped in fours as in tab:v4-filler-family-results.
| DeepSeek-V4.1-Flash (chat prompt) Tokens | DeepSeek-V4.1-Flash (chat prompt) A | DeepSeek-V4.1-Flash (chat prompt) B | DeepSeek-V4.1-Flash (chat prompt) C | DeepSeek-V4.1-Flash (chat prompt) D | DeepSeek-V4.1-Flash (chat prompt) | DeepSeek-V3.1-Base (raw prefix) Tokens | DeepSeek-V3.1-Base (raw prefix) A | DeepSeek-V3.1-Base (raw prefix) B | DeepSeek-V3.1-Base (raw prefix) C | DeepSeek-V3.1-Base (raw prefix) D |
|---|---|---|---|---|---|---|---|---|---|---|
| 23 | +0.124 | +0.245 | +0.358 | +0.555 | 24 | +0.316 | +0.362 | +0.355 | +0.242 | |
| 24 | -0.555 | -0.555 | -0.462 | +0.124 | 25 | +0.477 | +0.315 | +0.359 | -0.003 | |
| 25 | +0.124 | +0.358 | +0.462 | +0.462 | 26 | +0.600 | +0.316 | +0.348 | +0.203 | |
| 26 | -0.555 | -0.635 | -0.124 | +0.124 | 27 | +0.274 | +0.486 | -0.026 | +0.140 | |
| 27 | +0.358 | +0.555 | +0.462 | +0.245 | 28 | +0.430 | +0.363 | +0.303 | +0.011 | |
| 28 | -0.555 | -0.124 | -0.635 | +0.124 | 29 | +0.303 | +0.259 | +0.273 | +0.463 | |
| 29 | +0.358 | +0.462 | +0.124 | +0.124 | 30 | +0.240 | +0.062 | +0.081 | +0.140 | |
| 30 | -0.462 | -0.555 | -0.245 | -0.245 | 31 | +0.392 | +0.316 | +0.464 | +0.236 | |
| 31 | +0.358 | +0.358 | +0.358 | +0.555 | 32 | +0.346 | +0.539 | +0.026 | -0.054 | |
| 32 | -0.635 | -0.704 | -0.462 | -0.245 | 33 | -0.065 | +0.284 | +0.139 | +0.478 | |
| 33 | +0.462 | +0.245 | +0.462 | +0.124 | 34 | +0.139 | +0.146 | +0.109 | +0.325 | |
| 34 | -0.555 | -0.462 | -0.245 | -0.462 | 35 | +0.398 | +0.453 | +0.062 | +0.017 | |
| 35 | +0.555 | +0.555 | +0.358 | +0.734 | 36 | +0.166 | +0.081 | +0.276 | +0.370 | |
| 36 | -0.635 | -0.555 | -0.245 | -0.358 | 37 | +0.388 | +0.498 | +0.027 | +0.347 | |
| 37 | +0.462 | +0.635 | +0.462 | +0.358 | 38 | +0.397 | +0.324 | +0.396 | +0.143 | |
| 38 | -0.635 | -0.635 | -0.245 | -0.358 | 39 | +0.409 | +0.197 | +0.404 | +0.342 |
표 6. Omarchy lid-close completion across 16 filler variants. The reference token is 0, and every mismatch predicts 1. Green marks correct predictions and red marks mismatches. Spaces group consecutive predictions for readability.
| Model | Top-1 sequence | Mismatches/16 | $P(0)$ range |
|---|---|---|---|
| DeepSeek-V4-Flash-Base (TileLang) | 0000 0001 0001 0001 | 3 | 0.175–0.951 |
| DeepSeek-V4-Flash-0731 | 1100 1100 1100 1100 | 8 | 0.270–0.725 |
| DeepSeek-V4.1-Flash | 0000 0000 1010 1010 | 4 | 0.378–0.867 |
표 7. Station-distance completion across 16 filler variants, ordered by increasing filler length. The reference token is +, and every mismatch predicts -. Green marks correct predictions and red marks mismatches. Spaces group consecutive predictions for readability.
| Model | Top-1 sequence | Mismatches/16 | $P(+)$ range |
|---|---|---|---|
| DeepSeek-V4-Flash-Base (TileLang) | ++++ -+++ ++++ +-++ | 2 | 0.329–0.569 |
| DeepSeek-V4-Flash-0731 | —+ –+- –+- –++ | 11 | 0.123–0.638 |
| DeepSeek-V4.1-Flash | +-+- +-+- +-+- +-+- | 8 | 0.119–0.724 |
표 8. Answer-prefix accuracy (%) by source-key residue \(r=t_K\bmod 8\) for the five DeepSeek models shown in fig:v4_niah. \(n\) is the number of prompts in each residue group, and \(\Delta_res=\max_rAcc_r-\min_rAcc_r\) is reported in percentage points. Accuracies are rounded to two decimal places from exact integer correct counts.
| Model | \(n\) | \(r=0\) | \(r=1\) | \(r=2\) | \(r=3\) | \(r=4\) | \(r=5\) | \(r=6\) | \(r=7\) | \(\Delta_res\) |
|---|---|---|---|---|---|---|---|---|---|---|
| DeepSeek-V4-Flash-Base | 256 | 43.75 | 69.53 | 66.02 | 29.69 | 44.92 | 69.92 | 64.45 | 32.81 | 40.23 |
| DeepSeek-V4-Flash-0731 | 256 | 80.47 | 88.67 | 98.05 | 96.48 | 81.25 | 90.23 | 99.61 | 96.09 | 19.14 |
| DeepSeek-V4-Pro-Base | 256 | 60.94 | 88.28 | 78.91 | 56.25 | 62.50 | 91.02 | 80.47 | 58.20 | 34.77 |
| DeepSeek-V4-Pro-0813 | 256 | 78.13 | 89.84 | 91.41 | 77.34 | 77.34 | 89.45 | 92.19 | 79.69 | 14.84 |
| DeepSeek-V4.1-Flash | 2560 | 95.00 | 89.22 | 95.12 | 89.69 | 94.69 | 90.31 | 95.31 | 89.73 | 6.09 |
이 글의 그림은 arXiv:2609.36322 원본에서 가져왔습니다 (CC BY 4.0). 크기와 형식만 바꿨습니다.
댓글