MassAlloc Attention(MALA): 어텐션이 스스로 연산을 배분하게 하다
TL;DR — 풀 소프트맥스 어텐션(FullAttn)은 매 causal 타일마다 QK 점수 생성 이후 의 연산(post-score)을 전부 수행하지만, MALA는 어텐션이 스스로 만든 정규화 기여도(normalized mass)로 post-score 연산을 골라서 수행한다. 그 결과 FullAttn 수준의 품질을 유지하면서 학습 forward/backward 지연을 각각 $2.2\times$ / $3.0\times$, 디코딩 지연을 $1.6\times$ 줄이고, 14B 모델의 32K 장문 학습에서는 총 훈련 FLOPs를 $23.1\%$ 절감한다 (근거: Abstract, §3).
핵심 아이디어
어텐션 연산을 두 단계로 나눠 보면 그림이 단순해진다.
- Score discovery — $Q$ 와 $K$ 를 곱해 $\mathbf{S}_{ij}=\mathbf{Q}_i\mathbf{K}_j^\top$ 를 만드는 단계.
- Post-score execution — 그 뒤의 모든 것. forward에서는 softmax 갱신, $V$ 로드, $PV$ 누적이고, backward에서는 확률 재구성과 $\mathrm{d}P$, $\mathrm{d}S$, $\mathrm{d}Q$, $\mathrm{d}K$, $\mathrm{d}V$ 계산이다 (근거: §2.1).
FullAttn은 이 두 단계를 모든 합법 causal 타일에 대해 빠짐없이 실행한다. 하지만 실제 어텐션 분포는 극도로 비균일하다. 질량(mass)은 국소 영역, 싱크 토큰, 그리고 소수의 검색 관련 상호작용에 집중되고, 나머지 대부분의 상호작용은 무시해도 될 정도로 작은 정규화 질량을 받는다 (근거: §1). 그런데도 dense 커널은 기여도가 낮은 타일까지 전부 처리한다.
MALA의 핵심 주장은 여기에 있다. 어텐션은 이미 점수와 softmax 통계를 만들고 있으니, 그 정보로 어떤 타일을 더 계산할지 스스로 결정하게 하자는 것이다. QK 점수 접근은 완전히 유지하면서, 정규화 기여도가 낮은 타일의 post-score 연산만 생략한다.
즉, 저자들은 “어텐션 자신의 정규화 기여도로 post-score 연산을 배분하면, 연산자 충실도·모델 품질·장거리 검색을 보존하면서 훈련·추론 비용을 줄일 수 있다” 고 가정한다.
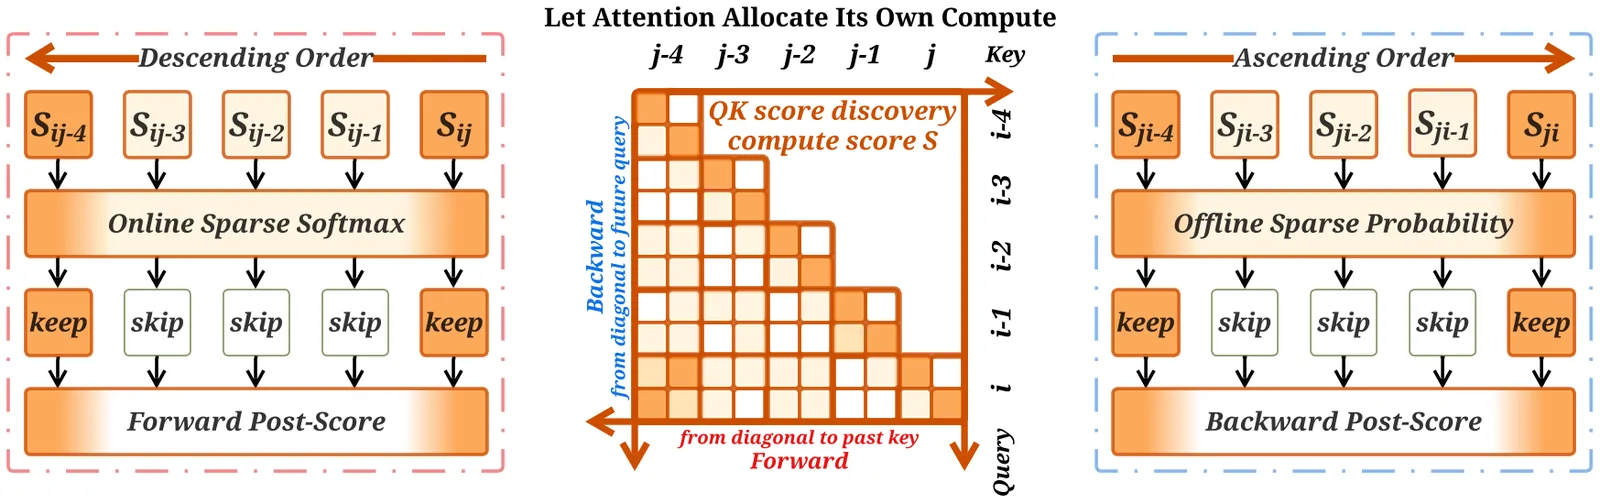
원문 Figure 1(fig:teaser). 왼쪽부터 forward와 backward의 흐름을 보여준다. forward는 진화하는 온라인 softmax 정규화값(evolving normalizer)으로, backward는 forward가 저장해 둔 최종 정규화값(finalized normalizer)을 재사용한다. 핵심은 스코어 발견(score discovery)은 모든 타일에 대해 유지된다는 점이다 (근거: §1, Fig. 1).
배경: 그들이 해결한 문제
컨텍스트 길이는 수천에서 수십만 토큰으로 확장되고 있다. 장문 이해, 다중 턴 추론, 저장소 단위 코드 생성이 이를 견인한다 (근거: §1). 긴 컨텍스트의 어텐션은 연산과 메모리 트래픽을 크게 늘린다.
FlashAttention은 타일링·퓨전·온라인 softmax로 self-attention의 IO 효율을 크게 개선했다. 하지만 그 개선은 실행 패턴 자체 를 바꾸지 않는다. 여전히 모든 합법 causal 타일은 QK 점수가 만들어진 뒤 post-score 계산을 전부 수행한다 (근거: §1).
이 논문이 지적하는 기존 방법들의 구조적 한계는 크게 세 갈래다 (근거: §1, §4).
- 고정 스파스(fixed sparse) — 로컬 윈도우·구조화 블록·글로벌 토큰처럼 위치가 정해주는 서포트를 쓴다. 위치 기반이라 데이터가 실제로 필요로 하는 상호작용과 어긋날 수 있다.
- 동적 스파스(dynamic sparse) — 내용 기반 점수·라우팅으로 토큰/블록을 선택 한다. 이들은 배제된 상호작용의 QK 계산 자체를 생략할 수 있다는 장점이 있지만, 선택을 위한 별도 라우터·인덱서·마스크 상태를 요구한다.
- 적응형 top-p — 추정 질량 목표로 서포트를 가변적으로 고른다. 질량을 추정 하며, 임계값을 따로 보정해야 하는 경우도 있다.
이 사이에 비어 있는 틈이 MALA의 자리다. “post-score 연산을, 어텐션 루프 안에서, 어텐션 자신의 정규화 기여도로 배분하면 어떨까?” QK 점수 접근은 보존하면서(post-score만 줄임) 학습·추론 모두에서 효율적인 fused 프리미티브를 만드는 것. 이것이 이 논문이 명시적으로 해결하려는 연구 공백이다 (근거: §1, §2.4).
새로운 접근법: MassAlloc Attention
MALA는 스파스 어텐션을 “분포 조건부 연산 배분(distribution-conditioned compute allocation)” 으로 재정의한다. 세 가지 기여로 요약된다 (근거: §1).
- 정식화 — 모든 causal 상호작용은 score-accessible 상태로 남기고, 어텐션이 만들어낸 확률 분포가 post-score 일을 결정한다는 관점의 확립 (§1).
- 구현 — 온라인 forward 규칙과 오프라인 backward 규칙을 쌍으로 만들고, 공통의 정규화 질량 허용오차를 사용하는 fused 프리미티브. 표준 어텐션 상태만 사용하며, forward에는 omitted-mass 상한이 있고 backward는 forward 서포트 안에 중첩된(nested) 서포트를 가진다 (§2.2, §2.4).
- 평가 — matched-work 통제 실험, 연산자 충실도, 통제된 연상 회상, 커널 실행, 스케일링 법칙 훈련, 모델 수준 평가라는 6단계 검증 (§3).
핵심 설계 포인트는 다음 세 가지다.
하나의 허용오차로 모든 것을 관장
공통 무차원 허용오차 $\tau$ 를 정의한다. 균일 어텐션이 각 키에 할당하는 확률 $1/L_q$ ($L_q$ 는 쿼리 $q$ 가 볼 수 있는 causal 키 개수)를 기준으로, 길이-인지 임계값 $\tau/L_q$ 를 만든다. 타일의 최대 기여비가 이 임계값보다 작으면 그 타일은 생략된다 (근거: §2.1).
이 $\tau$ 하나가 훈련 forward, 훈련 backward, 추론 prefill, 자동회귀 디코딩을 전부 관장한다. 실험 전반에서 표준 값 $\tau=1$ 을 쓴다 (근거: §3, §2.4). 임계값은 예산 이 아니라 허용 기여도 를 의미하므로, 날카로운(sharp) 어텐션 행은 많은 타일을 버리고, 분산된(diffuse) 행은 더 많이 유지한다.
forward: 온라인 스파스 소프트맥스
forward는 표준 온라인 softmax의 running 최대값 $\mathbf{m}_i$ 와 shifted 정규화합 $\ell_i$ 를 유지한다. 지금까지 유지된 키의 정규화값은
$$ Z_q^{(t)} = \sum_{k \in R_q^{(t)}} \exp(s_{qk}) = \exp\bigl(m_q^{(t)}\bigr)\,\ell_q^{(t)} $$이고, 후보 타일의 최대 기여비는
$$ r_{qj}^{(t)} = \frac{\exp\bigl(\max_{k \in J_j \cap \mathcal{C}_q} s_{qk}\bigr)}{Z_q^{(t)}} $$로 상한이 잡힌다. 분모가 “지금까지 유지된 질량"만 포함하므로 이 비는 1을 넘을 수 있고, 해당 타일의 dense-softmax 확률을 상한 지배한다. 로그를 취하면 커널이 실제로 쓰는 블록 단위 판정이 된다 (근거: §2.2):
$$ \operatorname{rowmax}(\mathbf{S}_{ij}) - \mathbf{m}_i - \log \ell_i < \log\!\bigl(\tau / \mathbf{L}_i\bigr) $$생략된 타일은 $\mathbf{m}_i$, $\ell_i$, 출력 누적기 $\mathbf{O}_i$ 를 그대로 두고, 유지된 타일만 표준 온라인-softmax 갱신을 한다. 따라서 최종 출력은 유지된 타일 위에서 재정규화된 일반 softmax 어텐션과 같다 (근거: §2.2).
backward: 오프라인 스파스 확률
backward는 forward의 부분 정규화값 시퀀스를 재생하지 않고, forward가 저장해 둔 최종 정규화값 $Z_{R,q}$ 를 그대로 쓴다. 여기서 “offline"은 타일을 검사할 때 정규화값이 이미 확정되어 있다 는 뜻이지, 오프라인 보정을 한다는 뜻이 아니다 (근거: §2.2).
정확한 산술에서는 $Z_{R,q} \ge Z_q^{(t)}$ 이므로, 최종 분모를 쓰면 어떤 키의 기여비도 커지지 않는다. 따라서 forward가 생략한 타일은 backward에서도 반드시 생략되고, backward는 forward가 (정규화값이 완성되기 전에) 유지했던 타일을 추가로 생략할 수 있다. 결과적으로 backward 서포트가 forward 서포트 안에 중첩(nested) 되며, 이는 저장된 forward 마스크 없이 달성된다 (근거: §2.2).
중요한 뉘앙스: 이 중첩이 forward 연산자의 정확한 미분 을 보장하지는 않는다. backward가 일부 기울기 기여를 더 생략할 수 있고, 그 오차는 $\mathrm{d}O$ 와 $V$ 에도 의존한다. 그래서 기울기 충실도는 연산자 수준에서 직접 측정한다 (근거: §2.2).
forward 생략 질량의 이론적 상한
부록의 Proposition 1은 forward가 얼마나 안전한지 정량적으로 보장한다. 어떤 쿼리에 대해 $Z_R$ 을 유지된 질량, $Z_O$ 를 생략된 질량이라 하면, 생략 확률 질량은
$$ \epsilon_q = \frac{Z_O}{Z_R + Z_O} \le \frac{\tau}{1+\tau} $$로 묶인다. $\tau=1$ 이면 생략 질량은 최대 $50\%$ 까지(매우 느슨한 상한) 허용되지만, 실제 측정치는 이보다 몇 자릿수 낮다 (근거: Appendix §A.2, Prop. 1). 또 값 벡터의 노름이 $V_{\max}$ 이하이면 출력 오차는 $\lVert o - \widetilde{o}\rVert \le \frac{2\tau}{1+\tau} V_{\max}$ 로 묶인다. 다만 이는 정확한 산술을 가정한 것이고, fused 구현의 유한 정밀도에서는 반올림 오차까지 감안해야 한다 (근거: Appendix §A.2).
작동 원리: 구체적인 예시로 살펴보기
추상적인 판정식을 작은 입력으로 따라가 보자. (설명용 예시 — 논문의 실험과 무관한, 메커니즘만 보여주는 예시다.)
쿼리 하나가 causal 키 4개(위치 $k_0, k_1, k_2, k_3$)를 본다고 하자. $\tau=1$ 이므로 임계값은 $\tau/L_q = 1/4 = 0.25$ 다. 각 키의 $\exp(\text{score})$ 가 다음과 같다고 하자.
| 키 | $\exp(s_k)$ | 의미 |
|---|---|---|
| $k_3$ (최근) | $e^2 \approx 7.39$ | 중간 강도의 최근 토큰 |
| $k_2$ | $1$ | 약한 토큰 |
| $k_1$ (먼) | $e^3 \approx 20.1$ | 강한 장거리 토큰 |
| $k_0$ | $1$ | 약한 토큰 |
forward는 대각선($k_3$)부터 과거 방향으로 순회한다. 상태 변화를 단계별로 추적하면:
| 단계 | 타일 | $Z_q^{(t)}$ | $r_{qj}^{(t)} = \frac{\exp(s)}{Z_q^{(t)}}$ | 판정 |
|---|---|---|---|---|
| 1 | $k_3$ | 0 (첫 타일) | $\infty$ | 유지 (첫 합법 타일은 항상 유지) |
| 2 | $k_2$ | 7.39 | $1/7.39 \approx 0.135$ | 생략 ($0.135 < 0.25$) |
| 3 | $k_1$ | 7.39 | $20.1/7.39 \approx 2.72$ | 유지 ($2.72 > 0.25$) |
| 4 | $k_0$ | 27.49 | $1/27.49 \approx 0.036$ | 생략 ($0.036 < 0.25$) |
최종 유지 집합은 $\{k_3, k_1\}$ 이고, 출력은 이 둘 위에서 재정규화된 softmax다. dense softmax라면 $k_0, k_2$ 도 각각 약 $3.4\%$ 의 질량을 받았겠지만, MALA는 이들을 생략한다. 핵심은 두 가지다. (1) 최근 토큰($k_3$)과 강한 장거리 토큰($k_1$)이 모두 유지된다 — 지역성은 실행 순서의 사전(prior) 일 뿐, 서포트 가정이 아니다. (2) 약한 토큰들은 임계값 아래로 떨어져 생략된다.
이 4-토큰 예시에서 생략 질량은 약 $6.8\%$ 로 커 보이지만, 실제 대규모 컨텍스트에서는 $L_q$ 가 수천~수만이라 $\tau/L_q$ 가 극도로 작아지고 질량이 소수의 토큰에 집중되므로, 논문이 보고하는 생략 질량은 $0.006\%$ 수준까지 내려간다 (근거: §3, Fig. 2). 이 예시는 어떤 순서로 어떤 판정이 일어나는지 만 보여주는 것이다.
같은 판정이 backward에서도 반복되지만, backward는 최종 정규화값($27.49$)을 그대로 쓰므로 forward보다 더 선택적일 수 있다. 예를 들어 forward가 (정규화값이 아직 작았던 초기 단계에) 유지한 타일이 있었다면, backward는 이를 추가로 생략할 수 있다 (근거: §2.2).
성능 검증: 주요 결과
저자들은 질문을 점점 넓혀가는 6단계로 검증한다: 고정 일량에서의 배분 품질 → 컨텍스트 길이 전반의 충실도 → 장거리 연관성 → 커널 실행 효율 → 모델 규모별 품질-비용 → 완전한 모델 평가 (근거: §3).
1) 같은 일량에서, 배분 방식이 결정적이다
가장 설득력 있는 실험은 “matched-work” 통제다. 8K 컨텍스트에서 모든 정책이 정확히 같은 총 post-score 일량(쿼리당 약 1,024 슬롯)을 수행하도록 고정하고, 일을 어떻게 나눠 주는지 만 비교했다 (근거: §3, Table 1).
| 배분 범위 | 선택 신호 | 생략 질량 평균 | 출력 오차 평균 |
|---|---|---|---|
| 위치만 (position) | 최종 참조 질량 | 0.6012% | 0.6231% |
| 레이어/헤드/위치 | 최종 참조 질량 | 0.1721% | 0.2817% |
| 입력/레이어/헤드/위치 (per-instance oracle) | 최종 참조 질량 | 0.0182% | 0.0164% |
| MALA (온라인 질량 상한) | 온라인 질량 | 0.0188% | 0.0174% |
정적 배분에서 입력별 배분(oracle)으로 바꾸면 생략 질량이 $9.5\times$, 출력 오차가 $17.2\times$ 줄어든다. MALA의 온라인 판정은 이 oracle에 거의 근접한다(0.0188% vs 0.0182%). 즉 이득의 원천은 “일량"이 아니라 “분포 적응적 배분” 그 자체다 (근거: §3, Table 1).
2) 하나의 허용오차가 컨텍스트 전반에서 유지된다
동일한 $\tau=1$ 로 1K~32K 토큰 프리픽스를 돌렸을 때, forward 일량은 쿼리당 470→1,066 슬롯, backward는 462→1,058 슬롯으로 증가하다가 8K 이후 1,010~1,066으로 안정화된다. 이 안정 구간이 아래 실험들의 기준값 “약 1,024 슬롯"의 근거다. 전 길이에 걸쳐 생략 질량은 최대 0.0062%(P95 0.032%), 상대 출력 오차는 최대 0.021%(P95 0.14%)다. 기울기 오차는 $\mathrm{d}Q$ 0.38%, $\mathrm{d}K$ 0.35%, $\mathrm{d}V$ 0.17% 이내다 (근거: §3, Fig. 2).
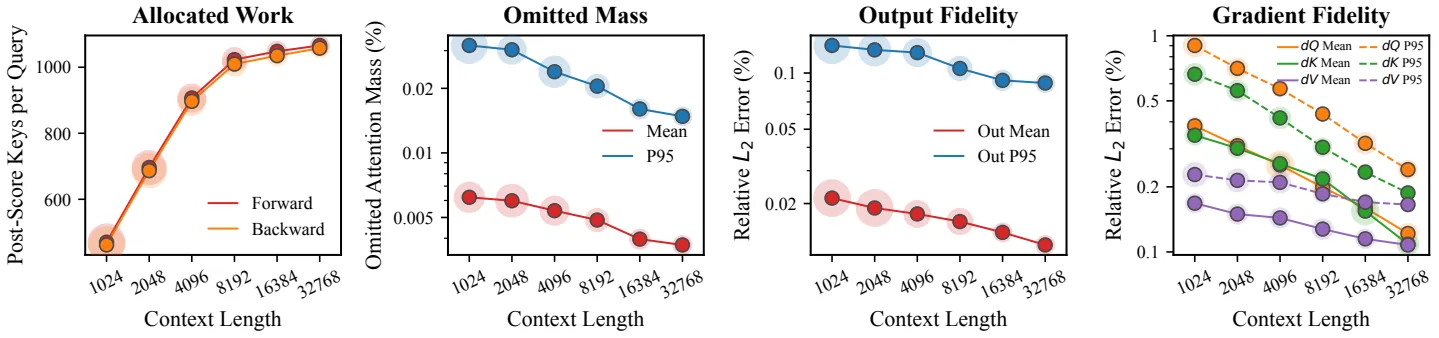
원문 Figure 2(fig:operator_fidelity). 가로축은 컨텍스트 길이(1K~32K), 상단 패널은 쿼리당 평균 post-score 키 슬롯, 하단 패널은 생략 질량·출력·기울기의 상대 오차다. 컨텍스트가 $32\times$ 늘어도 일량은 8K 이후 평탄해지고 오차는 낮게 유지된다 — 즉 허용오차 하나로 전 길이를 커버할 수 있다는 주장의 근거다 (근거: §3, Fig. 2).
3) 장거리 연관성은 보존된다
통제된 연상 회상(256개 키-값 쌍)에서, MALA는 컨텍스트가 길어져도 FullAttn을 밀착 추적한다. 시퀀스 길이 8,192, $d_{model}=512$ 에서 MALA 89.67% vs FullAttn 89.97%인 반면, 고정 예산 스파스 기법들은 급락한다 — DSA 52.61%, MoBA 47.25%, NSA 22.61% (근거: §3, Fig. 3).
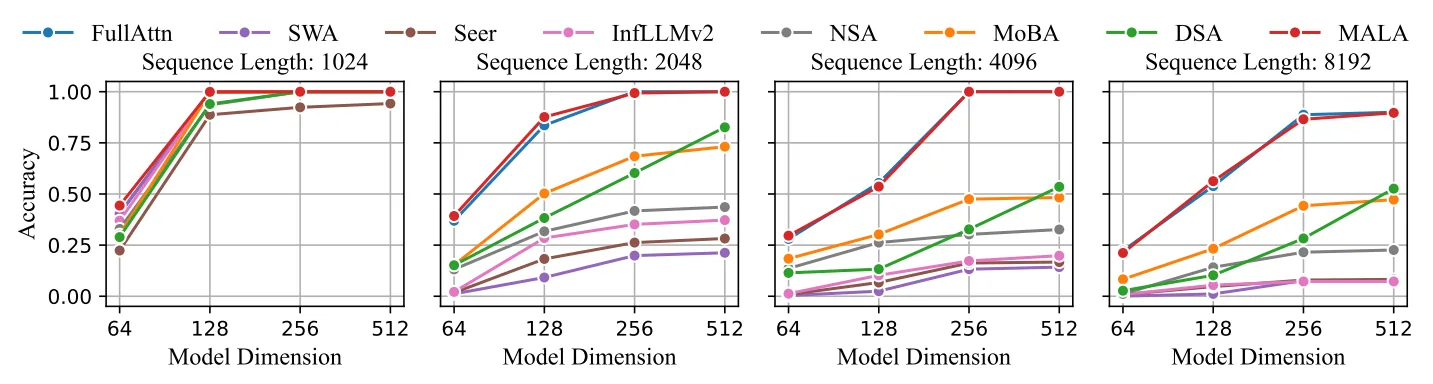
원문 Figure 3(fig:ar). 패널은 모델 차원($d_{model}$=64~512), 곡선은 시퀀스 길이(1,024~8,192)에 따른 정확도다. MALA가 FullAttn 곡선에 붙어 가는 반면, 고정 예산(1,024 슬롯) 스파스 기법들은 컨텍스트가 길어질수록 연관성을 크게 잃는다. 이는 “어텐션 스스로 배분한 지원이, 외부 선택·고정 서포트가 놓치는 연관성을 지킨다"는 핵심 주장을 뒷받침한다 (근거: §3, Fig. 3).
4) 실제 커널에서 지연 시간이 줄어든다
8대의 H100 GPU, 텐서 병렬 $TP=8$ 로 128K 토큰에서 측정했다. MALA는 FullAttn 대비 학습 forward 지연 $2.2\times$, backward $3.0\times$, 추론 디코딩 $1.6\times$ 절감한다. 비교 기법 중 forward·backward 지연이 가장 낮고, 디코딩은 DSA 대비 3% 이내로 근접하면서 FullAttn보다 $1.6\times$ 빠르다. 할당이 어텐션 루프에 융합되어 표준 어텐션 상태만 쓰기 때문에, 피크 메모리는 FullAttn 수준을 유지한다 (근거: §3, Fig. 4).
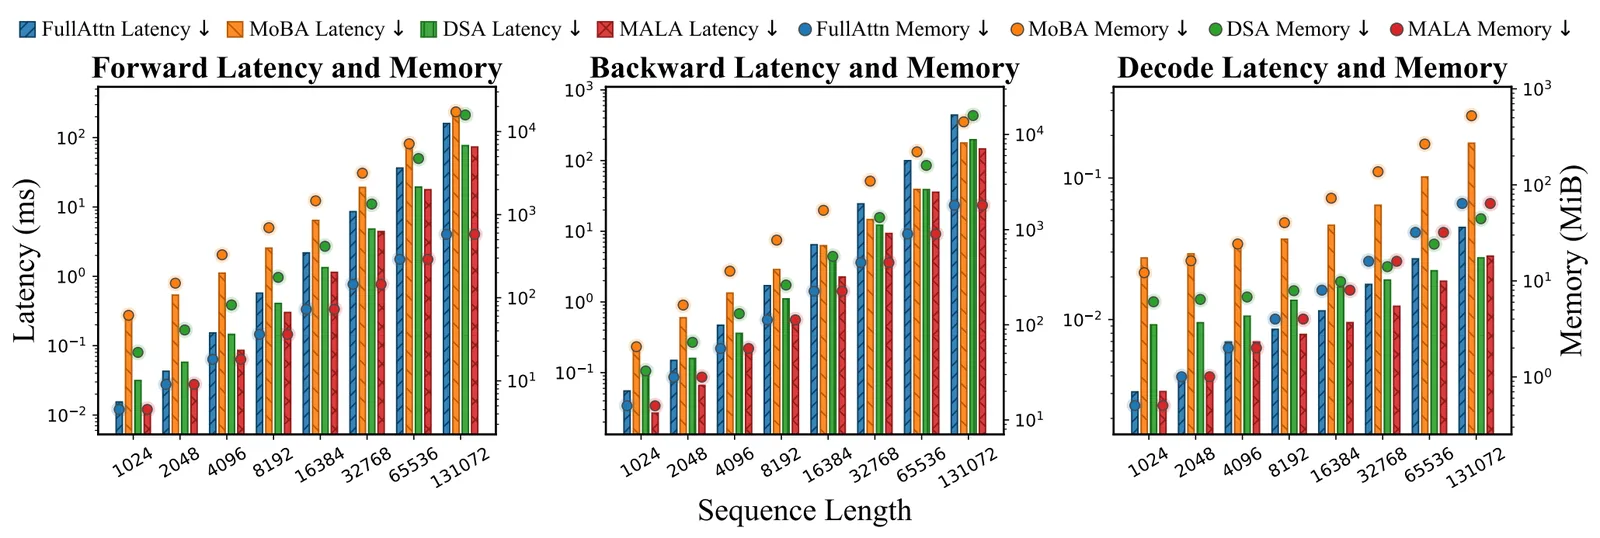
원문 Figure 4(fig:latency_memory). 세 패널은 각각 forward, backward, 디코딩의 지연(왼쪽 축, 막대)과 랭크당 피크 메모리(오른쪽 축, 마커)다. FullAttn/MoBA/DSA/MALA를 비교하며, MALA는 지연을 낮추면서도 피크 메모리는 FullAttn과 동일 수준이다. 측정은 각 기법의 score-discovery·선택 경로 전체를 포함한다 (근거: §3, Fig. 4).
5) 품질-비용 프런티어가 낮은 FLOPs 쪽으로 이동한다
0.6B~14B 다섯 규모의 스케일링 법칙 훈련에서 MALA는 perplexity를 FullAttn에 밀착 추적하면서 총 훈련 FLOPs를 줄인다. 14B에서 perplexity 차이는 두 단계 모두 0.001 미만인데, 총 FLOPs는 4K 사전학습에서 $2.5\%$, 32K 장문 학습에서 $23.1\%$ 절감된다. 장문에서 절감이 큰 이유는 실현 분포가 정당화하는 post-score 일만 수행하면서, 완전한 causal QK score-discovery 비용은 계속 포함되기 때문이다 (근거: §3, Fig. 5).
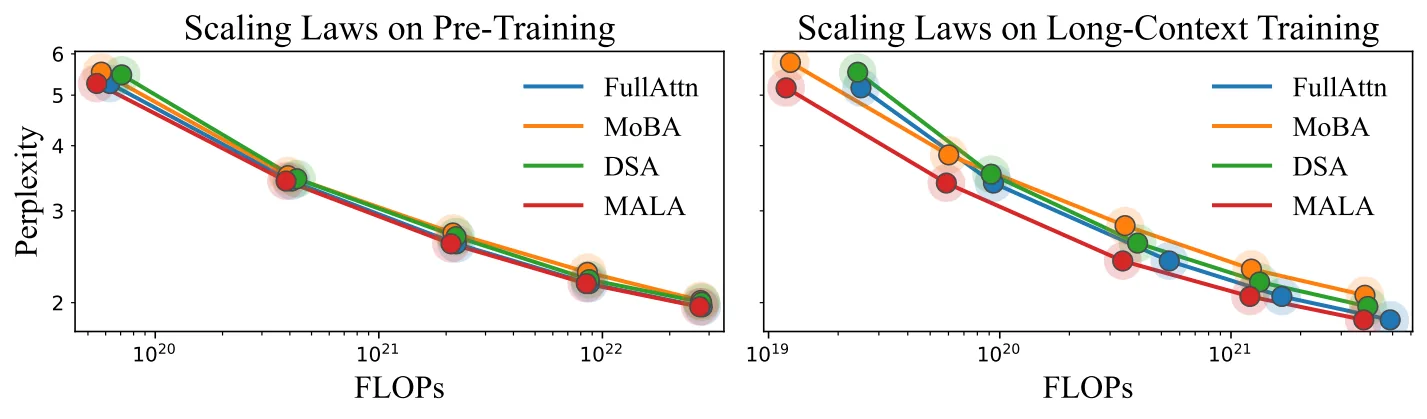
원문 Figure 5(fig:scaling_laws_flops). 왼쪽은 4K 사전학습, 오른쪽은 32K 장문 학습 단계의 perplexity-FLOPs 곡선이다. FLOPs 축은 완전한 score discovery와 각 기법의 배분/선택 비용을 포함한다. MALA 곡선이 FullAttn을 밀착 추적하면서 왼쪽(저비용)으로 이동한 것이 핵심 — 특히 32K 패널에서 격차가 벌어진다 (근거: §3, Fig. 5).
6) 모델 수준 품질은 유지된다
최종 14B 모델과 별도로 계속 학습한 32B 모델의 평가 요약이다 (근거: §3, Table 2).
| 규모 | 방법 | 지식 | 추론 | RULER 32K | RULER 128K |
|---|---|---|---|---|---|
| 14B | FullAttn | 72.32 | 64.46 | 89.42 | 65.84 |
| 14B | MoBA | 70.01 | 58.07 | 86.85 | 60.17 |
| 14B | DSA | 70.11 | 62.04 | 87.59 | 63.05 |
| 14B | MALA | 72.48 | 64.66 | 89.45 | 65.75 |
| 32B | FullAttn | 75.62 | 75.67 | 92.70 | 82.03 |
| 32B | MALA | 75.75 | 76.10 | 92.71 | 82.56 |
MALA는 두 규모 모두에서 지식·추론·기본 32K 검색·YaRN 외삽 128K 검색의 평균이 FullAttn과 동등하거나 근소하게 앞선다. 주목할 점은 고정 예산을 쓰는 MoBA·DSA가 14B에서 FullAttn에 크게 뒤처지는(지식 70.01/70.11, 추론 58.07/62.04) 반면, 고정 예산이 없는 MALA는 FullAttn과 어깨를 나란히 한다는 사실이다 (근거: §3, Table 2, Appendix Table 5~7).
우리의 관점: 강점, 한계, 그리고 이 연구가 중요한 이유
강점
이 논문의 가장 큰 미덕은 인과관계를 분리하는 실험 설계다. matched-work 통제(Table 1)가 “이득이 일량 감소가 아니라 분포 적응적 배분에서 나온다"는 점을 oracle 대비로 증명하고, 연산자 충실도(Fig. 2)가 허용오차의 범용성을, 연상 회상(Fig. 3)이 장거리 연관성 보존을, 커널 측정(Fig. 4)이 실제 가속을, 스케일링 법칙(Fig. 5)이 규모 확장성을 각각 독립적으로 검증한다. 한 실험이 다른 실험의 공백을 메우는 구조다.
설계 측면에서도 깔끔하다. 하나의 $\tau$ 가 훈련과 추론을 관통하고, 별도의 마스크·인덱스·라우터 상태를 만들지 않으며, forward 생략 질량은 명시적 상한(Prop. 1)을 갖는다. backward 서포트가 forward 안에 중첩된다는 성질은 저장 오버헤드 없이 두 패스의 일관성을 보장한다 (근거: §2.4, Appendix §A.2).
한계
저자들이 명시적으로 인정한 한계부터 짚자.
- QK 복잡도는 여전히 이차(quadratic)다. 절감은 post-score 연산의 데이터-의존적 상수배 감소일 뿐, score discovery는 완전하게 수행된다 (근거: §2.3, §5). 지원 스파스 기법들은 배제 영역의 QK 계산을 아예 생략할 수 있다는 점에서 MALA와 상보적이다.
- backward는 forward의 정확한 미분이 아니다. 중첩이 근사 미분을 보장하지 않으므로 기울기 충실도는 이론이 아니라 측정으로 검증한다 (근거: §2.2).
- 정리(Prop. 1)의 상한은 정확한 산술 가정이며, fused 구현의 유한 정밀도에서는 반올림 오차가 더해진다 (근거: Appendix §A.2).
리뷰어로서 추가로 짚을 잠재 한계는 다음과 같다.
- $\tau=1$ 의 민감도가 검증되지 않았다. 공통 허용오차가 별도 보정 없이 범용으로 동작한다는 주장이지만, $\tau$ 를 변화시킨 절제(ablation) 실험은 본문에 없다. Top-Theta처럼 오프라인 보정을 하는 계열과 달리, 단일 상수를 관철했을 때의 최적성은 열려 있다 (근거: §4).
- 절대 지연·비용이 보고되지 않았다. $2.2\times$/$3.0\times$/$1.6\times$ 같은 상대 배수만 있고 ms 단위 지연이나
$/1M토큰 비용은 없다. 실절감은 컨텍스트 길이·분포·배치에 의존하므로, 운영 조건별 절대치는 미검증이다 (근거: §3). - 디코딩 절감($1.6\times$)이 학습($2.2\times$/$3.0\times$)보다 작다. 단일 토큰 디코딩에서는 QK score discovery의 비중이 상대적으로 커지기 때문으로 보인다. 지연 민감한 서빙 환경에서의 이점은 학습만큼 뚜렷하지 않을 수 있다.
- KV 캐시 자체는 건드리지 않는다. MALA는 캐시를 압축·축출하지 않고 온전히 유지하므로, 캐시 용량이 병목인 시나리오의 절감은 별도 기법에 맡긴다 (근거: §2.4, §4).
이 연구가 중요한 이유
지금까지의 효율적 어텐션 연구가 주로 어떤 토큰/블록을 볼 것인가(서포트 선택) 에 집중했다면, MALA는 점수는 다 보되, 그 뒤의 일만 골라 하자 는 상보적 축을 연다. 이 두 축은 서로 배타적이지 않다. score discovery까지 줄이는 서포트 스파스와 post-score를 줄이는 MALA를 결합하면, QK 계산과 post-score 계산을 각각 최적으로 줄일 수 있다. 특히 “고정 예산 없이도 FullAttn 품질을 유지한다"는 결과는, 예산 하이퍼파라미터 튜닝이라는 스파스 어텐션의 오랜 골칫거리를 우회할 수 있음을 보여준다 (근거: §1, §4).
다음 단계는?: 앞으로의 길
저자들은 결론에서 명시적인 향후 연구 목록을 제시하지 않는다. 대신 관련 연구 절에서 MALA가 “전체 KV 이력을 score discovery와 value 접근을 위해 유지하고, 캐시 저장·배치는 별도 최적화 기회로 남긴다"고 명시한다 (근거: §4, §5). 이 방향성과 앞서 짚은 한계를 종합하면 합리적인 다음 단계는 다음과 같다.
- QK discovery도 줄이기 — 서포트 스파스 기법(MoBA·DSA 등)과의 결합. post-score 절감은 유지하면서 score discovery의 이차 비용까지 내리는 것이 장문 확장성의 다음 병목이다.
- $\tau$ 의 자동/오프라인 보정 — 단일 상수의 범용성 검증을 넘어, 레이어·헤드·컨텍스트 길이별로 $\tau$ 를 보정했을 때의 품질-비용 파레토를 측정하는 연구.
- 서빙 절대 지표 검증 — 디코딩의 절대 지연(ms/token)·TTFT·배치 확장성을 보고해, 학습 중심이 아닌 운영 관점의 이점을 확인.
- 더 긴 컨텍스트(1M+)와 다른 모달리티 — YaRN 128K 외삽은 이미 확인됐지만, 네이티브 초장문과 비전·멀티모달 어텐션에서도 동일한 정규화 질량 배분이 성립하는지 검증.
- KV 캐시 관리와의 결합 — MALA가 유지하는 전체 KV 캐시에 압축·축출 기법을 얹어, 캐시 용량 병목 시나리오까지 커버.
어텐션이 자기 연산을 스스로 배분하게 한다는 이 아이디어는 단순하지만, 6단계의 누적된 실험 설계와 forward/backward의 대칭적 규칙, 그리고 이론적 상한까지 갖춘 채 제시되어 설득력이 높다. 소스는 HKUSTDial/flash-sparse-attention 에 공개되어 있다 (근거: Abstract).
논문 원문의 표
arXiv e-print 의 LaTeX 원본에서 기계적으로 옮긴 표입니다. 숫자는 논문의 값이며 모델을 거치지 않았습니다.
표 1. Matched-work allocation. Every policy executes exactly the same total post-score work, with a shared average of approximately 1,024 slots per query. The first three rows use finalized per-instance reference mass for region selection and differ only in how work is allocated across decisions. Omitted probability mass and relative output $L_2$ error are reported as percentages; statistics pool input-layer-head-query-block allocation decisions.
| Allocation Scope | Selection Signal | Mean Slots | Omitted Mass (%) Mean $\downarrow$ | Omitted Mass (%) P95 $\downarrow$ | Output Error (%) Mean $\downarrow$ | Output Error (%) P95 $\downarrow$ |
|---|---|---|---|---|---|---|
| Position | Final reference mass | $\approx$1,024 | $0.6012$ | $0.9923$ | $0.6231$ | $4.237\phantom {0}$ |
| Layer/Head/Position | Final reference mass | $\approx$1,024 | $0.1721$ | $0.6247$ | $0.2817$ | $0.9237$ |
| Input/Layer/Head/Position | Final reference mass | $\approx$1,024 | $\mathbf{0.0182}$ | $\mathbf{0.0664}$ | $\mathbf{0.0164}$ | $\mathbf{0.1013}$ |
| Input/Layer/Head/Position | MALA online mass bound | $\approx$1,024 | $\underline{0.0188}$ | $\underline{0.0693}$ | $\underline{0.0174}$ | $\underline{0.1017}$ |
표 2. Model-level evaluation summary. Average knowledge and reasoning scores, together with RULER scores at the native 32K context length and after YaRN extrapolation to 128K. Detailed per-task results and uncertainty estimates are reported in Appendix .
| Model Scale | Method | Knowledge | Reasoning | RULER 32K | RULER 128K |
|---|---|---|---|---|---|
| 14B | FullAttn | 72.32 | 64.46 | 89.42 | 65.84 |
| 14B | MoBA | 70.01 | 58.07 | 86.85 | 60.17 |
| 14B | DSA | 70.11 | 62.04 | 87.59 | 63.05 |
| 14B | MALA (ours) | 72.48 | 64.66 | 89.45 | 65.75 |
| 32B | FullAttn | 75.62 | 75.67 | 92.70 | 82.03 |
| 32B | MALA (ours) | 75.75 | 76.10 | 92.71 | 82.56 |
표 3. Associative-recall allocation configurations. Fixed-budget sparse methods use a common 1,024-slot ceiling, with realized work computed after causal clipping and native block expansion. The raw-slot comparison aligns retained interactions; DSA therefore uses the same slot ceiling despite its larger value dimension. MALA uses $\tau=1$, with work determined by normalized-mass allocation.
| Method | Allocation Rule | $d_v/d_{v,\mathrm{ref}}$ | Nominal Slot Ceiling | Raw-Slot Reference |
|---|---|---|---|---|
| FullAttn | Complete causal history | $1\times$ | Full | Full |
| SWA / Seer / InfLLMv2 / NSA | Native support or selector | $1\times$ | 1,024 | after causal clipping |
| MoBA | Native block routing | $1\times$ | 1,024 | after causal clipping |
| DSA | Token-level Top-$K$ | $4\times$ | 1,024 | after causal clipping |
| MALA | Normalized-mass tolerance $\tau=1$ | $1\times$ | - | measured near reference |
표 4. Operator benchmark configurations. The sparse methods target comparable forward post-score FLOP-equivalent work, while reported latency and memory include their complete score-discovery and selection paths.
| Method | $n_h$ | $n_{h_{kv}}$ | $d_{qk}$ | $d_v$ | Allocation | Target Eq. Slots | Precision |
|---|---|---|---|---|---|---|---|
| FullAttn\footnotemark[1] | 64 | 8 | 128 | 128 | Full causal context | Full | BF16 |
| MoBA\footnotemark[2] | 64 | 64 | 128 | 128 | $B=128$, native routing | $\approx$1,024 | BF16 |
| DSA\footnotemark[3],\footnotemark[4] | 64 | 1 | 576 | 512 | Top-$K=256$, FP8 indexer | $\approx$1,024 | BF16/FP8 |
| MALA | 64 | 8 | 128 | 128 | $\tau=1$, fused allocation | measured $\approx$1,024 | BF16 |
표 5. Self-Attention Variants Scaling Laws Configurations. Complete model, training, and attention configurations used in the scaling-law experiments. PS FLOPs/Slot describes allocated forward post-score work; the FLOP-axis additionally includes complete score discovery and method-specific selection.
| Algos | Params | PT/LCT Tok | Batch | PT/LCT LR | $n_{layers}$ | $d_{model}$ | $n_h$ | $n_{h_{kv}}$ | $d_{qk}$ | $d_v$ | PS FLOPs/Slot | PT Alloc | LCT Alloc |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| FullAttn | $\approx$0.6B | 12B,1.5B | 0.256M | 1e-3,1e-4 | 28 | 1024 | 16 | 8 | 128 | 128 | 4096 | 4096 | 32768 |
| MoBA | $\approx$0.6B | 12B,1.5B | 0.256M | 1e-3,1e-4 | 28 | 1024 | 16 | 16 | 128 | 128 | 4096 | $K=1024$ | $K=1024$ |
| DSA | $\approx$0.6B | 12B,1.5B | 0.256M | 1e-3,1e-4 | 28 | 1024 | 16 | 1 | 576 | 512 | 16384 | $K=256$ | $K=256$ |
| MALA | $\approx$0.6B | 12B,1.5B | 0.256M | 1e-3,1e-4 | 28 | 1024 | 16 | 8 | 128 | 128 | 4096 | $\tau=1$ | $\tau=1$ |
| FullAttn | $\approx$1.7B | 34B,4B | 0.512M | 8e-4,8e-5 | 28 | 2048 | 16 | 8 | 128 | 128 | 4096 | 4096 | 32768 |
| MoBA | $\approx$1.7B | 34B,4B | 0.512M | 8e-4,8e-5 | 28 | 2048 | 16 | 16 | 128 | 128 | 4096 | $K=1024$ | $K=1024$ |
| DSA | $\approx$1.7B | 34B,4B | 0.512M | 8e-4,8e-5 | 28 | 2048 | 16 | 1 | 576 | 512 | 16384 | $K=256$ | $K=256$ |
| MALA | $\approx$1.7B | 34B,4B | 0.512M | 8e-4,8e-5 | 28 | 2048 | 16 | 8 | 128 | 128 | 4096 | $\tau=1$ | $\tau=1$ |
| FullAttn | $\approx$4B | 80B,10B | 1M | 6e-4,6e-5 | 32 | 2560 | 32 | 8 | 128 | 128 | 8192 | 4096 | 32768 |
| MoBA | $\approx$4B | 80B,10B | 1M | 6e-4,6e-5 | 32 | 2560 | 32 | 32 | 128 | 128 | 8192 | $K=1024$ | $K=1024$ |
| DSA | $\approx$4B | 80B,10B | 1M | 6e-4,6e-5 | 32 | 2560 | 32 | 1 | 576 | 512 | 32768 | $K=256$ | $K=256$ |
| MALA | $\approx$4B | 80B,10B | 1M | 6e-4,6e-5 | 32 | 2560 | 32 | 8 | 128 | 128 | 8192 | $\tau=1$ | $\tau=1$ |
| FullAttn | $\approx$8B | 164B,20B | 1.6M | 4e-4,4e-5 | 36 | 4096 | 32 | 8 | 128 | 128 | 8192 | 4096 | 32768 |
| MoBA | $\approx$8B | 164B,20B | 1.6M | 4e-4,4e-5 | 36 | 4096 | 32 | 32 | 128 | 128 | 8192 | $K=1024$ | $K=1024$ |
| DSA | $\approx$8B | 164B,20B | 1.6M | 4e-4,4e-5 | 36 | 4096 | 32 | 1 | 576 | 512 | 32768 | $K=256$ | $K=256$ |
| MALA | $\approx$8B | 164B,20B | 1.6M | 4e-4,4e-5 | 36 | 4096 | 32 | 8 | 128 | 128 | 8192 | $\tau=1$ | $\tau=1$ |
| FullAttn | $\approx$14B | 296B,36B | 2M | 3e-4,3e-5 | 40 | 5120 | 40 | 8 | 128 | 128 | 10240 | 4096 | 32768 |
| MoBA | $\approx$14B | 296B,36B | 2M | 3e-4,3e-5 | 40 | 5120 | 40 | 40 | 128 | 128 | 10240 | $K=1024$ | $K=1024$ |
| DSA | $\approx$14B | 296B,36B | 2M | 3e-4,3e-5 | 40 | 5120 | 40 | 1 | 576 | 512 | 40960 | $K=256$ | $K=256$ |
| MALA | $\approx$14B | 296B,36B | 2M | 3e-4,3e-5 | 40 | 5120 | 40 | 8 | 128 | 128 | 10240 | $\tau=1$ | $\tau=1$ |
표 6. Knowledge Benchmark Results. Knowledge evaluation of the scaling-law models at 14B and the continued-training models at 32B. MALA produces averages comparable to FullAttn at both scales and remains close across individual tasks.
| Model | MMLU | MMLU-Pro | BBH | HellaSwag | OBQA | WinoGrande | Avg |
|---|---|---|---|---|---|---|---|
| Gen|5-shot | 5-shot | CoT|3-shot | 5-shot | 5-shot | 5-shot | ||
| 14B-Non-Thinking, temperature=0.6, top_k=20, top_p=0.95, max_gen_toks=32768, seed=[0, 42, 233, 666, 1234] | |||||||
| FullAttn | 78.21$\pm$0.31 | 64.96$\pm$0.46 | 82.59$\pm$0.48 | 80.64$\pm$0.38 | 49.4$\pm2.17$ | 78.16$\pm$1.14 | 72.32 |
| MoBA | 75.78$\pm$0.48 | 58.42$\pm$0.84 | 82.1$\pm$0.44 | 79.7$\pm$0.37 | 49.49$\pm$2.07 | 74.57$\pm$1.47 | 70.01 |
| DSA | 72.5$\pm$0.53 | 59.56$\pm$0.65 | 81.42$\pm$0.62 | 80.22$\pm$0.31 | 49.41$\pm$2.25 | 77.57$\pm$1.19 | 70.11 |
| MALA (ours) | 78.14$\pm$0.31 | 64.67$\pm$0.44 | 82.54$\pm$0.48 | 80.61$\pm$0.36 | 50.0$\pm$2.17 | 78.93$\pm$1.13 | 72.48 |
| 32B-Thinking, temperature=0.6, top_k=20, top_p=0.95, max_gen_toks=32768, seed=[0, 42, 233, 666, 1234] | |||||||
| FullAttn | 77.27$\pm$0.34 | 68.57$\pm$0.41 | 88.39$\pm$0.54 | 83.4$\pm$0.37 | 55.0$\pm$2.23 | 81.14$\pm$1.1 | 75.62 |
| MALA (ours) | 77.37$\pm$0.33 | 68.33$\pm$0.41 | 88.23$\pm$0.55 | 84.69$\pm$0.36 | 55.0$\pm$2.23 | 80.87$\pm$1.13 | 75.75 |
표 7. Reasoning Benchmark Results. Reasoning evaluation of the scaling-law models at 14B and the continued-training models at 32B. MALA matches FullAttn on average at 14B and 32B without a fixed retained-work budget.
| Model | PIQA | GSM8K | Hendrycks-Math | ARC-C | AGIEval | GPQA-Diamond | Avg |
|---|---|---|---|---|---|---|---|
| 5-shot | CoT|4-shot | CoT|4-shot | 0-shot | 0-shot | CoT|3-shot | ||
| 14B-Non-Thinking, temperature=0.6, top_k=20, top_p=0.95, max_gen_toks=32768, seed=[0, 42, 233, 666, 1234] | |||||||
| FullAttn | 81.63$\pm$0.86 | 90.32$\pm$0.93 | 62.46$\pm$0.65 | 61.95$\pm$1.44 | 50.56$\pm$0.71 | 39.87$\pm$3.47 | 64.46 |
| MoBA | 77.54$\pm$0.94 | 87.53$\pm$1.02 | 38.67$\pm$1.39 | 61.35$\pm$0.63 | 46.5$\pm$0.81 | 36.87$\pm$3.52 | 58.07 |
| DSA | 80.35$\pm$0.82 | 89.38$\pm$0.95 | 53.24$\pm$0.86 | 61.74$\pm$1.33 | 47.0$\pm$0.69 | 40.53$\pm$3.86 | 62.04 |
| MALA (ours) | 81.62$\pm$0.85 | 90.83$\pm$0.9 | 62.34$\pm$0.64 | 61.93$\pm$1.47 | 50.54$\pm$0.71 | 40.67$\pm$3.32 | 64.66 |
| 32B-Thinking, temperature=0.6, top_k=20, top_p=0.95, max_gen_toks=32768, seed=[0, 42, 233, 666, 1234] | |||||||
| FullAttn | 85.97$\pm$0.88 | 93.33$\pm$0.69 | 94.94$\pm$0.82 | 69.54$\pm$1.34 | 54.18$\pm$0.68 | 56.06$\pm$3.54 | 75.67 |
| MALA (ours) | 85.94$\pm$0.88 | 95.45$\pm$0.57 | 94.25$\pm$0.83 | 69.8$\pm$1.34 | 53.87$\pm$0.66 | 57.29$\pm$2.89 | 76.1 |
표 8. Retrieval Benchmark Results. RULER evaluation at the native 32K context length and after YaRN extrapolation to 128K. MALA remains comparable to FullAttn across both model scales and context lengths.
| Model | NIAH-S | NIAH-MK | NIAH-MQ | NIAH-MV | RULER-VT | RULER-CWE | RULER-FWE | RULER-QA | Avg |
|---|---|---|---|---|---|---|---|---|---|
| 14B Native 32K Sequence Length, seed=[0, 42, 233, 666, 1234] | |||||||||
| FullAttn | 100$\pm$0 | 98.0$\pm$0.65 | 98.8$\pm$0.68 | 95.5$\pm$0.72 | 99.44$\pm$0.2 | 75.7$\pm$0.69 | 91.67$\pm$0.71 | 56.28$\pm$1.2 | 89.42 |
| MoBA | 99.2$\pm$0.4 | 93.2$\pm$0.66 | 98.3$\pm$0.71 | 94.8$\pm$0.73 | 99.08$\pm$0.33 | 66.8$\pm$0.99 | 91.3$\pm$0.72 | 52.02$\pm$1.64 | 86.85 |
| DSA | 99.8$\pm$0.2 | 95.2$\pm$0.69 | 97.8$\pm$0.79 | 95.4$\pm$0.74 | 98.87$\pm$0.31 | 69.05$\pm$0.89 | 91.1$\pm$0.74 | 53.51$\pm$1.52 | 87.59 |
| MALA (ours) | 100$\pm$0 | 97.5$\pm$0.68 | 98.6$\pm$0.68 | 95.3$\pm$0.73 | 99.03$\pm$0.22 | 74.32$\pm$0.74 | 93.76$\pm$0.59 | 57.05$\pm$1.18 | 89.45 |
| 32B Native 32K Sequence Length, seed=[0, 42, 233, 666, 1234] | |||||||||
| FullAttn | 100$\pm$0 | 99.87$\pm$0.09 | 99.8$\pm$0.08 | 99.4$\pm$0.13 | 99.64$\pm$0.18 | 85.18$\pm$0.51 | 94.53$\pm$0.53 | 63.2$\pm$0.93 | 92.7 |
| MALA (ours) | 100$\pm$0 | 99.53$\pm$0.11 | 99.95$\pm$0.05 | 99.25$\pm$0.19 | 99.88$\pm$0.07 | 83.3$\pm$0.54 | 96.33$\pm$0.81 | 63.44$\pm$1.02 | 92.71 |
| 14B YaRN 128K Sequence Length, seed=[0, 42, 233, 666, 1234] | |||||||||
| FullAttn | 98.4$\pm$0.51 | 55.2$\pm$1.64 | 88.25$\pm$0.69 | 64.1$\pm$1.16 | 93.04$\pm$0.63 | 5.76$\pm$0.46 | 84.26$\pm$0.79 | 37.73$\pm$2.15 | 65.84 |
| MoBA | 92.2$\pm$0.83 | 51.6$\pm$1.85 | 80.3$\pm$0.87 | 62.05$\pm$1.3 | 90.48$\pm$0.71 | 0.02$\pm$0.06 | 79.93$\pm$0.95 | 24.78$\pm$2.63 | 60.17 |
| DSA | 96.4$\pm$0.62 | 52.7$\pm$1.73 | 83.6$\pm$0.81 | 64.3$\pm$1.16 | 92.48$\pm$0.62 | 4.8$\pm$0.52 | 77.93$\pm$1.16 | 32.19$\pm$2.03 | 63.05 |
| MALA (ours) | 98.6$\pm$0.53 | 54.6$\pm$1.67 | 88.2$\pm$0.69 | 64.2$\pm$1.14 | 93.08$\pm$0.63 | 5.51$\pm$0.45 | 84.17$\pm$0.81 | 37.62$\pm$2.12 | 65.75 |
| 32B YaRN 128K Sequence Length, seed=[0, 42, 233, 666, 1234] | |||||||||
| FullAttn | 99.8$\pm$0.12 | 86.4$\pm$1.35 | 95.7$\pm$0.56 | 88.0$\pm$0.79 | 98.76$\pm$0.22 | 45.68$\pm$1.03 | 93.27$\pm$1.25 | 48.61$\pm$2.17 | 82.03 |
| MALA (ours) | 99.65$\pm$0.13 | 86.3$\pm$1.35 | 95.9$\pm$0.66 | 87.75$\pm$0.79 | 98.69$\pm$0.23 | 45.8$\pm$1.04 | 96.33$\pm$0.81 | 50.03$\pm$1.97 | 82.56 |
이 글의 그림은 arXiv:2609.32712 원본에서 가져왔습니다 (CC BY 4.0). 크기와 형식만 바꿨습니다.
댓글