서로 다른 LLM 사이에서 KV 캐시를 그대로 건네받는 법: HeteroFold
한 줄 요약 (TL;DR) : 서로 다른 토크나이저와 구조를 가진 모델 사이에서도 수신자가 다시 프리필하지 않고 KV 캐시를 재사용하는 방법 HeteroFold가 6개 방향 모두에서 기존 캐시 전송을 앞지르고 32K 문맥에서 네이티브 프리필 대비 10.74배 빨라졌다 (근거: §4.1, Tab.1, Tab.4).
핵심 아이디어
**이종 멀티 에이전트에서 텍스트 대신 KV 캐시를 직접 전달하자. 모델은 얼리고, 토큰·레이어·분포 불일치만 외부 어파인 맵으로 접어 넣자 ** (근거: §3, Fig.3).
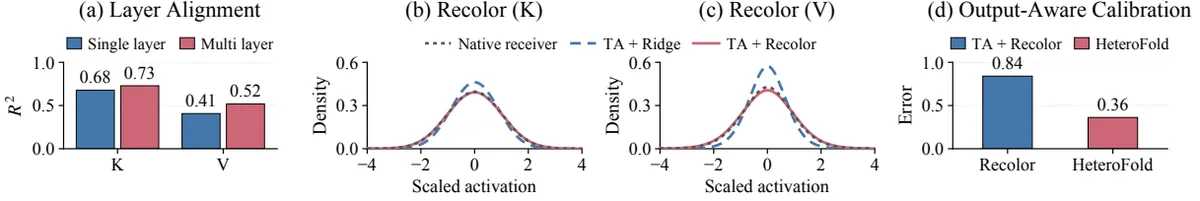
HeteroFold의 주장은 단순하다. 발신자(sender)가 이미 계산한 KV를 수신자(receiver) 공간으로 변환할 수 있다면, 수신자는 긴 공유 문맥을 다시 프리필할 필요가 없다. 핵심은 값을 비슷하게 만드는 것이 아니라 수신자의 어텐션과 출력이 네이티브와 같아지도록 보정하는 것이다 (근거: §1, Fig.2).
배경: 그들이 해결한 문제
연구의 공백
최근 멀티 에이전트 LLM은 역할별로 다른 계열 모델을 쓴다. 예를 들어 X-MAS는 solver, evaluator, aggregator에 서로 다른 패밀리를 배치한다 (근거: §1).
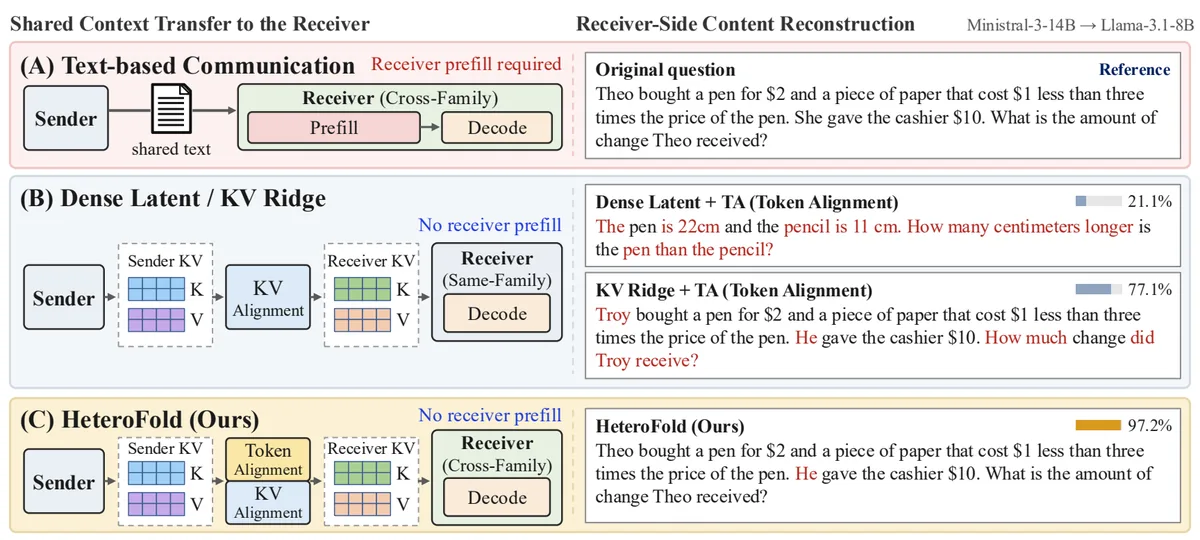
문제는 통신이다. 기존 텍스트 기반 통신(TextMas)은 수신자가 공유 텍스트를 다시 프리필하고 KV를 다시 만든다. 문맥이 길어질수록 이 중복 계산이 지연의 주범이 된다 (근거: §1).
당시 최신 기술 상태는 이렇게 갈라져 있었다 (근거: §2):
- 크로스 패밀리 통신은 있지만 프리필이 필요하다: TextMas는 손실이 없지만 수신자 프리필이 필수다. C2C는 수신자가 만든 프롬프트 캐시를 요구하므로 역시 프리필을 없애지 못한다. RECURSIVEMAS는 은닉 표현을 전달하지만 디코드 가능한 KV가 아니라 수신자 레이어를 다시 통과해야 한다.
- 프리필 프리는 있지만 동일 패밀리에만 된다: LATENTMAS는 캐시 호환성을 가정한다. Dense Latent와 KV Ridge는 발신자 캐시를 수신자 캐시로 매핑하고 프리필을 피하지만, 평가가 동일 토크나이저·유사 구조 안에서만 이뤄졌다.
즉, 토크나이저 불일치, 깊이 불일치, KV 표현 불일치를 동시에 처리하면서 수신자 프리필을 완전히 없앤 크로스 패밀리 방법은 없었다. 저자들은 이를 첫 번째로 명시적 크로스 토크나이저 정렬을 포함한 프리필 프리 전송으로 제시한다 (근거: §1-§2).
중심 가설
**저자들은 토큰을 공유 문자 경계로 정렬하고, 다층 발신자 특징을 리컬러링으로 수신자 통계에 맞춘 뒤, 수신자 어텐션·출력 기준으로 보정한 보정값을 고정 어파인 맵에 폴딩함으로써, 두 모델을 동결한 채로 크로스 패밀리 KV 재사용의 수신자 프리필을 제거하고 다운스트림 행위를 보존할 수 있다고 가정한다 ** (근거: §3).
독창적 기여 3가지
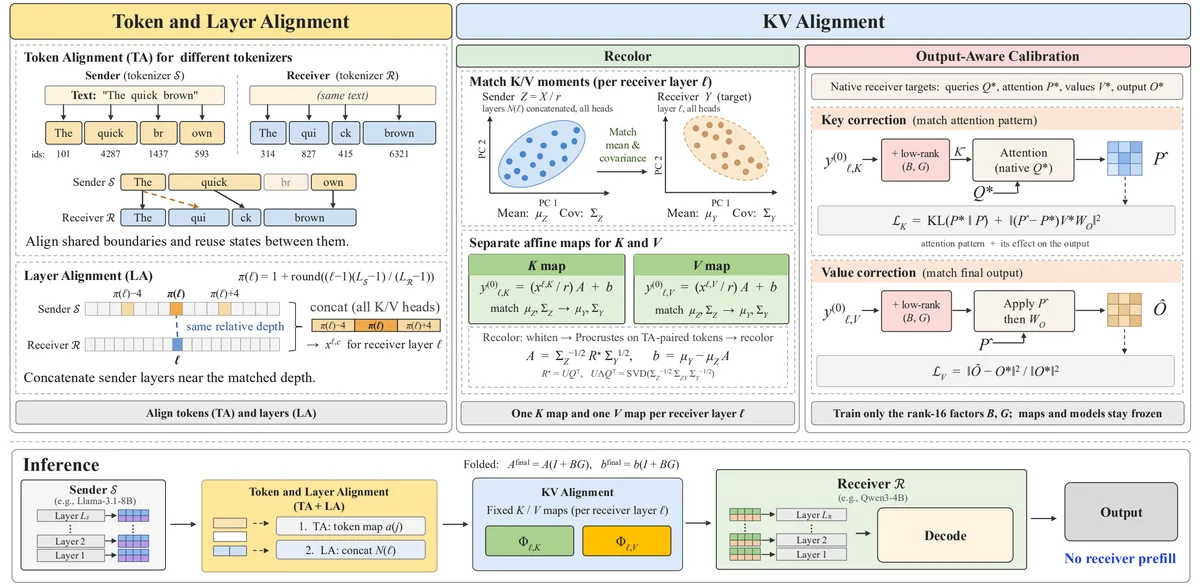
- 새로운 정렬 기법: Token Alignment(TA) : 서로 다른 토크나이저의 토큰을 같은 문자 끝 위치로 대응시키는 방법이다. 매칭되지 않는 수신자 위치는 가장 최근 공유 경계의 발신자 상태를 재사용하고, 평균화하지 않는다 (근거: §3.1, Appx.B.1). 새로운 전처리·대응 기법에 해당한다.
- 새로운 아키텍처 구성요소: 다층·크로스헤드 Recolor 매핑 : 비례 깊이로 매칭된 주변 3개 발신자 레이어를 이어붙이고, 헤드를 펼친 뒤 화이트닝–Procrustes–리컬러링으로 수신자 평균과 공분산을 맞춘다. K와 V에 대해 수신자 레이어마다 별도 어파인 맵을 만든다 (근거: §3.1-§3.2). 새로운 매핑 모듈에 해당한다.
- 새로운 학습 기법의 전용: 출력 인식 캘리브레이션과 폴딩 : KV 양자화용 출력 인식 보정을 크로스 패밀리 전송에 맞게 K/V 분리 목적으로 개조하고, rank 16 저랭크 보정 $B$, $G$ 만 학습한 뒤 $A_{final}=A(I+BG)$ 형태로 접어 추론 시 추가 모듈이 없게 한다 (근거: §3.3). 기존 방법론의 새로운 적용이자 새로운 학습 목적식에 해당한다.
저자 관점에서의 강점
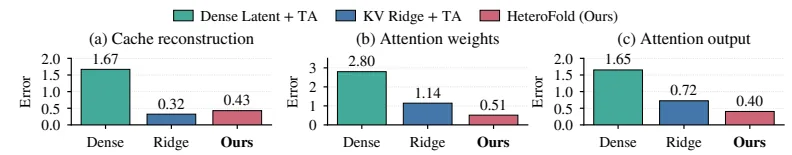
저자들이 내세우는 논리는 “재구성 오차가 낮다고 수신자가 잘 동작하지 않는다”이다. Qasper 평균에서 KV Ridge+TA는 캐시 재구성 오차 0.32 로 HeteroFold의 0.43 보다 낮지만, 어텐션 가중치 KL은 1.14 대 0.51, 어텐션 출력 오차는 0.72 대 0.40 으로 크게 진다 (근거: §1, Fig.2).
따라서 그들은 토큰 단위 $l_2$ 재구성이 아니라 분포 모멘트 매칭과 수신자 쿼리·어텐션·출력 매칭이 필요하다고 주장한다. 실제로 TA만 붙인 KV Ridge가 크게 오르지만(예: Qwen3-4B→Llama-3.1-8B HotpotQA F1 0.74 에서 34.04 로), HeteroFold는 38.48 로 더 앞선다. 이는 토큰 대응을 넘어선 K/V 매핑과 보정의 효과라는 해석이다 (근거: §4.1, Tab.1).
새로운 접근법: HeteroFold
표기부터 정리하자. $S$ 는 동결된 발신자, $R$ 은 동결된 수신자, $L_S$, $L_R$ 은 각 레이어 수, $C_S(x)$ 는 문맥 $x$ 에 대한 발신자 캐시, $\hat{C}_R(x)$ 는 변환된 수신자 호환 캐시다. $c \in \{K,V\}$ 는 키·밸류 역할, $d^{KV}$ 는 펼친 KV 특징 차원이다 (근거: §3).
HeteroFold는 K는 키 정규화와 RoPE 이전 지점에서, V는 투영 이후 지점에서 매핑한다. 수신자는 이후 네이티브 키 정규화와 RoPE를 한 번만 적용한다 (근거: §3, Appx.B.1).
단계는 네 개다.
1단계: Token Alignment(TA)
같은 원시 텍스트를 각자 토큰화하고, 비어 있지 않은 토큰의 문자 끝 오프셋 $e^S_i$, $e^R_j$ 를 기록한다. 같은 끝 위치를 공유하면 쌍으로 묶고, 공유점이 없으면 가장 최근 공유 경계의 발신자 상태를 앞으로 채운다. 처음 매칭 이전 구간은 첫 발신자 토큰을 쓴다 (근거: §3.1, Appx.B.1).
2단계: Layer Alignment(LA)
수신자 레이어 $l$ 에 대해 비례 깊이로 발신자 중심 레이어를 찾고 앞뒤 4 오프셋 이웃을 묶는다.
정렬된 토큰 쌍 $(i_n,j_n)$ 마다 발신자 3개 레이어 특징을 이어붙인다: $x^{l,c}_n=[c^{S,t_1}_{i_n} \| c^{S,t_2}_{i_n} \| c^{S,t_3}_{i_n}]$, 목표는 $y^{l,c}_n=c^{R,l}_{j_n}$ 이다. 헤드를 펼치므로 헤드 수가 달라도 크로스헤드 매핑이 된다 (근거: §3.1).
3단계: Recolor
캘리브레이션 프롬프트에서 모은 $X \in \mathbb{R}^{N \times \tilde{d}_S}$, $Y \in \mathbb{R}^{N \times d_R}$ 에 대해 스칼라 RMS $r$ 로 스케일을 맞추고 $Z=X/r$ 로 둔다. 가중 평균 $\mu_Z$, $\mu_Y$, 공분산 $\Sigma_Z$, $\Sigma_Y$, 교차공분산 $\Sigma_{ZY}$ 를 구한 뒤 화이트닝 후 Procrustes 회전 $R^{\star}=UQ^{\top}$ 를 구한다 (근거: §3.2).
이상적으로는 $\mu_Z A+b=\mu_Y$, $A^{\top}\Sigma_Z A=\Sigma_Y$ 를 만족한다. 수치 안정화로 실제로는 근사 매칭이다 (근거: §3.2).
4단계: 출력 인식 캘리브레이션과 폴딩
고정된 수신자 쿼리에 대해 네이티브와 변환된 어텐션 출력 차이를 키 유발 변화와 값 유발 변화로 나눈다.
K는 어텐션 패턴 KL과 출력 투영 후 오차를, V는 고정된 $\hat{P}$ 아래 최종 출력 정규 오차를 각각 최적화한다. rank $\rho_c=16$ 보정 $\hat{y}=y^{(0)}+(y^{(0)}B)G$ 에서 $B$, $G$ 만 4 에폭 학습하고 $G$ 는 0으로 초기화한다. 질문 스팬 쿼리 위치만 쓰고 정답이나 생성 궤적은 쓰지 않는다 (근거: §3.3, Appx.B.2).
추론 시에는 접는다.
$$ A^{final}=A(I+BG),\quad b^{final}=b(I+BG),\quad \Phi_{l,c}(x_j)=(x_j/r)A^{final}+b^{final} $$레이어·역할당 하나의 고정 어파인 맵만 남고 별도 보정 모듈이 없다 (근거: §3.3).
작동 원리: 구체적인 예시로 살펴보기
대학원생을 위한 토이 예시로 “The unbelievable result.”를 보자. 문자 위치를 세면 The=3, unbelievable=16, result=23, .=24 에서 끝난다 (근거: §3.1).
- Qwen3 토큰화:
The | unbelievable | result | .→ 끝 위치 3, 16, 23, 24 - Ministral-3 토큰화:
The | unbel | iev | able | result | .→ 끝 위치 3, 9, 12, 16, 23, 24
Qwen3→Ministral-3 방향에서 수신자 경계 9와 12는 공유 경계가 없으므로 가장 최근 공유 경계 3의 Qwen 상태를 재사용한다. 역방향에서는 문자 16에서 끝나는 Qwen 토큰이 같은 16에서 끝나는 Ministral 상태를 그대로 쓴다. 중간 unbel, iev 상태를 평균내지 않고 같은 인과 접두사 끝점을 맞추는 것이 포인트다 (근거: §3.1).
레이어 정렬도 숫자 예시가 있다. 발신자 $L_S=32$, 수신자 $L_R=28$ 이고 수신자 $l=14$ 라면 $\pi(14)=1+\text{round}(13 \times 31/27)\approx 16$ 이다. 이웃은 $(12,16,20)$ 이 되고, 세 레이어의 펼친 K 특징을 이어붙여 3배 차원의 입력 $x$ 를 만든다. 수신자 레이어 14의 K 목표 $y$ 에 Recolor로 맞추는 식이다 (근거: §3.1).
이 설계가 왜 필요한지는 동일 인덱스 페어링의 실패에서 드러난다. 같은 $i$ 번째 토큰끼리 묶으면 토크나이저가 달라서 서로 다른 문자 위치를 가리킨다. 48개 HotpotQA 문서 기준 평균 문자 위치 불일치는 문맥이 길어질수록 수백 문자까지 커지지만, TA는 0.003 문자–0.20 문자 수준에 머문다 (근거: §5.2, Fig.5).
비밀 병기: TA를 빼면 무슨 일이 생기나
Ministral-3-14B→Llama-3.1-8B 방향 애블레이션을 보자. 모든 변형이 동일 캘리브레이션 데이터를 쓴다 (근거: §4.3, Tab.3).
| 변형 | ARC-C 정확도 (%) | GSM8K 정확도 (%) | Qasper F1 | HotpotQA F1 | QuALITY 정확도 (%) |
|---|---|---|---|---|---|
| HeteroFold 전체 | 90.36 | 63.46 | 33.72 | 50.29 | 79.00 |
| 동일 인덱스 페어링 | 69.20 | 7.13 | 3.19 | 0.72 | 24.59 |
| 단일 레이어 매핑 | 82.00 | 46.17 | 22.34 | 37.87 | 71.52 |
| 헤드 로컬 매핑 | 71.84 | 26.69 | 9.71 | 17.38 | 54.79 |
| TA+Ridge | 87.03 | 4.55 | 3.27 | 6.82 | 47.41 |
| TA+Recolor (보정 없음) | 90.19 | 62.77 | 26.52 | 40.71 | 79.34 |
가장 큰 낙폭은 TA 제거다. HotpotQA F1이 50.29 에서 0.72 로 약 49.57%p 증발한다. 메커니즘은 명확하다. 토큰 대응이 어긋나면 이후 아무리 좋은 선형 맵을 써도 서로 다른 접두사를 학습하게 되기 때문이다. 헤드 로컬 매핑의 붕괴(Qasper 33.72→9.71)도 같은 맥락이다. 발신자와 수신자의 헤드 분할이 달라서 헤드 내 매핑만으로는 크로스헤드 정보를 못 가져온다 (근거: §4.3, Tab.3).
Ridge 대 Recolor 비교도 instructive하다. TA+Ridge는 GSM8K 4.55%, Qasper 3.27 로 무너진다. 출력 인식 보정을 더하면 55.57%, 21.65%까지 회복되지만 여전히 TA+Recolor+보정(63.46%, 33.72%)에 못 미친다. Ridge가 토큰별 $l_2$ 에 집착해 분포 꼬리와 어텐션 로짓 스케일을 틀어지게 하는 반면, Recolor는 수신자 평균·공분산을 먼저 맞춰 어텐션 입력 분포를 살리기 때문이다. 키 보정이 롱컨텍스트에서 더 큰 이득을 주는 것도 어텐션 패턴이 긴 문맥에서 지배적이라는 점과 일치한다 (근거: §4.3, Tab.3, Fig.4).
성능 검증: 주요 결과
실험 세팅 한눈에 보기
- 모델:
meta-llama/Llama-3.1-8B-Instruct,Qwen/Qwen3-4B,mistralai/Ministral-3-14B-Instruct-2512-BF16, 모두 동결 BF16, Qwen은 non-thinking 모드 (근거: Appx.A.1). - 토큰화: 같은 프롬프트를 각자 토크나이저로 처리하고 채팅 템플릿 토큰은 별도 처리 (근거: Appx.A.1).
- 캘리브레이션: 학습 1,600 개(Open-R1 800 개+HotpotQA 학습 분할 800 개), 홀드아웃 400 개, 정답·풀이 제외, 평가와 겹치지 않음. KV Ridge는 $k=8$, 릿지 0.01, Dense Latent는 2층 GELU 매핑+512 토큰 수신자 트레이스 2단계 학습을 재구현 (근거: §4, Appx.A.3, Appx.B.3).
- 평가: 롱컨텍스트 4종(Qasper 200 개, HotpotQA 200 개, LoCoMo 1,540 개, QuALITY 2,086 개)과 숏컨텍스트 5종(ARC-C 1,172 개, MMLU 14,042 개, WinoGrande 1,267 개, HellaSwag 10,042 개, GSM8K 1,319 개), HIDDENBENCH 65 태스크. Qasper·HotpotQA는 온도 0.6, top-p 0.95, top-k 20, LoCoMo·GSM8K는 탐욕 디코딩 (근거: Appx.A.1-A.2).
- 트랜스포머 구성: GQA 기반 KV 헤드 공유, 위치는 RoPE, 수신자 키 정규화 후 RoPE 적용, RoPE 연산은 FP32 (근거: §3.3, Appx.B.1).
핵심 결과 1: 6방향 크로스 패밀리 QA에서 롱컨텍스트 전부 1위
HeteroFold는 6개 방향 모두에서 4개 롱컨텍스트 벤치마크 최고 캐시 전송 성능을 찍는다. 수신자 프리필이 없다는 점을 감안하면 이례적이다 (근거: §4.1, Tab.1).
대표 숫자만 뽑으면 다음과 같다. 단위는 F1 또는 정확도(%)이다.
- Qwen3-4B→Llama-3.1-8B: Qasper 29.12, HotpotQA 38.48, LoCoMo 29.66, QuALITY 62.85% — 차선(KV Ridge+TA 16.06, 34.04, 13.56, 54.60%)을 전부 상회 (근거: Tab.1).
- Ministral-3-14B→Qwen3-4B: Qasper 42.00, HotpotQA 52.74, LoCoMo 35.59 로 텍스트 상한 43.07, 56.05, 38.92 에 근접 (근거: Tab.1).
- Llama-3.1-8B→Ministral-3-14B: Qasper 21.58 대 11.41, HotpotQA 39.00 대 13.33, GSM8K 72.33% 대 47.99% 로 KV Ridge+TA 대비 약 1.5–2.9배 (근거: Tab.1).
숏컨텍스트도 대부분 우위다. Ministral-3-14B→Llama-3.1-8B에서 ARC-C 90.36%, GSM8K 63.46%, QuALITY 79.00% 로 베이스라인을 앞선다 (근거: Tab.1).
핵심 결과 2: 멀티 에이전트 HIDDENBENCH에서 텍스트 통신과 대등
15라운드 통신 후 평균 정확도 30.6%, 다수결 정확도 29.2%, 무효율 3.2% 로 TextMas의 29.2%, 27.7%, 4.0% 와 대등하거나 약간 앞선다. Dense Latent+TA 18.5%, KV Ridge+TA 21.8% 와는 격차가 크고, KV Ridge+TA의 무효율 20.9% 와 대비된다 (근거: §4.2, Tab.2).
이 결과의 의미는 싱글홉 QA를 넘어 새로 생성된 메시지의 KV만 매핑해도 집단 의사결정이 유지된다는 점이다. Qwen→Qwen은 텍스트로 두고 나머지만 캐시 전송한 설정에서도 성립한다 (근거: Appx.A.2).
핵심 결과 3: 지연 시간
2×H100 80GB NVLink, FlashAttention-2, 배치 크기 2, 4K/16K/32K QuALITY 문맥 기준이다. 발신자 프리필·모델 로드·오프라인 핏은 제외하고 토큰화+TA, GPU간 페이로드 복사, K/V 맵+캐시 구축, 첫 토큰까지 수신자 처리를 합산한 중앙값이다 (근거: §5.1, Appx.E.1, Tab.4, Tab.I).
- Llama-3.1-8B→Ministral-3-14B 32,768 토큰: HeteroFold 481.3 ms, 네이티브 프리필 5167.4 ms → 10.74배 단축. KV Ridge+TA 569.9 ms 대비 1.18배, Dense Latent+TA 705.7 ms 대비 1.47배 빠르다.
- Qwen3-4B→Ministral-3-14B 32,768 토큰: 483.2 ms 대 5178.2 ms → 10.72배, 베이스라인 587.7 ms, 720.5 ms 대비 우위다.
- 4K에서는 3.47–3.75배, 16K에서는 7.24–8.11배로 문맥이 길수록 이득이 커진다 (근거: Tab.4).
이득의 주원천은 더 작은 K/V 맵+캐시 구축 단계다. HeteroFold는 단일 어파인 1단, 수신자 레이어당 발신자 3층을 쓰고, Dense Latent는 2층 MLP, KV Ridge는 8층을 쓴다 (근거: §5.1, Fig.C).
저자들이 성공 증거로 가장 강조하는 것은 롱컨텍스트 전부 1위와 10.7배 지연 단축, 그리고 HIDDENBENCH에서의 텍스트 대등 성능이다 (근거: §4.1-§4.2, §5.1).
비판적 비교: 어디서 이기고 어디서 삐끗하나
가장 강력한 비교점은 TA를 공유한 뒤의 K/V 설계 비교다. TA를 똑같이 준 Dense Latent+TA, KV Ridge+TA와 붙어도 HeteroFold가 QuALITY 기준 다음 토큰 KL, 정답 일치율, 어텐션 KL 모두에서 네이티브에 가장 가깝다 (근거: §5.2, Fig.6).
동일 패밀리(Qwen3 4B/8B/14B 4방향)에서도 롱컨텍스트 전부 1위를 유지해 토크나이저 정렬을 넘어선 일반성이 있음을 보인다. 동일 패밀리에서 KV Ridge가 숏컨텍스트 일부에서 경쟁력을 유지한다는 점은 베이스라인 재구현이 제 궤도에 있음을 방증한다 (근거: Appx.C, Tab.G).
반대로 못 이긴 지점도 있다. 수신자가 Ministral 또는 Qwen인 일부 숏컨텍스트에서 KV Ridge+TA에 진다. 예: Ministral-3-14B→Qwen3-4B WinoGrande 53.83% 대 54.78%, HellaSwag 41.46% 대 45.12%. Llama-3.1-8B→Qwen3-4B HellaSwag도 41.74% 대 44.54% 로 진다 (근거: Tab.1). 짧은 선택형에서 릿지의 토큰별 핏이 우연히 잘 맞거나, HeteroFold의 공분산 매칭이 짧은 분포에서는 과도할 수 있다는 해석이 가능하다. 또한 GSM8K 질문 복원 ordered overlap은 HeteroFold 83.04%, KV Ridge+TA 76.68%, Dense Latent+TA 39.74% 로 어휘 복원에서는 앞서지만 완전 일치 16/100 에 그쳐 어휘 수준 보존과 과제 정확도가 1:1이 아님을 보여준다 (근거: Appx.D.2, Tab.H).
우리의 관점: 강점, 한계, 그리고 이 연구가 중요한 이유
**강점은 문제를 쪼갠 방식이다 **. 토큰 대응(TA), 깊이 집계(LA+3층), 분포 정합(Recolor), 행위 정합(출력 인식 K/V 분리 목적식), 비용 제거(폴딩)로 각 층의 책임이 분명하다. 특히 키와 값을 어텐션 수식 분해에 맞춰 따로 보정한 점은 KV 양자화 문헌을 가져오되 전송 문제에 맞게 재설계한 대목이다 (근거: §3.3).
**시스템 관점에서도 설득력이 있다 **. 저장 맵 파라미터는 방향당 201M–252M 개, BF16 0.40GB–0.50GB 로 Dense Latent 대비 약 25%, KV Ridge 대비 약 62% 적다. 구축 비용은 방향당 약 2 H100 GPU-시간이다 (근거: Appx.B.4, Tab.F). 6방향 전부에서 지연·추가 피크 메모리 모두 KV Ridge+TA보다 낮다 (근거: Appx.E.3, Fig.D).
**한계도 분명하다 **. 저자들이 명시한 것은 아니지만 분석에서 드러난다.
- 맵이 크고 방향 종속적이다. 6방향이면 최대 약 1.5B 파라미터 분량 맵이 필요하고, 새 모델 쌍마다 1,600+400 프롬프트 캘리브레이션이 다시 필요하다 (근거: Appx.B.3-B.4).
- 전송 지연 비교는 발신자가 이미 문맥을 처리했다는 전제다. 그렇지 않다면 Llama 기준 280 ms, 1328 ms, 3381 ms(4K/16K/32K 2문맥 배치), Qwen 기준 235 ms, 1163 ms, 3083 ms 의 발신자 프리필+캡처를 더해야 한다 (근거: Appx.E.4).
- 캘리브레이션에 Open-R1과 HotpotQA를 섞어야 성능이 난다. 단일 코퍼스만 쓰면 ARC-C·HotpotQA·QuALITY 모두 떨어진다. 즉 분포 외 문맥에서는 재캘리브레이션이 필요할 수 있다 (근거: Appx.B.3, Tab.E).
- 랭크·층 수 민감도가 있다. rank 0(Recolor만)은 HotpotQA 30.47 로 떨어지고, 1층만 쓰면 22.52 로 붕괴한다. 3층과 5층은 비슷해 3층을 택했지만 모델 쌍이 바뀌면 최적 이웃이 달라질 수 있다 (근거: Appx.B.3, Tab.C-D).
- 일반화 한계로, 평가가 Llama/Qwen/Ministral 3종과 영어 QA·HIDDENBENCH에 집중돼 있다. 긴 디코딩 궤적에서의 안정성은 GSM8K 교사 강제 리플레이에서만 확인됐다 (근거: Appx.A.1, Appx.D.3).
그럼에도 이 연구가 중요한 이유는 이종 에이전트가 대세가 될수록 “긴 문맥을 누가 몇 번 읽는가”가 비용을 지배하기 때문이다. 텍스트 전달이 에이전트 수만큼 프리필을 반복한다면, 캐시 전달은 한 번 읽은 것을 공유한다. HeteroFold는 그 공유를 서로 다른 어휘와 깊이 사이에서도 가능하게 만든 첫 실용적 다리다 (근거: §6).
다음 단계는?: 앞으로의 길
저자들은 결론에서 이종 에이전트 간 효율적 캐시 공유와 더 일반적인 패밀리 간 KV 인터페이스로 나아가겠다고만 밝히고 구체적 후속을 열거하지 않는다 (근거: §6).
한계에 비추어 합리적 다음 단계는 다음과 같다.
- 방향 무관·경량 맵: 0.4GB–0.5GB 맵을 하이퍼네트워크나 저랭크 팩토리제이션으로 압축하고, 모델 쌍이 바뀌어도 재학습 없이 되는 범용 어댑터를 탐색할 필요가 있다 (근거: Appx.B.4).
- 온라인·점진 캘리브레이션: HIDDENBENCH처럼 메시지가 생성되는 환경에서는 사전 핏된 맵과 도착한 메시지 분포가 어긋날 수 있다. 수신자 출력 피드백으로 $B$, $G$ 를 가볍게 업데이트하는 온라인 보정이 자연스럽다 (근거: §4.2, Appx.A.2).
- 발신자 비용 포함 최적화: 실제론 발신자 프리필이 병목이 될 수 있으므로, 발신자-전송-수신자 전체 파이프라인의 종단 지연과 메모리(페이로드 복사 포함)를 함께 최적화해야 한다 (근거: Appx.E.3-E.4).
- 더 긴 생성·다국어·모달리티 확장: 프롬프트 쿼리 위치만으로 보정했으므로 수천 토큰 생성, 비영어 토크나이저, VLM 은닉 상태로의 확장이 검증 과제다 (근거: §3.3, Appx.D.3).
서로 다른 모델이 같은 글을 읽고도 서로에게 설명해주려면 매번 다시 읽어야 했던 시대에서, 이제는 읽은 흔적 자체를 건넬 수 있게 됐다. HeteroFold는 그 흔적을 번역하는 사전과 문법을 함께 내놓은 셈이다.
논문 원문의 표
arXiv e-print 의 LaTeX 원본에서 기계적으로 옮긴 표입니다. 숫자는 논문의 값이며 모델을 거치지 않았습니다.
표 1. Cross-family transfer results across six directions. Dense Latent and KV Ridge use same-index token pairing, while +TA replaces only token correspondence with our shared character-boundary alignment. TextMas uses lossless text communication with native receiver prefill. Higher is better. Bold indicates the best cache-transfer result within each direction and benchmark; TextMas is excluded from emphasis.
| Transfer direction | Method | Long Context QA Qasper | Long Context QA HotpotQA | Long Context QA LoCoMo | Long Context QA QuALITY | Short Context QA ARC-C | Short Context QA MMLU | Short Context QA WinoGrande | Short Context QA HellaSwag | Short Context QA GSM8K |
|---|---|---|---|---|---|---|---|---|---|---|
| (F1 $\uparrow$) | (F1 $\uparrow$) | (F1 $\uparrow$) | (Acc. $\uparrow$) | (Acc. $\uparrow$) | (Acc. $\uparrow$) | (Acc. $\uparrow$) | (Acc. $\uparrow$) | (Acc. $\uparrow$) | ||
| Qwen3-4B $\rightarrow$ Llama-3.1-8B | TextMas | 44.64 | 57.54 | 52.33 | 75.07 | 82.76 | 66.74 | 65.82 | 70.78 | 85.67 |
| Dense Latent | 2.83 | 0.60 | 0.65 | 23.15 | 24.74 | 24.11 | 50.28 | 48.67 | 0.91 | |
| Dense Latent + TA | 3.17 | 1.37 | 1.68 | 26.46 | 27.65 | 26.56 | 50.75 | 50.17 | 4.09 | |
| KV Ridge | 2.78 | 0.74 | 1.41 | 25.17 | 24.40 | 30.36 | 50.36 | 51.40 | 0.53 | |
| KV Ridge + TA | 16.06 | 34.04 | 13.56 | 54.60 | 76.79 | 61.42 | 52.49 | 59.57 | 43.21 | |
| HeteroFold (Ours) | 29.12 | 38.48 | 29.66 | 62.85 | 78.92 | 63.28 | 57.30 | 65.60 | 55.12 | |
| Ministral-3-14B $\rightarrow$ Qwen3-4B | TextMas | 43.07 | 56.05 | 38.92 | 70.61 | 87.80 | 67.95 | 55.09 | 41.54 | 90.14 |
| Dense Latent | 2.56 | 0.22 | 0.22 | 24.98 | 25.00 | 27.99 | 51.22 | 44.66 | 1.82 | |
| Dense Latent + TA | 3.66 | 1.32 | 0.43 | 25.89 | 26.37 | 31.46 | 49.57 | 44.34 | 15.16 | |
| KV Ridge | 2.77 | 1.45 | 1.73 | 25.41 | 42.15 | 44.27 | 50.99 | 37.45 | 7.05 | |
| KV Ridge + TA | 39.02 | 48.24 | 14.71 | 73.20 | 88.14 | 71.73 | 54.78 | 45.12 | 87.11 | |
| HeteroFold (Ours) | 42.00 | 52.74 | 35.59 | 75.55 | 88.99 | 72.14 | 53.83 | 41.46 | 89.23 | |
| Llama-3.1-8B $\rightarrow$ Qwen3-4B | TextMas | 43.07 | 56.05 | 38.92 | 70.61 | 87.80 | 67.95 | 55.09 | 41.54 | 90.14 |
| Dense Latent | 2.72 | 1.40 | 0.67 | 25.31 | 24.49 | 27.00 | 50.67 | 42.96 | 0.76 | |
| Dense Latent + TA | 4.35 | 1.39 | 0.58 | 25.50 | 25.00 | 27.24 | 51.62 | 43.53 | 6.52 | |
| KV Ridge | 2.88 | 0.94 | 1.00 | 26.94 | 26.62 | 31.09 | 50.43 | 36.93 | 1.59 | |
| KV Ridge + TA | 31.63 | 25.12 | 21.91 | 59.59 | 74.32 | 61.25 | 51.38 | 44.54 | 70.66 | |
| HeteroFold (Ours) | 35.99 | 49.44 | 34.83 | 62.90 | 77.05 | 62.39 | 52.88 | 41.74 | 70.74 | |
| Qwen3-4B $\rightarrow$ Ministral-3-14B | TextMas | 45.59 | 64.56 | 52.01 | 83.32 | 92.66 | 75.63 | 61.56 | 68.33 | 94.69 |
| Dense Latent | 3.19 | 1.66 | 1.23 | 26.51 | 36.26 | 32.07 | 50.04 | 50.62 | 3.87 | |
| Dense Latent + TA | 5.07 | 4.26 | 3.37 | 38.97 | 42.66 | 41.31 | 50.20 | 50.14 | 28.81 | |
| KV Ridge | 2.17 | 0.44 | 1.43 | 27.85 | 26.45 | 26.78 | 51.14 | 52.47 | 1.74 | |
| KV Ridge + TA | 7.75 | 17.09 | 9.33 | 62.94 | 84.13 | 63.41 | 53.12 | 61.74 | 60.20 | |
| HeteroFold (Ours) | 20.57 | 42.65 | 17.75 | 66.30 | 85.49 | 66.24 | 55.88 | 65.22 | 77.26 | |
| Ministral-3-14B $\rightarrow$ Llama-3.1-8B | TextMas | 44.64 | 57.54 | 52.33 | 75.07 | 82.76 | 66.74 | 65.82 | 70.78 | 85.67 |
| Dense Latent | 2.72 | 0.79 | 0.78 | 24.83 | 31.14 | 28.34 | 51.62 | 51.36 | 1.74 | |
| Dense Latent + TA | 3.47 | 3.26 | 2.02 | 28.76 | 29.35 | 35.36 | 52.09 | 50.86 | 9.86 | |
| KV Ridge | 2.67 | 0.54 | 0.26 | 23.54 | 26.45 | 25.62 | 51.62 | 51.61 | 1.67 | |
| KV Ridge + TA | 19.09 | 37.48 | 39.07 | 74.74 | 88.31 | 68.56 | 52.64 | 65.61 | 53.30 | |
| HeteroFold (Ours) | 33.72 | 50.29 | 43.15 | 79.00 | 90.36 | 71.76 | 63.22 | 69.16 | 63.46 | |
| Llama-3.1-8B $\rightarrow$ Ministral-3-14B | TextMas | 45.59 | 64.56 | 52.01 | 83.32 | 92.66 | 75.63 | 61.56 | 68.33 | 94.69 |
| Dense Latent | 3.13 | 1.33 | 1.02 | 25.79 | 33.19 | 28.00 | 49.88 | 49.90 | 1.44 | |
| Dense Latent + TA | 6.71 | 4.88 | 4.43 | 29.72 | 38.57 | 29.58 | 50.51 | 50.41 | 18.65 | |
| KV Ridge | 1.24 | 0.25 | 0.80 | 23.78 | 22.70 | 26.16 | 51.38 | 48.34 | 0.99 | |
| KV Ridge + TA | 11.41 | 13.33 | 15.41 | 55.66 | 75.09 | 57.53 | 54.93 | 47.08 | 47.99 | |
| HeteroFold (Ours) | 21.58 | 39.00 | 30.43 | 72.05 | 81.14 | 65.92 | 57.14 | 66.41 | 72.33 |
표 2. Group decisions on HiddenBench. Initial accuracy precedes communication; the remaining metrics are measured after 15 rounds.
| Communication | tabular[c]@r@Init. |
|---|---|
| Acc. (%) |
표 3. Component ablation for Ministral-3-14B$\rightarrow$Llama-3.1-8B. ARC-C, GSM8K and QuALITY report accuracy; Qasper, HotpotQA and LoCoMo report F1. The first three rows replace token alignment, depth aggregation, and cross-head mixing, respectively. All variants use the same calibration data as the main results; Calibration refers to our output-aware calibration.
| Map | ARC-C | GSM8K | Qasper | HotpotQA | LoCoMo | QuALITY |
|---|---|---|---|---|---|---|
| Same-index token pairing | 69.20 | 7.13 | 3.19 | 0.72 | 1.47 | 24.59 |
| Single-layer mapping | 82.00 | 46.17 | 22.34 | 37.87 | 30.45 | 71.52 |
| Head-local mapping | 71.84 | 26.69 | 9.71 | 17.38 | 12.75 | 54.79 |
| TA + Ridge ($\ell_2$-regularized least squares) | 87.03 | 4.55 | 3.27 | 6.82 | 2.13 | 47.41 |
| + key + value calibration | 89.16 | 55.57 | 21.65 | 31.66 | 31.91 | 74.50 |
| TA + Recolor | 90.19 | 62.77 | 26.52 | 40.71 | 40.81 | 79.34 |
| + key calibration | 90.19 | 62.35 | 34.99 | 48.71 | 42.85 | 78.41 |
| + value calibration | 90.53 | 62.02 | 25.91 | 44.50 | 40.57 | 77.95 |
| + key + value calibration (HeteroFold) | 90.36 | 63.46 | 33.72 | 50.29 | 43.15 | 79.00 |
표 4. Transfer latency (in ms, $\downarrow$) and speedup over Native Prefill ($\times$, $\uparrow$) at batch size 2. All methods use FlashAttention-2. Latency sums synchronized stage timings across two NVIDIA H100 80GB GPUs connected by NVLink, including inter-GPU payload transfer for cache-transfer methods. Native Prefill processes the original text on the receiver. Parentheses report speedup over Native Prefill. Median of three runs after warm-up.
| Method | Llama-3.1-8B $\rightarrow$ Ministral-3-14B 4,096 tokens | Llama-3.1-8B $\rightarrow$ Ministral-3-14B 16,384 tokens | Llama-3.1-8B $\rightarrow$ Ministral-3-14B 32,768 tokens | Qwen3-4B $\rightarrow$ Ministral-3-14B 4,096 tokens | Qwen3-4B $\rightarrow$ Ministral-3-14B 16,384 tokens | Qwen3-4B $\rightarrow$ Ministral-3-14B 32,768 tokens |
|---|---|---|---|---|---|---|
| Native Prefill | 443.1 (1.00$\times$) | 2091.2 (1.00$\times$) | 5167.4 (1.00$\times$) | 445.1 (1.00$\times$) | 2099.6 (1.00$\times$) | 5178.2 (1.00$\times$) |
| Dense Latent + TA | 155.4 (2.85$\times$) | 372.1 (5.62$\times$) | 705.7 (7.32$\times$) | 168.9 (2.64$\times$) | 389.3 (5.39$\times$) | 720.5 (7.19$\times$) |
| KV Ridge + TA | 135.6 (3.27$\times$) | 301.0 (6.95$\times$) | 569.9 (9.07$\times$) | 140.4 (3.17$\times$) | 316.5 (6.63$\times$) | 587.7 (8.81$\times$) |
| HeteroFold (Ours) | 118.3 (3.75$\times$) | 257.8 (8.11$\times$) | 481.3 (10.74$\times$) | 128.4 (3.47$\times$) | 290.1 (7.24$\times$) | 483.2 (10.72$\times$) |
표 5. Evaluation sets and metrics. Qasper and HotpotQA use LongBench subsets. LoCoMo excludes unanswerable category 5.
| Suite | Dataset | Examples | Metric |
|---|---|---|---|
| Short context | ARC-Challenge | 1,172 | Accuracy |
| MMLU | 14,042 | Accuracy | |
| WinoGrande | 1,267 | Accuracy | |
| HellaSwag | 10,042 | Accuracy | |
| GSM8K | 1,319 | Accuracy | |
| Long context | Qasper (LongBench) | 200 | Token F1 |
| HotpotQA (LongBench) | 200 | Token F1 | |
| LoCoMo, categories 1–4 | 1,540 | Token F1 | |
| QuALITY, development | 2,086 | Accuracy | |
| Multi-agent | HiddenBench | 65 | Accuracy / invalid rate |
표 6. Sensitivity to calibration-set size with an equal Open-R1/HotpotQA mixture, correction rank 16, and three sender layers.
| Training / held-out prompts | ARC-C | HotpotQA | QuALITY |
|---|---|---|---|
| 200 / 50 | 72.87 | 26.40 | 61.55 |
| 800 / 200 | 75.68 | 41.97 | 63.57 |
| 1,600 / 400 (paper) | 77.05 | 49.44 | 62.90 |
표 7. Sensitivity to correction rank with 1,600 training and 400 held-out prompts from the equal Open-R1/HotpotQA mixture and three sender layers. Rank 0 uses Recolor without output-aware calibration.
| Correction rank $\rho_c$ | ARC-C | HotpotQA | QuALITY |
|---|---|---|---|
| 0 (Recolor only) | 75.43 | 30.47 | 65.10 |
| 4 | 75.77 | 47.60 | 63.09 |
| 8 | 75.51 | 46.78 | 63.37 |
| 16 (paper) | 77.05 | 49.44 | 62.90 |
| 32 | 76.71 | 44.45 | 64.57 |
| 64 | 76.11 | 43.09 | 64.05 |
표 8. Sensitivity to the sender-layer neighborhood with 1,600 training and 400 held-out prompts from the equal Open-R1/HotpotQA mixture and correction rank 16.
| Sender-layer neighborhood | ARC-C | HotpotQA | QuALITY |
|---|---|---|---|
| 1 layer | 66.89 | 22.52 | 51.58 |
| 3 layers (paper) | 77.05 | 49.44 | 62.90 |
| 5 layers | 76.96 | 48.44 | 64.43 |
이 글의 그림은 arXiv:2609.32259 원본에서 가져왔습니다 (CC BY 4.0). 크기와 형식만 바꿨습니다.
댓글