전력 예산 안에서 몇 개의 Prefill, 몇 개의 Decode를 둘 것인가: PD 분리 추론의 용량-전력 파레토 프론트
한 줄 요약 (TL;DR)
이 논문은 Prefill-Decode 분리 추론에서 프로비저닝 $(n_P, n_D)$ 가 서빙 용량 $\mu$ (req/s) 와 평균 전력 $P$ (W) 를 어떻게 결정하는지를 해석식으로 풀고, 후보 배치들의 용량-전력 파레토 프론트에서 최소 전력 배치를 고르는 방법을 보인다 (근거: §2.2, §2.3) . 핵심은 decode측 KV-cache가 활성 decode 요청과 prefill 대기·실행 중 요청의 예약(reservation)이 공유한다는 결합(coupling)을 메모리 수지로 모델링한 점이다 (근거: §3.1.3, Fig. 2) . Qwen3-32B (32.8B params) 를 H200 GPU (peak 989 TFLOP/s, 4.8 TB/s) 에서 SGLang 0.5.9로 서빙한 실험에서 용량 오차 1.2% (고정 길이, 4096 input tokens / 256 output tokens) , 3.0% (Mooncake trace) , 1.6% (Azure trace) 와 전력 오차 2.3% , 2.7% , 2.6% 를 달성했다 (근거: §5.2, Tab. 2, Tab. 3) .
핵심 아이디어
제안 기법은 두 개의 해석 모델을 결합한 전력-인지 프로비저닝 프레임워크 이다 (근거: §3) .
- 서빙 용량 모델: prefill은 연산(compute-bound) 루프라인, decode는 메모리 대역폭(memory-bandwidth-bound) 루프라인으로 모델링하고, 전체 용량을 $\mu = \min(n_P \mu_P, n_D \mu_D)$ 로 둔다 (근거: §3.1, Tab. 1) .
- 부하-의존 전력 모델: 인스턴스 전력을 정규화 처리량 $\tilde{\lambda}$ 의 capped-ramp 함수 $p_s(\tilde{\lambda}_s)=\min(p_{0,s}+\gamma_s \tilde{\lambda}_s, p_{\text{sat},s})$ 로 모델링한다 (근거: §3.2) .
- 이산 파레토 프론트: 모든 후보 $(n_P, n_D)$ 를 용량-전력 평면에 찍고, 같은 용량을 더 낮은 전력으로 제공하는 배치가 없는 집합을 선택 기준으로 삼는다 (근거: §2.3, Fig. 1) .
중심 가설을 한 문장으로 정리하면 다음과 같다.
저자들은 prefill 연산 루프라인과 KV-cache 예약 결합을 포함한 decode 대역폭 루프라인 및 정규화 처리량 기반 capped-ramp 전력식을 사용함으로써 반복 프로파일링 없이 PD 분리 추론의 용량-전력 파레토 프론트를 해석적으로 복원하는 최소 전력 프로비저닝을 달성할 수 있다고 가정한다 (근거: §1, §3, §4) .
배경: 그들이 해결한 문제
연구의 공백
데이터센터 전력망 연결 지연과 조건부 상호연결이 현실적 제약이 되면서, 요구 용량을 최소 전력으로 제공하는 효율성과 전력 삭감 시 유지 가능한 용량을 아는 유연성이 모두 중요해졌다 (근거: §1) . LLM 추론은 요청량과 요청 길이가 함께 커지는 지속 부하가 되었고, prefill은 연산 집약, decode는 메모리 대역폭 집약이라는 상이한 병목 때문에 두 풀을 독립 프로비저닝하는 PD 분리가 널리 쓰인다 (근거: §1) .
출판 시점의 최신 기술은 이렇게 요약된다 (근거: §1.1) .
- 프로비저닝 평가: Splitwise, DistServe, BestServe류 시뮬레이션과 처리량 실측이 주류였고, 하드웨어 프로파일링은 시간이 오래 걸리고 분포가 바뀌면 반복해야 했다 (근거: §1.1) .
- 해석 모델: DistServe와 BestServe는 배치 실행 시간식은 해석적이지만 지연 SLO를 만족하는 요청률은 여전히 시뮬레이션에 의존했고, 큐잉 기반 방법은 prefill은 해석식, decode는 실측에 의존했다 (근거: §1.1) .
- 전력 모델: Splitwise는 전력을 인스턴스 수에 비례한다고 가정해 부하 의존성을 빠뜨렸고, 배치-전력이나 커널-전력, 토큰당 에너지 연구는 PD 배치 전체의 집합 전력을 설명하지 못했다 (근거: §1.1) .
결정적 한계는 prefill 예약이 decode KV-cache 풀을 잠식하는 결합을 해석적으로 다루지 못해 배치 단위 용량을 특정할 수 없었고, 결과적으로 용량-전력 트레이드오프 자체를 그릴 수 없었다는 점이다 (근거: §1, §3.1.3) .
독창성 식별
가장 중요한 기여 3가지는 다음과 같다 (근거: §1) .
- 새로운 이론적 통찰 + 해석 용량 모델: 입력-출력 길이 결합 분포와 연산·메모리 한계로부터 prefill 용량과 decode 용량을 유도하고, prefill 점유·decode 점유·미사용 조각의 메모리 수지식으로 동작 배치 $B$ 를 유일 해로 풀었다 (근거: §3.1, §4.2, Thm. 4.3) .
- 새로운 부하-의존 전력 모델: prefill과 decode를 분리한 capped linear ramp로 두고, 배치 비교는 용량점 $\lambda=\mu$ 에서 평가해 $(n_P, n_D)$ 와 워크로드만으로 배치 전력을 계산했다 (근거: §3.2, Fig. 3) .
- 기존 방법론의 새로운 적용: 이산 용량-전력 파레토 프론트: 2차원 정수 최적화 (1) 을 파레토 프론트 위 탐색으로 환원하고 $\epsilon=3$% $\epsilon$-Pareto로 실측과 모델 선택 일치를 평가했다 (근거: §2.3, Appx. C) .
저자 관점에서의 강점
저자들은 경험적 평가 의존을 줄이는 점을 강점으로 내세운다 (근거: §1, §5.2) . 고정 길이로만 캘리브레이션한 파라미터를 그대로 두고 길이 모멘트만 바꿔 Mooncake와 Azure 가변 길이 워크로드에 일반화했다는 것이 핵심 논거이다 (근거: §5.2) . 또한 잔여 문맥(residence correction)으로 $Var(\ell_{out})$ 와 $Cov(\ell_{in},\ell_{out})$ 를 명시해 긴 출력이 활성 배치 평균을 왜곡하는 효과를 보정했고, Kingman 근사로 prefill 대기 $t_W$ 를 반영해 큐잉 영향을 포함했다고 설명한다 (근거: §4.1, §4.2) .
새로운 접근법: Analytical Power-Aware Provisioning
전체 절차는 ComputeServingCapacity 알고리즘 하나로 요약된다 (근거: Alg. 1, Appx. C) .
- Prefill 용량: 요청 $r$ 의 FLOP 수요를 $F_r = 2N\ell_{in,r} + c_a L d \, \ell_{in,r}^2$ 로 두고, 달성 연산율 $\pi \times \text{MFU}$ 로 나눠 $t_{P,r}=a_P \ell_{in,r}+b_P \ell_{in,r}^2$ 를 얻는다 (근거: §3.1.1) . 평균의 역수가 인스턴스 용량이다.
여기서 $N$ 은 파라미터 수 (32.8B params) , $L$ 은 64 layers, $d$ 는 8192 width, $\pi$ 는 989 TFLOP/s, MFU는 0.67 이다 (근거: Tab. 3, Appx. B.1) .
Decode 반복 시간: 동작 배치 $B$ (iterations 평균 활성 요청 수) 와 활성 평균 문맥 $\bar{\ell}_{ctx}$ 에 대해 평균 메모리 트래픽을 $\bar{Q}=2N+\kappa B \bar{\ell}_{ctx}$ (bytes) 로 두고 $\bar{t}_D=\bar{Q}/(\beta \times \text{MBU})$ 로 나눈다 (근거: §3.1.2) . $\beta$ 는 4.8 TB/s, MBU는 0.77, $\kappa=4Lh_{kv}d_{head}$ (bytes/token) 이다 (근거: Appx. B.1, Tab. 3) . 캘리브레이션 오버헤드 $t_{iter}=1.00$ ms 와 $t_{req}=0.062$ ms 가 절편과 기울기에 더해진다 (근거: Appx. B.2) .
활성 문맥 보정: 도착 평균에 잔여 보정을 더한다 (근거: Lem. 4.1) .
- 메모리 수지와 동작 배치: 디코더 토큰 용량 $C_{tok}$ (tokens) 를 prefill 예약 점유 + 활성 decode 점유 $B(\bar{\ell}_{ctx}+R)$ + 미사용 조각으로 채운다 (근거: §3.1.3) . $R$ 은 출력용 예약 슬롯 수 (tokens) 이다.
$\bar{t}_W$ 는 Kingman 근사로 구하고 $B$ 에 대한 3차식의 유일근을 구간 $(0, \min(B^{max}, B^{\rho}))$ 에서 수치적으로 푼다 (근거: §4.2, Thm. 4.3) .
- 배치 용량과 전력: $1/\mu_D = E_r[\ell_{out}-1]\bar{t}_D / B$ 로 decode 용량을 얻고 $\mu=\min(n_P\mu_P,n_D\mu_D)$ 로 합친다 (근거: §3.1.2) . 전력은 균등 분할 가정 하에 $P=n_P p_P(\lambda/n_P\mu_P)+n_D p_D(\lambda/n_D\mu_D^{max})$ 로 계산하고 비교 시 $\lambda=\mu$ 로 둔다 (근거: §3.2) . $p_{0}$ 는 133 W (prefill) / 448 W (decode) , $\gamma$ 는 566 W / 458 W, $p_{sat}$ 는 692 W / 678 W 이다 (근거: Tab. 3) .
구현과 자원은 시스템 논문 관점에서 다음과 같다 (근거: §5.1, Appx. B) .
- 소프트웨어: SGLang 0.5.9, KV-cache 전송 백엔드 Mooncake, 라운드로빈 디스패치이다 (근거: §5.1) .
- 하드웨어: H200 GPU당 1 인스턴스, 평가 배치는 2 instances 부터 8 instances 까지이다 (근거: §5.1, §5.2) .
- 측정 지표: 서빙 용량 (req/s) , 총 GPU 전력 (W) , TTFT (s) , TPOT (ms/token) 이다 (근거: §5.2, §5.3) .
- 연산 비용 상세: 학습 FLOPs가 아니라 해석식 평가 + Brent 루트 탐색 1회로 배치당 용량을 계산하므로 시뮬레이션 반복 대비 점근 비용이 낮다 (근거: Appx. C) .
작동 원리: 구체적인 예시로 살펴보기
대학원생을 위한 토이 예시로 입력 길이 분포가 $\{2, 4\}$ tokens 를 균등하게 갖고 출력이 항상 3 tokens 인 경우를 보자. $N$ , $L$ , $d$ 는 상수이고 캘리브레이션된 $a_P$ , $b_P$ 를 안다고 가정한다 (근거: §3.1.1) .
- Step 1 — Prefill: $E[\ell_{in}]=3.0$ tokens, $E[\ell_{in}^2]=10.0$ tokens$^2$ 이므로 $1/\mu_P = 3a_P+10b_P$ (s/req) 이다. 2차 모멘트가 들어가 분산이 크면 같은 평균でも 용량이 떨어진다 (근거: §3.1.1) .
- Step 2 — 활성 문맥: $Var(\ell_{out})=0$ tokens$^2$ , $Cov=0$ tokens$^2$ 이므로 $\bar{\ell}_{ctx}=E[\ell_{in}]+E[\ell_{out}]/2=4.5$ tokens 이다. 출력이 모두 같으면 잔여 보정이 0 tokens 이다 (근거: Lem. 4.1) .
- Step 3 — 메모리 수지: $C_{tok}=10$ tokens, $R=1$ tokens 라 두자. prefill 예약을 무시하면 $B^{max}\approx(10-{\rm unused})/5.5\approx1.5$ reqs 이다. prefill 대기가 길어지면 첫 항이 커져 $B$ 는 1.5 reqs 보다 작아진다 (근거: §3.1.3) .
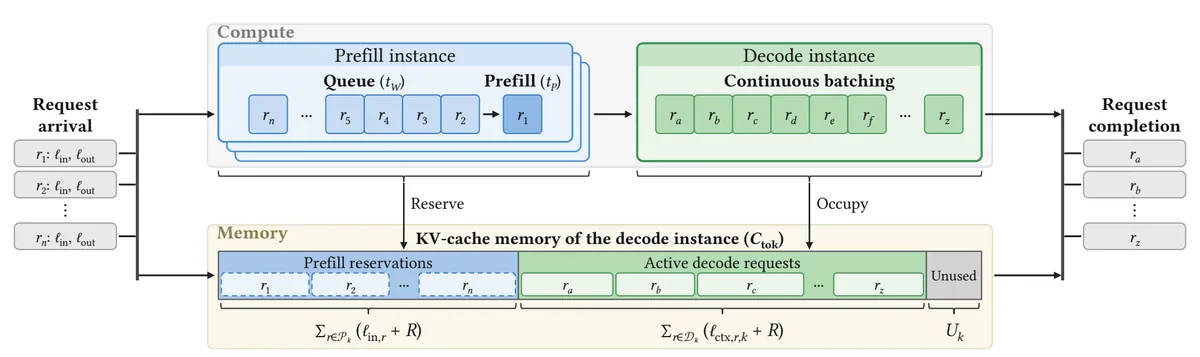
위 그림은 decode 인스턴스의 KV-cache 풀이 prefill 예약 $\sum(\ell_{in}+R)$ (tokens) , 활성 요청 $\sum(\ell_{ctx}+R)$ (tokens) , 미사용 $U_k$ (tokens) 로 나뉘는 모습을 보여준다 (근거: Fig. 2) . 요청 $r_1$ 이 prefill을 도는 동안 이미 decode 풀에 자리를 예약하므로, prefill이 밀리면 decode가 쓸 수 있는 자리가 줄어드는 결합이 생긴다 (근거: §3.1.3) .
비밀 병기: KV-cache 예약 결합을 빼면 무엇이 깨지는가
핵심 구성요소인 prefill 점유 항을 0 tokens 으로 두는 제거 실험은 논문에 직접 표가 없으므로 메커니즘과 보고된 수치로부터 정성 효과를 정리한다 (근거: §3.1.3, §5.2) .
| 변형 | $B$ (reqs) | $\mu_D$ (req/s) | $P$ (W) | 메커니즘 |
|---|---|---|---|---|
| 전체 모델 | $B < B^{max}$ | 실측 대비 1.2% ~ 3.0% 오차 | 실측 대비 2.3% ~ 2.7% 오차 | prefill 대기와 예약이 풀을 잠식해 반복 시간이 늘어난다 (근거: §5.2) |
| prefill 점유 제거 ($B^{max}$ 사용) | 과대 추정 | 과대 추정, 특히 Mooncake (평균 8307 input tokens) 에서 편향 증가 | decode가 포화 전력 678 W 에 더 자주 닿아 과대 추정 | 긴 입력이 예약을 오래 들고 있어 무시가 치명적이다 (근거: Tab. 2, Tab. 3) |
| 잔여 보정 제거 | 과소/과대 추정 | $Var(\ell_{out})$ 가 큰 trace에서 오차 증가 | 간접적으로 전력 기준점 $\mu_D^{max}$ 이동 | 긴 출력이 배치 평균에 더 자주 샘플링되기 때문이다 (근거: Lem. 4.1) |
| Kingman 대기 제거 ($\bar{t}_W=0$ s) | 과대 추정 | prefill 병목 근처에서 용량 과대 추정 | 저부하 전력은 비슷, 고부하 분기점 이동 | $\rho_P=n_D\mu_D/n_P\mu_P$ 가 1에 가까워지면 대기가 발산한다 (근거: §4.2) |
특히 decode 전력 ramp가 정규화 처리량 0.50 에서 포화하므로 용량 오차가 전력에 절반만 전달되는 비대칭이 생긴다 (근거: Appx. B.3) . prefill ramp는 0.99 에서 포화해 거의 선형으로 따라간다 (근거: Appx. B.3) .
성능 검증: 주요 결과
핵심 지표는 서빙 용량 (req/s) 과 총 GPU 전력 (W) 의 평균 절대 백분율 오차, 파레토 프론트 일치율, 그리고 재구성 시 TTFT (s) 와 TPOT (ms/token) 이다 (근거: §5.2, §5.3) . 벤치마크는 별도 공개 벤치가 아니라 고정 길이 5종 (1024 tokens ~ 8192 input tokens, 256 output tokens) 과 Mooncake 1000 reqs, Azure 7200 reqs 샘플이다 (근거: Tab. 2, §5.1) .
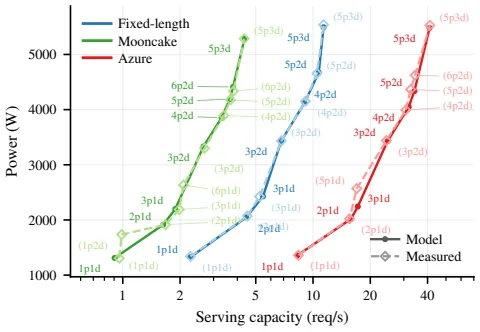
위 그림은 고정 길이, Mooncake, Azure 세 워크로드의 모델 프론트(실선)와 실측 프론트(파선)가 가깝게 따라가는 모습을 보여준다 (근거: Fig. 4) . 같은 전력에서는 Azure, 고정 길이, Mooncake 순으로 용량이 높고, 이는 평균 입력 1158 tokens, 4096 tokens, 8307 tokens 순과 일치한다 (근거: §5.2, Tab. 2) .
저자들이 성공 증거로 가장 강조하는 결과는 다음과 같다 (근거: §5.2) .
- 용량 일반화: 고정 길이 4096 input tokens 에서 1.2% , Mooncake에서 3.0% , Azure에서 1.6% 오차로 캘리브레이션 분포 밖으로 일반화된다 (근거: §5.2) .
- 전력 일반화: 동일 파라미터로 2.3% , 2.7% , 2.6% 오차를 유지한다 (근거: §5.2) .
- 배치 선택 일치: 400개 로그 간격 요구 용량에 대해 모델과 실측의 최소 전력 feasible 배치 선택이 90% , 85% , 86% 일치하고, 불일치는 모두 실측 용량 4% 이내 경계에서 발생한다 (근거: §5.2, Appx. C) .
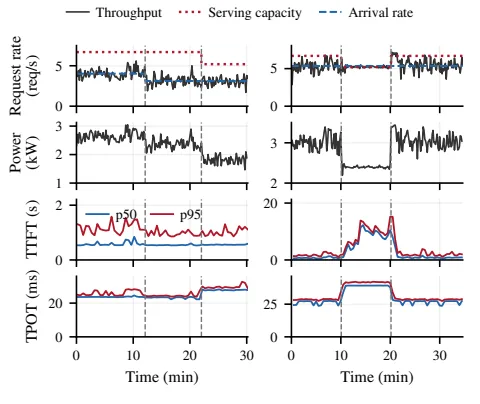
위 그림의 왼쪽 시나리오는 요청률이 3.1 req/s 로 떨어진 뒤 3p2d에서 3p1d로 줄인 경우이다 (근거: Fig. 5, §5.3.1) . 부하 하락만으로 270 W 감소하고, 인스턴스 제거로 560 W 가 추가 감소하며 중앙값 TTFT는 0.55 s 유지, 중앙값 TPOT는 23 ms 에서 28 ms 로만 오른다 (근거: §5.3.1) . 오른쪽 시나리오는 요청률 5.3 req/s 고정에서 10 min간 decode를 뺐다가 복구한 경우로, 620 W 절감 대신 용량이 5.2 req/s 로 떨어져 중앙값 TTFT가 0.7 s 에서 8.5 s 로, TPOT는 27 ms 에서 39 ms 로 오르고 복구 후 1.3 min 만에 해소된다 (근거: §5.3.2) .
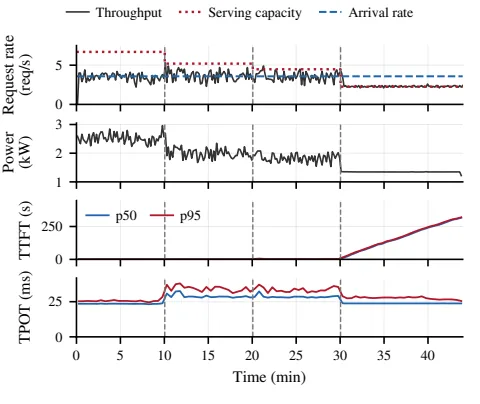
위 그림은 3.6 req/s 고정에서 3p2d에서 3p1d, 2p1d, 1p1d로 순차 축소한 확장 실험이다 (근거: Appx. D, Fig. 6) . 첫 제거는 520 W 절감에 TTFT 변화 없고 TPOT만 24 ms 에서 29 ms 로 오르고, 두 번째 제거는 180 W 절감에 TTFT 중앙값이 0.5 s 에서 0.9 s 로 오른다 (근거: Appx. D) . 마지막 1p1d는 용량 2.3 req/s 로 요청률을 밑돌아 TTFT가 최대 320 s 까지 발산하고 470 W 절감은 지속 불가능한 overload 대가로 바뀐다 (근거: Appx. D) .
비판적 비교
베이스라인은 시뮬레이션 기반 비교와 실측 프로파일링 자체이며, 별도 SOTA 점수표는 없다 (근거: §1.1, §5.2) . 가장 강력한 비교 지점은 파레토 프론트 위 최소 전력 배치 선택이 실측 선택과 85% ~ 90% 일치한다는 점이다 (근거: §5.2) . 반대로 개선이 미미하거나 못 미치는 지점은 경계 요구 용량 4% 이내 구간으로, 모델 오차가 배치 뒤바뀜으로 증폭되는 구간이다 (근거: §5.2) . 또한 Mooncake처럼 입력이 길고 분산이 큰 경우 용량 오차 3.0% 로 가장 크고, decode 전력 RMSE 49 W 가 prefill RMSE 19 W 보다 커서 decode가 많은 배치에서 전력 불확실성이 크다 (근거: §5.2, Appx. B.3) .
우리의 관점: 강점, 한계, 그리고 이 연구가 중요한 이유
강점 은 물리 기반 해석식과 큐잉 이론을 결합해 분포가 바뀌어도 길이 모멘트만 갈아끼우면 되는 점이다 (근거: §3, §4) . 특히 $B$ 의 존재·유일성 정리와 brentq 수치해가 구현을 단순하게 만든다 (근거: Thm. 4.3, Appx. C) . 전력식을 용량점 평가로 닫은 선택도 실용적이다 (근거: §3.2) .
언급된 한계 는 저자들이 비교적 솔직하게 적었다 (근거: Appx. B.3, §2.2) .
- KV-cache 전송은 prefill 연산과 겹쳐 병목이 아니라고 가정한다 (근거: §3.1) .
- 순간 전력이 아니라 장기 평균 전력만 모델링하고 피크 전력은 범위 밖이다 (근거: §2.2) .
- $t_{iter}$ 와 $t_{req}$ 는 특정 메커니즘과 일대일 대응하지 않는 경험 보정이다 (근거: Appx. B.2) .
- $c_a=2.17$ 은 인과 마스크 타일 경계와 softmax 등의 유효 계수이지 이론값 2.0의 정확한 카운트가 아니다 (근거: Appx. B.3) .
- 제거된 인스턴스의 유휴 120 W 는 보고 총전력에서 제외한다 (근거: Appx. B.3) .
잠재적 한계 로는 Poisson 도착과 라운드로빈 균등 분할, FCFS 독립 길이, 반복 기간과 prefill 점유 간 약상관 같은 강한 가정이 있다 (근거: §2.1, §4.2, Lem. 4.2) . 하드웨어·모델·서빙 스택이 바뀌면 MFU, MBU, 전력 ramp를 다시 맞춰야 해 이식 비용이 남고, SLO를 직접 제약에 넣지 않고 $\bar{\rho}$ 헤드룸으로 우회한 점도 엄밀한 지연 보장에는 간극이다 (근거: §2.2, Appx. B) . 사회적 영향 측면에서는 효율화로 총수요가 되레 느는 반등과, 일시적 용량 삭감이 큐 폭증으로 사용자 지연을 전가할 위험을 운영 정책과 함께 봐야 한다 (근거: §5.3, Appx. D) .
그럼에도 이 연구가 중요한 이유는 그리드-응답형 추론에 필요한 두 질문, 즉 요구 용량의 최소 전력과 전력 예산의 최대 용량을 하나의 그림에서 답하기 때문이다 (근거: §2.3, Fig. 1) . 반복 시뮬레이션 없이 분포 변화에追従할 수 있다는 점은 대규모 플릿의 프로비저닝 주기를 짧게 만드는 데 직접 기여한다 (근거: §5.2) .
다음 단계는?: 앞으로의 길
논문은 결론에서 효율적이고 그리드-응답적인 운영의 원리적 기반으로 해석적 용량-전력 관계를 제시하는 데 그치고, 별도 미래 연구 목록을 길게Enumerate하지 않는다 (근거: §6) . 한계에 비추어 합리적인 다음 단계는 다음과 같다.
- SLO 직접 결합: $\bar{\rho}$ 헤드룸 대신 TTFT (s) 와 TPOT (ms/token) 분포 제약을 (1) 에 넣어 파레토 프론트를 지연-제약 프론트로 확장한다 (근거: §2.2, §5.3) .
- 이종·멀티모델 확장: GPU 기종 혼합과 TP/PP 병렬, 양자화 정밀도별 $\pi$ (TFLOP/s) 와 $\beta$ (TB/s) 를 파라미터화해 동일 메모리 수지를 재사용한다 (근거: Appx. B.1, §1.1) .
- 동적 제어와 ESS 연계: 일시 삭감의 큐 드레인 1.3 min 같은 과도 특성을 모델 예측 제어와 배터리·UPS 협조로 감싸 피크와 램프를 관리한다 (근거: §5.3, §1.1) .
- 전송 병목 포함: KV-cache 전송 대역이 병목이 되는 장문맥·저대역 구간에서 전송 항을 용량식에 추가한다 (근거: §3.1, Appx. B.4) .
- 온라인 재캘리브레이션: MFU 0.67, MBU 0.77, 전력 ramp를 trace 드리프트에 맞춰 점진 업데이트해 경계 4% 구간의 배치 뒤바뀜을 줄인다 (근거: Tab. 3, §5.2) .
논문 원문의 표
arXiv e-print 의 LaTeX 원본에서 기계적으로 옮긴 표입니다. 숫자는 논문의 값이며 모델을 거치지 않았습니다.
표 1. Serving-capacity model characterization.
| Prefill | Decode | |
|---|---|---|
| resource demand | $F$ (ops) | $Q$ (bytes) |
| peak performance | $\pi$ (ops/s) | $\beta$ (bytes/s) |
| utilization | MFU | MBU |
| processing time | $t_P$ | $t_D$ |
| modeling unit | request | batch iteration |
| # requests / unit | $1$ | $B$ |
| # tokens / request | $\ell_\mathrm{in}$ | $1$ |
표 2. Request counts and input and output lengths for the experimental workloads. The fixed-length column lists the lengths used across the fixed-length workloads; the trace columns report sample means.
| Fixed-length | Mooncake | Azure | |
|---|---|---|---|
| # requests | — | $1000$ | $7200$ |
| $\mathbb{E}_r[\ell_\mathrm{in}]$ | $1024$–$8192$ | $8307$ | $1158$ |
| $\mathbb{E}_r[\ell_\mathrm{out}]$ | $256$ | $345$ | $211$ |
표 3. Calibrated model parameters
| Symbol | Prefill | Decode | |
|---|---|---|---|
| Serving capacity | |||
| Hardware utilization | MFU, MBU | $0.67$ | $0.77$ |
| Attention coefficient | $c_a$ | $2.17$ | |
| Per-iteration overhead | $t_\mathrm{iter}$ | $1.00$ ms | |
| Per-request overhead | $t_\mathrm{req}$ | $0.062$ ms | |
| Power ramp (W) | |||
| Static power | $p_0$ | $133$ | $448$ |
| Slope | $\gamma$ | $566$ | $458$ |
| Saturated power | $p_\mathrm{sat}$ | $692$ | $678$ |
이 글의 그림은 arXiv:2609.24639 원본에서 가져왔습니다 (CC BY 4.0). 크기와 형식만 바꿨습니다.
댓글