핵심은 Flash에서 읽을 가중치를 줄이는 것
DIP는 SwiGLU MLP의 입력과 중간 GLU 활성화에서 top-K를 선택합니다. 별도 희소성 예측기는 필요하지 않습니다. 입력 마스크는 up·gate 행렬의 열에, GLU 마스크는 down 행렬의 열에 적용합니다. LoRA는 정확도 회복을 위한 선택 사항입니다. (§4, 식 7–9)
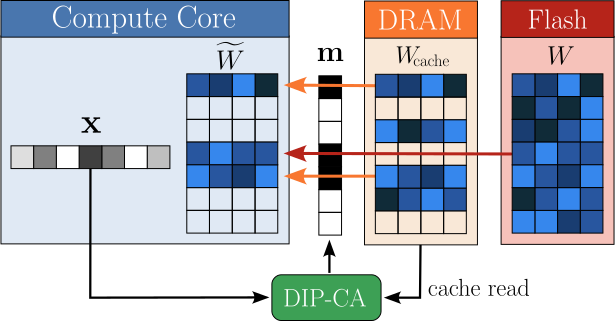
Figure 1, Federici 외, 원본 SVG , CC BY 4.0 , 다크 모드 가독성을 위해 흰 배경만 추가. 마스크에서 선택된 열을 따라 캐시 적중과 Flash 읽기를 구분해 보면 됩니다.
DIP-CA는 DRAM에 있는 열의 선택을 우대합니다. 캐시는 KV 캐시가 아니라 MLP 가중치 캐시입니다. 점수는 다음과 같습니다. (§5.2, 식 10, Algorithm 1)
$$ s_i = \frac{|x_i|\,[c_i + \gamma(1-c_i)]}{\|x\|_\infty} $$$c_i$는 캐시 존재 여부, $\gamma$는 비캐시 항목의 가중치입니다. top-K 후 누락된 가중치를 읽고 캐시를 갱신합니다.
설명용 예시: 같은 세 개를 골라도 읽는 양은 달라진다
아래 값은 직접 만든 예시이며 논문 실험값이 아닙니다. 한 선형층의 입력을 $x=[0.1,0.5,-0.2,0.8,-0.9]$, 캐시 상태를 $c=[1,0,1,0,1]$, $K=3$, $\gamma=0.2$로 둡니다. 인덱스는 1부터 셉니다.
| 열 | 입력 크기 | 캐시에 있음 | 재가중 점수 |
|---|---|---|---|
| 1 | 0.1 | 예 | 0.1111 |
| 2 | 0.5 | 아니오 | 0.1111 |
| 3 | 0.2 | 예 | 0.2222 |
| 4 | 0.8 | 아니오 | 0.1778 |
| 5 | 0.9 | 예 | 1.0000 |
크기만 보면 5·4·2번을 고르므로 4·2번 열을 읽어야 합니다. 재가중하면 5·3·4번을 골라 4번 열 하나만 읽습니다. 캐시 용량이 세 열이고 이번에 안 쓰는 1번 열을 내보낸다고 가정하면 다음 상태는 $[0,0,1,1,1]$입니다. 실제 교체 대상은 캐시 정책에 따라 달라집니다.
선택을 바꾸면 출력도 바뀝니다. 예를 들어 가중치 행을 $[1,1,1,1,1]$로 두면 원래 내적은 $0.3$입니다. 크기 기준 선택의 내적은 $0.4$, 캐시 우대 선택은 $-0.3$입니다. 읽기 감소만으로 근사 오차가 작다고 결론 내릴 수 없으므로, 정확도와 함께 평가해야 합니다. 이 예시는 한 선형층이며 전체 SwiGLU 계산을 대신하지 않습니다.
결과를 읽는 조건
§6.1은 Apple A18 사양을 가정한 전송 시뮬레이션입니다. DRAM 60 GB/s, Flash 1 GB/s를 사용하고 NPU 계산 시간은 모델링하지 않습니다. (§6.1, Appendix A)
DIP-CA의 Phi-3-Medium 대표 결과는 dense 모델을 Flash에서 스트리밍하는 기준 대비 DRAM 점유 46% 감소·처리량 40% 증가, perplexity 손실 0.1 미만입니다. (초록, §6.2) 40% 처리량 증가는 모든 요청의 지연이 40% 감소한다는 뜻은 아닙니다.
행렬곱 단위 확인: GMAC와 GFLOP
독립적인 산술 예시로, 입력 벡터 2,048개에 $4096\times4096$ 행렬 하나를 적용한다고 가정합니다. 각 출력 원소는 길이 4,096의 내적입니다. MAC 하나는 곱셈 후 누적 한 번으로 세고, FLOP 환산은 곱셈과 덧셈을 각각 한 번으로 세는 관례를 사용합니다.
$$ \mathrm{MAC}=2048\times4096\times4096 =34{,}359{,}738{,}368 $$| 가정 | 연산량 |
|---|---|
| 원래 행렬곱 | 약 34.36 GMAC ≈ 68.72 GFLOP |
| 입력 열 절반만 사용, 출력 차원 유지 | 약 17.18 GMAC ≈ 34.36 GFLOP |
이는 단일 projection의 이론적 연산량입니다. $34.36$ GMAC는 $34.36$ TFLOP가 아니며, 모델 전체 추론량이나 초당 처리 성능도 아닙니다. 입력 열 절반을 골랐다는 이유로 출력 차원까지 절반으로 줄여 75% 절감으로 계산해서는 안 됩니다. top-K·캐시 관리·전송 비용과 다른 레이어도 별도로 계산해야 합니다.
한계와 적용 판단
원문 결과는 시뮬레이션이며, DRAM 용량·Flash 속도에 따라 이득이 달라집니다. (Appendix D)
리뷰어 판단: 실제 적용에서는 정확도, Flash 읽기량, DRAM 점유, 토큰 처리량을 함께 측정해야 합니다. 이 글의 산술 예시로 GPU 속도 배수나 개발 일수를 산출할 수 없습니다. 기존 글의 근거 없는 비용·공수·GPU 비교 표는 제거했습니다.
댓글