FP4 추론과 INT8 학습을 구분하기
SageAttention3는 FP4 추론, SageBwd는 INT8 학습을 다룹니다. 일곱 행렬곱은 순전파 두 개와 역전파 다섯 개이며, $dOV^\top$는 FP16으로 유지합니다. (§3–4)
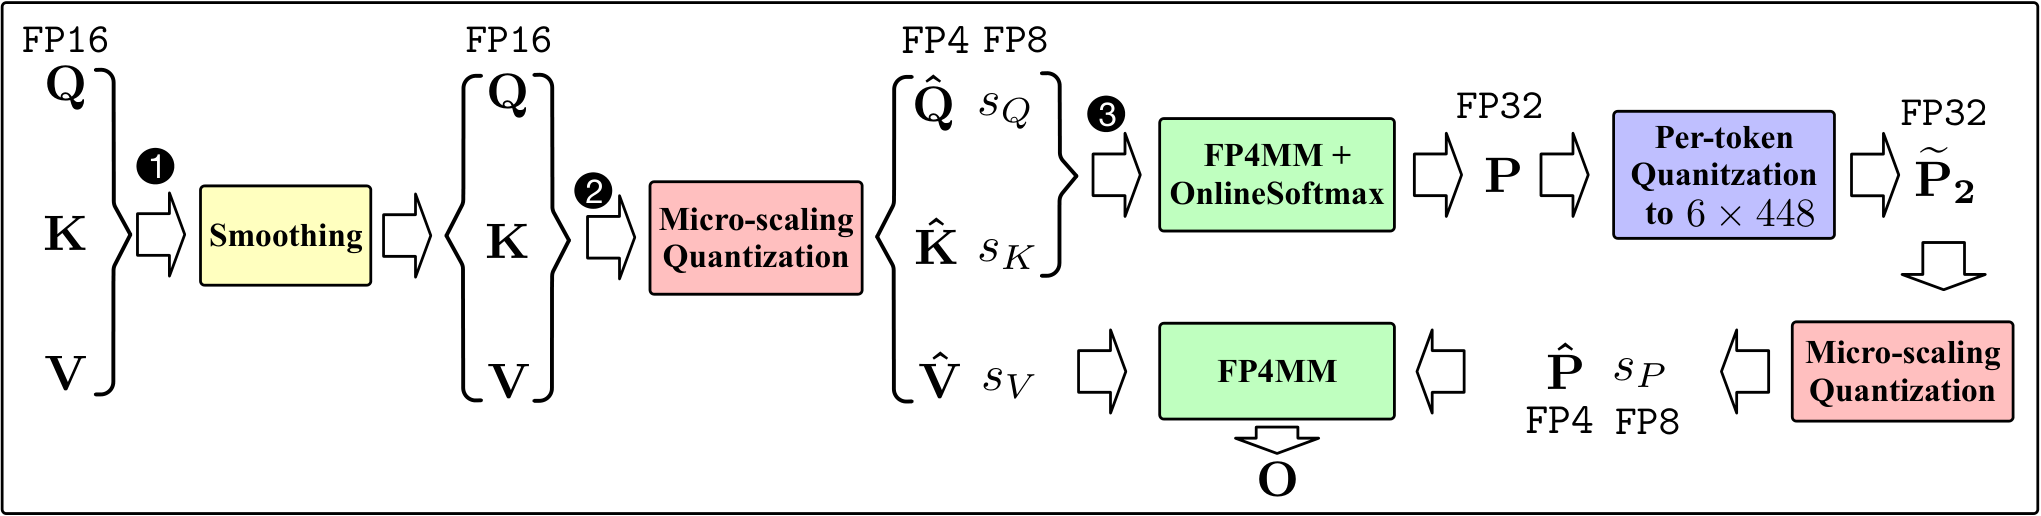
Zhang 외, Figure 2. 원본 , CC BY 4.0 , 변경 없음.
그림의 FP16 입력 → 커널 내부 양자화를 보세요. 이는 영구 KV 캐시를 FP4로 저장한다는 뜻이 아닙니다. (Algorithm 1)
설명용 예시: FP4는 정수 INT4가 아니다
NVIDIA의 자료형 문서 에 따르면 E2M1의 최댓값은 6입니다. NVFP4는 16개 값마다 FP8 스케일을 공유하며, 전역 FP32 스케일도 사용합니다. 이는 SageAttention3의 softmax용 two-level scaling 전체 설명과 구분해야 합니다.
아래는 직접 만든 자료형 계산 예시입니다. 전역 스케일을 1로 고정하고, [0, 0.7, 1.4, 3] 뒤에 0 열두 개를 붙인 16개 값의 블록을 생각해 봅시다. 최대 절댓값이 3이므로 블록 스케일은 $s=3/6=0.5$입니다. 이 스케일은 FP8 E4M3로 정확히 표현할 수 있습니다.
| 단계 | 앞의 네 값 |
|---|---|
| 입력 | 0, 0.7, 1.4, 3 |
| $s$로 나누기 | 0, 1.4, 2.8, 6 |
| 가장 가까운 E2M1 값 선택 | 0, 1.5, 3, 6 |
| $s$를 곱해 복원 | 0, 0.75, 1.5, 3 |
나머지 0 열두 개는 그대로입니다. 최대 절댓값 오차는 0.1, 블록 전체 평균제곱오차는 0.00078125입니다. 소수인 1.5가 코드 값으로 등장한다는 점도 INT4 정수 반올림과 다릅니다. 이는 양자화 오차를 보여주는 예시이며, 실제 어텐션 출력이나 모델 정확도를 측정한 결과가 아닙니다.
계산 자료형과 저장량은 별개의 질문
독립적인 저장량 계산으로, 16개 값을 담는다고 가정합시다. 패딩 없이 비트를 묶고 FP8 스케일 하나만 세면 다음과 같습니다.
| 가정 | 필요한 바이트 |
|---|---|
| FP16 값 16개 | 32 |
| FP4 값 16개 + 8-bit 스케일 하나 | 9 |
이 단순 계산의 감소율은 $1-9/32=71.875\%$입니다. 전역 스케일·정렬·기타 메타데이터는 제외했습니다. 4-bit payload만 세서 75%라고 해도, 실제 저장 포맷이나 전체 VRAM이 그만큼 줄었다는 증거는 아닙니다. KV 캐시 절감을 주장하려면 캐시의 저장 자료형과 부가 데이터를 별도로 확인해야 합니다.
커널 배수와 전체 실행 시간을 분리해서 읽기
| 측정 범위 | 원문 결과 |
|---|---|
| 추론 커널, RTX5090 | 1038 TOPS, FlashAttention2 대비 약 5× |
| 순·역전파 커널, RTX4090 | FlashAttention2 대비 최대 1.67× |
| HunyuanVideo (Original 대비) | 489 s → 164 s |
| Llama 16K 학습 한 회 (Original 대비) | 6.0 s → 5.2 s |
근거: §5.2, Table 4. 커널과 전체 실행의 배수는 같은 수치가 아닙니다.
설명용 시간 예시: 전체 100 ms 중 어텐션이 40 ms, 나머지가 60 ms라고 합시다. 어텐션만 5배 빨라져도 전체는 $60+40/5=68$ ms, 즉 약 1.47배입니다. 새 양자화 비용이 추가되면 이 계산도 달라집니다. 위 논문의 실험값을 재현한 예시는 아닙니다.
한계와 적용 판단
원문은 사전학습에서 느린 수렴을 보고합니다. (§5.2) 리뷰어 판단: 미세조정 결과를 모든 학습으로 일반화하지 말고, 커널 시간·전체 시간·품질·저장량을 각각 측정해야 합니다. 기존 글의 무조건적인 품질 보장과 KV 캐시 절감 수치는 제거했습니다.
댓글