TAO: Tool-Aware Joint Scheduling for LLM-Based Agentic Serving
TAO: LLM 기반 에이전트 서빙을 위한 도구 인지 통합 스케줄링 도입 에이전트는 모델 추론과 외부 도구 실행을 번갈아 수행한다. 도구가 도는 동안 그 세션의 GPU 수요는 중단 가능해지며, 이 빈 구간을 어떻게 쓰고 세션이 돌아왔을 때 어느 노드에 붙이느냐가 응답 시간을 좌우한다. 이 논문은 두 문제…
TAO: LLM 기반 에이전트 서빙을 위한 도구 인지 통합 스케줄링 도입 에이전트는 모델 추론과 외부 도구 실행을 번갈아 수행한다. 도구가 도는 동안 그 세션의 GPU 수요는 중단 가능해지며, 이 빈 구간을 어떻게 쓰고 세션이 돌아왔을 때 어느 노드에 붙이느냐가 응답 시간을 좌우한다. 이 논문은 두 문제…
문제: 매 단계마다 다시 읽는 이미지 이미지로 질문에 답하는 확산 언어 모델은 응답을 한 번에 완성하지 않는다. 여러 단계에 걸쳐 빈 자리를 메우는 동안, 매 단계마다 거의 변하지 않는 이미지를 처음부터 다시 읽는다. LOWN은 “지금 이 단계에 이미지가 정말 필요한가”를 매번 묻고, 필요할 때만 다시…
확산 언어 모델은 '무엇을'과 '어디를'을 동시에 정해야 한다 확산 언어 모델은 마스크된 토큰을 여러 번 반복해서 채워가며 문장을 만든다. 정확하게 디코딩하려면 한 번의 모델 forward마다 가장 확실한 마스크 위치 하나만 토큰으로 확정해야 해서 느리고, 속도를 올리려고 한 번에 여러 위치를 확정하면…
도입 대화형 서비스처럼 배치 크기가 1에 가까운 상황에서, 전문가 혼합 언어 모델의 지연 시간은 대부분 라우팅된 전문가 가중치를 GPU 메모리에서 읽는 데서 생긴다. 전문가 안의 중간 차원 대부분은 한 토큰에 거의 기여하지 않으므로, 어느 채널을 읽을지 먼저 고르면 읽는 양을 크게 줄일 수 있다. 이 논…
최근 언어 모델은 어휘 하나에 담는 정보를 계속 키우고 있다. Gemma 3n에서 처음 도입된 레이어별 임베딩(PLE)은 Gemma 4로 이어졌고, 어휘 항목마다 입력층 하나의 벡터 대신 디코더 레이어마다 다른 학습 벡터를 둔다. 이 글은 이 테이블을 약 100배 줄이면서 원본 성능 대부분을 유지하는…
문제: 이해와 생성을 하나의 표현으로 합치기 어려운 이유 이미지 이해와 이미지 생성을 한 모델로 합치려는 시도는 많다. 그러나 대부분은 두 능력을 서로 다른 표현 공간에서 따로 최적화한다. 텍스트는 토큰 분류 문제로, 이미지는 연속 벡터에 대한 확산·플로우 목표로 학습하면, 한 백본 안에서 두 목표가 서…
도입 비디오 생성 모델만으로 게임 세상을 만들면, 화면 밖에 놓인 상태는 어디에도 저장되지 않는다. 한 번 지나친 복도는 다시 그려질 때마다 달라지고, 체력 같은 규칙도 픽셀에서 다시 읽어야 한다. Matrix-Game 4.0은 규칙과 상태를 게임 엔진이 코드로 지키게 하고, 비디오 모델은 화면을 그리는…
도입 긴 문맥을 다루는 모델에서 여러 토큰을 하나의 벡터로 줄이는 압축 연산이 성능 병목이 된다. 이 논문은 압축을 가중 평균 선택이 아니라, 토큰들이 정의하는 회귀 문제의 계수를 구하는 문제로 다시 본다. TTR-Compressor는 입력 토큰에서 라벨 없이 릿지 회귀 문제를 만들고, 그 닫힌 형태 해…
토큰을 하나씩 뽑는 순차 병목 대형 언어 모델은 학습 때 문장 전체를 함께 계산할 수 있지만, 글을 만들 때는 앞 토큰을 알아야만 다음 토큰을 고를 수 있다. GPU가 아무리 빨라도 이 순서를 한 번에 건너뛸 수 없어 생성 지연이 커진다. 이 글은 이 병목을 블록 단위 flow로 푸는 Lafa(Large…
긴 에이전트 궤적이 만드는 비용과 정확도 딜레마 LLM 에이전트는 추론과 도구 호출을 수백 라운드 반복하며 긴 궤적을 쌓는다. 추론을 빠르게 만들려면 이미 계산한 key-value(KV) 캐시를 GPU에 두고 다음 토큰마다 다시 읽어야 하는데, 궤적이 길어질수록 저장·읽기 비용이 커진다. 논문은 KV 캐…
큰 청크로 만든 미래 영상을 재사용하면서 출력은 작은 단위로 확정합니다. 투기적 샘플링이 반응 지연을 줄이는 원리와 재계산 비용, 실제 서빙 실험의 조건을 살펴봅니다.
대화 이력을 고정 크기 행렬 상태에 기록하는 MemT-1.0의 구조를 살펴봅니다. 전체 문맥·검색 기반 접근과 비교해 기억의 갱신 방식과 정보 손실의 한계를 정리합니다.
본체의 내부 표현을 재사용해 초안 모델의 과거 KV 캐시를 없애는 DLite를 작은 예시와 실제 속도 비교로 설명합니다.
FlashMask-3의 Hopper 커널과 마스크 국소화, 부하 균형, 통신 중첩을 분석하고 장문 훈련 실험의 조건과 한계를 짚습니다.
카메라 기하로 과거 청크를 검색해 장면 재방문 시 기억을 복원합니다. 60초 실험에서 Full KV보다 약 12배 적고 GDN보다 약 6배 많은 메모리를 쓰는 절충을 살펴봅니다.
병렬 드래프터가 이미 만든 후보를 맥락에 맞게 다시 선택합니다. 수용 길이와 실제 처리량을 구분하고, 동시 요청 환경에서 보정 비용이 속도에 미치는 영향을 살펴봅니다.
반복 계산이 고정점에 가까워지는 성질로 KV 공유와 상태 재사용을 설명합니다. 최대 1.6B 모델에서 검증한 메모리·학습·프리필 비용 절감과 정확도 절충을 정리합니다.
모델이 직접 생성한 토큰으로 프루닝을 보정하고 디코딩 전용 커널을 결합합니다. A100 실험에서 최대 1.48배 가속을 얻은 조건과 품질 손실을 살펴봅니다.
MC-Sparse가 DiT의 희소 어텐션에서 품질과 속도 손실을 분리하는 방법을 살펴봅니다. 토큰 선택뿐 아니라 커널 실행 비용을 함께 줄여야 하는 이유를 정리합니다.
TokenRouter: 토큰 단위 LLM 라우팅을 위한 효율적 서빙 시스템 TL;DR — LLM을 세션·쿼리 단위가 아니라 토큰 단위로 라우팅하면 비용-품질 파레토 프론티어를 크게 끌어올릴 수 있지만, 단일 LLM 가정에 묶인 기존 서빙 스택(vLLM, SGLang)에서는 스텝 탈동기화·배치 수용 지연·…
Mechanics of Long-Context Hybrid Models: 하이브리드 어텐션에서 하이브리드 포지션으로 TL;DR — 요즘 오픈소스 LLM은 "full attention만 쓰는" 모델에서 "full attention + Sliding-Window Attention(SWA) 또는 Linear…
TRACE: 롤아웃을 따라가는 FP4 양자화 인식 학습 — MoE LLM의 강화학습을 BF16 성능 그대로, 최대 5.4배 빠르게 한 줄 요약 (TL;DR) MoE LLM의 강화학습(RL)에서 롤아웃 생성을 FP4(W4A4 + FP4 KV) 로 양자화하면 생성 속도가 최대 5.4배 빨라지지만, 학습 경로…
SlimKV: 토큰과 피처를 함께 압축하고, 복원 없는 잠재 공간 어텐션으로 KV 캐시를 32배까지 줄이다 TL;DR SlimKV는 긴 문맥(long-context) LLM 추론의 병목인 KV 캐시를 토큰 축(token-wise)과 피처 축(feature-wise)에서 동시에 압축하는 질문-독립적…
TaSQ: 1비트 KV 캐시를 위한 양자화 공간 '맞춤 설계' TL;DR — TaSQ(Tailored Space Vector Quantization)는 벡터 양자화(VQ)가 적용될 타깃 공간 자체를 재설계해, KV 캐시를 채널당 약 1.25비트로 압축하면서도 BF16에 근접한 품질을 유지한다. 핵심은 쿼…
서로 다른 LLM 사이에서 KV 캐시를 그대로 건네받는 법: HeteroFold 한 줄 요약 (TL;DR) : 서로 다른 토크나이저와 구조를 가진 모델 사이에서도 수신자가 다시 프리필하지 않고 KV 캐시를 재사용하는 방법 HeteroFold가 6개 방향 모두에서 기존 캐시 전송을 앞지르고 32K 문맥에서…
온폴리시는 만능이 아니다: 증류 동역학에서 롤아웃 정책·KL 방향·학습률의 진짜 주인공 TL;DR — 강-약 증류(strong-to-weak distillation)에서 온폴리시(OnPD)와 오프폴리시(OffPD)를 분리해 보면, 최종 성능·망각·업데이트 희소성을 좌우하는 것은 롤아웃 정책이 아니라 KL…
KV 캐시가 새로운 메모리 월(Memory Wall)이다: 장문맥 LLM 추론의 세 영역과 다섯 도메인 TL;DR — 장문맥 LLM의 디코드(decode) 추론은 산술 연산이 아니라 메모리 대역폭에 묶이며, 문맥 길이가 계산 가능한 특정 "크로스오버(crossover)" 지점을 넘어서면 병목이 모델 가중…
WavePP — 프리픽스 재사용을 태우는 파이프라인 병렬 프리필 런타임 TL;DR TensorRT-LLM 위에 구축한 WavePP 는 요청 admission(재사용 합의·캐시 보호·용량 예약)을 파이프라인 실행과 비동기로 겹쳐 처리 하고, wave 크기를 동적으로 조절해 파이프라인을 꽉 채운다. 동일 커…
위상 감수성(Phase Sensitivity): 청크 단위 KV 캐시 압축이 만드는 '주기적 약점' TL;DR — 청크 단위 KV 캐시 압축을 쓰는 모델(DeepSeek-V4 계열 등)에서, 같은 정보라도 압축 창 경계를 기준으로 한 '위상(phase)'에 따라 검색 성능이 최대 40pp까지 주기적으로…
MassAlloc Attention(MALA): 어텐션이 스스로 연산을 배분하게 하다 TL;DR — 풀 소프트맥스 어텐션(FullAttn)은 매 causal 타일마다 QK 점수 생성 이후 의 연산(post-score)을 전부 수행하지만, MALA는 어텐션이 스스로 만든 정규화 기여도(normalized…
WorldAttention: 슬라이딩 윈도우를 버린 인터랙티브 비디오 월드 모델의 시스템 공동 설계 TL;DR — 텍스트로 제어되는 인터랙티브 비디오 월드 모델은 "전체 히스토리를 기억해야 한다"는 요구와 "KV 캐시가 선형으로 불어 GPU 메모리가 터진다"는 현실 사이에 갇혀 있다. 알리바바 DAMO…
PISA: 피라미드 Top-$K$ 선택으로 블록 스파스 어텐션의 비용을 $O(N\log N)$으로 낮추다 TL;DR — 블록 스파스 어텐션에서 '어텐션 계산'은 선형이지만 '블록 선택'이 여전히 이차 비용이라는 문제를, 키(key)를 평균 풀링으로 피라미드 계층화하고 각 레벨에서…
KV 캐시 비용은 누가 내는가? — 쿠버네티스·게이트웨이·프로바이더 청구서를 하나의 장부로 TL;DR — 같은 AI 기능 한 건에 드는 비용은 쿠버네티스 할당, 게이트웨이 로그, 프로바이더의 토큰 단위 청구서라는 서로 연결되지 않은 세 장부에 흩어져 있다. 저자는 이 세 장부를 하나의 Decimal-정확…
LumoTree: Path-Parallel Speculative Verification for Hybrid Language Models TL;DR — Gated DeltaNet과 full-attention을 섞은 하이브리드 모델에서 트리 스페큘레이티브 디코딩을 하려면, recurrent 상태·컨볼루션 히…
SPECTRA: 추론 단계가 바뀔 때마다 하드웨어도 옷을 갈아입는 재구성 가능 LLM 가속기 한 줄 요약 (TL;DR) 스펙큘레이티브 디코딩은 프리필(연산 바운드 GEMM)·디코드(메모리 바운드 GEMV)·그 사이의 병렬 검증을 오가며 산술 강도 가 토큰마다 출렁인다. 고정 데이터패스로는 이 세 체제를…
압축된 기억 위에서 가지를 뻗기: DeepSeek-V4에 트리 추론을 얹은 이야기 TL;DR DeepSeek-V4-Flash에 트리 구조 추론적 디코딩을 올리면 같은 검증 예산에서 더 긴 채택 길이와 최대 약 18.5% 의 디코드 처리량 향상을 얻는다 (근거: §5, Fig. 4) . 핵심은 트리 자체가…
Flash-dLLM: I/O를 먼저 본 Diffusion LLM 가속, 퓨즈드 캐시와 셀프 검증으로 210.6 tokens/s 를 열다 한 줄 요약 (TL;DR) Diffusion LLM(dLLM)은 병렬 디노이징이 가능하지만 KV 캐시 재사용과 병렬 디코딩을 함께 쓰면 GPU 메모리 I/O가 병목이 된…
Drafter-Side KV Cache 없이 병렬 추론하기: H-Spec의 하이브리드 추측 디코딩 TL;DR 은 블록 확산 드래프터가 매 토큰마다 타깃 은닉 상태를 투영해 별도 KV 캐시를 유지해야 한다는 점이 동시 서빙의 병목임을 보이고, 타깃 KV 제자리 재사용과 마지막 토큰 은닉 상태 $O(1)$…
PD 분리 LLM 추론에서 prefill·decode 인스턴스 수와 KV-cache 예약을 함께 모델링해, 요구 용량을 가장 낮은 전력으로 만족하는 배치를 찾는 해석적 프로비저닝 방법을 소개한다.
VC-Attention은 비디오 Diffusion Transformer의 저비트 어텐션에서 값 양자화 오차와 softmax 병목을 함께 줄여 B200에서 어텐션을 최대 1.59배 가속한 학습-프리 커널이다.
ActionPiece: 재구성 오차 너머, 물리적 순위로 액션 토크나이제이션을 다시 생각하다 TL;DR — 자율회귀(autoregressive) VLA(vision-language-action) 모델에서 액션 토크나이저는 연속적인 로봇 명령을 이산 토큰으로 압축하고, 예측된 토큰을 다시 실행 가능한 명령…
DeepSeek-V4.1-Flash: KV 캐시를 1/4로 줄이면서 성능은 더 끌어올린 멀티모달 MoE 한 줄 요약 (TL;DR). DeepSeek-AI가 공개한 DeepSeek-V4.1-Flash 는 552B 백본 파라미터의 멀티모달 MoE로, 최대 1M 토큰 컨텍스트를 지원한다. Causal…
Fathom: 쿼리마다 깊이를 바꾸는 스캔으로 1M 토큰 디코딩을 1.67배 빠르게 하다 한 줄 요약 (TL;DR) 에이전트 세션이 1M 토큰까지 길어지고 수십 세션이 동시에 상주하면 KV 캐시와 이를 랭킹하는 인덱스가 호스트 메모리에 살게 되고, 매 디코드 스텝의 top-k 스캔이 PCIe 바이트에 의…
SSD에 산 MoE를 깨우다: 24 GB 데스크톱에서 35B MoE를 20 tok/s로 서빙하는 Edge0 한 줄 요약 (TL;DR) 35B급 MoE는 4-bit로도 19.5 GB 를 차지해 24 GB 머신에 상주하지 못한다 (근거: §1). Edge0는 엑스퍼트 가중치를 SSD에 두고 mmap 스트리밍…
StepAudio 3 Gen: 이산 자회귀(RVQ) 하나로 음성·노래·음악·효과음을 통합하다 한 줄 요약 (TL;DR) StepFun이 발표한 StepAudio 3 Gen 은 12.5 Hz 프레임률의 $16 \times 2048$ 잔차 벡터 양자화(RVQ) 토크나이저로 모든 오디오를 하나의 공유 이산 코…
"무손실" 스페큘레이티브 디코딩은 정말 무손실일까? — Orthrus 재현으로 드러난 수치 정밀도의 함정 TL;DR — Orthrus는 frozen AR 백본에 diffusion 뷰를 얹어 여러 토큰을 병렬로 생성하며 "무손실(lossless)" 스페큘레이티브 디코딩을 주장한다. 저자들이 이를 독립 재현…
ZGCM-1: 7B 밀집 모델이 235B 프런티어와 겨루는 법 — 완전 개방형·초고효율 파운데이션 모델 설계 보고서 TL;DR — ZGCM-1은 7.39B 밀집(dense) 모델 하나로 AIME 2026 75.0%, WebWalkerQA 63.1%, Binary Function Search 62.0%를…
Programmable World Model — 생성형 월드에 "실행 가능한 상태"를 심다 한 줄 요약 (TL;DR) 비디오 월드 모델은 점점 더 사실적인 인터랙티브 환경을 만들어내지만, 화면에 잠깐 스친 픽셀만 기억할 뿐 "세상이 지금 실제로 어떤 상태인지"는 알지 못한다. Alaya Lab의…
SAS: 증류 없이 문맥 랭킹을 직접 학습하는 단순한 어텐션 스파시피케이션 TL;DR — 사후 학습(post-training) 어텐션 스파시피케이션에서, 선택기(selector)가 만든 연속 점수를 어텐션 로짓에 로그 게이트(log gate) 로 주입한다. 이렇게 하면 이산 Top-K 선택이 막고 있던…
CoVeR: 지오메트리만으로 멀티뷰 3D 추론의 비주얼 토큰을 92%까지 덜어내는 커버리지 기반 프루닝 한 줄 요약 (TL;DR) 3D 장면을 여러 시점 이미지로 렌더링해 2D VLM에 넣으면 토큰이 시점 수에 비례해 폭증한다. CoVeR는 학습 없이 오직 토큰의 3D 좌표만 사용해 장면 전체를 균등하게…
Marigold V2: 이미지 편집 확산 트랜스포머(DiT)를 단안 깊이 추정기로 되살리기 한 줄 요약 (TL;DR) Qwen-Image-Edit-2509라는 이미지 편집용 확산 트랜스포머(DiT)를 4-bit QLoRA로 파인튜닝해, 단일 32GB GPU에서 약 1주일 만에 단안 깊이 추정 SOTA를…
SQS: 가지치기와 양자화를 하나의 베이지안 학습으로 — 스파이크-앤-슬랩과 GMM의 만남 TL;DR — 프루닝(pruning)과 저비트 양자화(quantization)를 따로 하면 남는 잉여가 생긴다. SQS는 스파이크-앤-슬랩 사전분포와 가우시안 혼합 모델(GMM)을 하나의 변분…
칼만 필터로 다시 쓴 선형 어텐션: Kalman Delta Networks 한 줄 요약 (TL;DR) 선형 어텐션(linear attention)의 고정 크기 recurrent memory 갱신을 선형-가우시안 상태공간 모델 로 재해석하고, 최적 추정기인 칼만 필터(Kalman filter) 의 공분산…
X-AuT: 행동 프로브와 크로스스케일 증류로 음성 LLM의 오디오 인코더를 깎아내는 방법 한 줄 요약 (TL;DR) 음성 LLM의 오디오 인코더(오디오 Transformer)를 18→16→14 레이어로 점진적으로 프루닝 하면서, 짧은 행동 프로브(behavioral probe) 로 회복 가능한 레이어…
데드라인을 채우는 프리필 청크: SLOWeave — LLM 서빙의 적응형 청킹 스케줄러 TL;DR — 고정된 프리필 청크 크기 대신, 매 반복(iteration)마다 "가장 이른 디코드 데드라인 전에 끝나는 가장 큰 프리필 청크"를 이진 탐색으로 선택하는 온라인 스케줄러 SLOWeave를 제안한다. 25…
비디오 LLM은 왜 아직도 비싼가? — 추론 효율화 메커니즘 4단계 총정리 TL;DR — 이 논문은 2022년 말부터 2026년 8월까지 발표된 VideoLLM 추론 효율화 연구 125편을 엔코더–커넥터–LLM 파이프라인의 4단계로 분류하고, "같은 호스트 모델 · 같은 입력 프로토콜"에서만 통제 비교를…
Miles v0.1: 프론티어 RL 사후학습을 위한 "검증·청결·확장 가능"한 풀스택 시스템 TL;DR : Miles는 rolluout 생성과 트레이닝이 서로 다른 엔진·커널·정밀도로 돌아가며 발생하는 train-rollout mismatch를 시스템 차원에서 해결하는 풀스택 RL 사후학습 프레임워크다.…
대규모·장문맥 RL 사후학습에서 Speculative Decoding을 실용화하는 두 가지 설계 TL;DR : RL 사후학습의 벽-클록 시간을 지배하는 롤아웃 생성을 speculative decoding으로 가속하고, 여기에 온라인 드래프트 공동학습(co-training) 을 더해 정책이 진화해도 드래프…
캐시를 배우는 라우터 : 메모리-제약 MoE 추론을 위한 Cache-Aware Joint Router Adaptation 한 줄 요약 (TL;DR) MoE의 진짜 병목은 연산량이 아니라 전문가 가중치 이동량이다 라는 문제의식에서 출발해, 네이티브 Top- $K$ 선택 규칙은 그대로 두면서 캐시 상주 우선…
VestigeKV: 퇴화한 RoPE 가지가 스스로 캐시 축출 신호를 품고 있다 한 줄 요약 (TL;DR) NoPE-MLA 모델(Kimi Linear 48B)에서, 훈련이 샐리언스 채널 로 재용도한 64차원 decoupled branch — RoPE의 "퇴화 기관(vestige)" — 를 행의 11% 만…
ShallowStream: 얕게 인덱싱하고, 깊게 답하라 — 스트리밍 비디오 이해의 계산 병목을 푸는 방법 TL;DR — 스트리밍 비디오 이해에서 가장 비싼 비용은 매 프레임을 MLLM의 전체 깊이(2832개 레이어) 로 prefill하는 것이다. ShallowStream은 얕은 레이어 45개 만으로 프…
Uno: AR과 Diffusion을 하나의 모델에 — 무손실 병렬 생성을 통한 LLM 가속 TL;DR — LLM이 느린 이유는 next-token prediction(NTP)이 한 번에 토큰 하나씩만 내놓는 순차 구조 때문이다. Uno는 하나의 아키텍처에 품질을 책임지는 AR 가중치 와 속도를 책임지는…
모델이 '생각을 다시 꺼내 보는' 순간을 잡아라: BeaconKV가 비콘 쿼리로 추론 KV 캐시를 5.8배 압축하는 법 TL;DR — Large Reasoning Model(LRM)은 긴 Chain-of-Thought(CoT)를 생성할수록 KV 캐시가 선형으로 불어나, Qwen3-4B가 32K 토큰을 배…
FP4 텐서 코어가 빨라도 어텐션은 왜 안 빨라지는가: Direct-P와 양자화된 역전파로 푼 Blackwell FlashAttention-4 TL;DR — Blackwell의 FP4 텐서 코어는 행렬곱을 BF16보다 훨씬 빨리 처리하지만, 어텐션은 행렬곱 두 개 사이에 softmax 라는 "중간 작업"…
언어 모델이 스스로 어텐션을 통제한다: Declarative Attention TL;DR — 기존의 희소 어텐션(sparse attention)은 매 디코딩 스텝마다 어떤 토큰이 중요한지 외부에서 근사 하느라 여전히 $O(N)$ 비용을 지불했다. 이 논문은 방향을 틀어, 모델이…
같은 요청, 다른 답: 프리픽스 캐시가 서빙을 비재현적으로 만들고, 양자화가 이를 증폭시킨다 TL;DR — 프리픽스 캐시는 "투명한 최적화"로 여겨지지만 투명하지 않다. 캐시를 끄면 동일 워크로드의 반복 실행이 10개 설정 × 80에피소드 = 800개 전부 비트 단위로 동일 하게 재현되는 반면 (근거:…
SGD-KV: '요약을 잘하는 헤드'를 찾아 1M 토큰의 KV 캐시를 75%까지 줄인다 TL;DR — 어텐션 헤드는 모두 같은 일을 하지 않는다. '요약'이라는 고차원 정보 압축을 담당하는 summarization heads 를 진단 태스크로 찾아내고, 그 점수에 비례해 KV 캐시 예산을 나눠주는…
SMELT: 계산량을 맞춘 MoE 루프 트랜스포머의 스케일링 법칙 한 줄 요약 (TL;DR) 루프 트랜스포머는 레이어 블록을 반복 실행해 깊이를 늘리지만, 기존 연구는 대부분 파라미터 수만 고정한 채 FLOPs를 늘려 "공짜 점수"를 얻고 있었다. SMELT는 per-token FLOPs·총 파라미터…
순환 절반은 양자화하기 쉬운 절반이다: Gated DeltaNet이 4비트에서 살아남는 이유 TL;DR — 하이브리드 27B LLM(Qwen3.8-27B)의 순환 레이어인 Gated DeltaNet(GDN) 48개 층은 그동안 "오차가 문맥을 타고 누적된다"는 직관 때문에 816비트로 보호되어 왔다. 이…
점수는 낭비였다: KV 캐시 eviction에서 '무작위 추출'이 최강자와 동률이 되는 역설 — Random Attention 심층 리뷰 TL;DR — 추론 특화 KV 캐시 eviction 연구는 전부 "어떤 토큰이 나중에 중요한가"를 점수화해서 top-K 를 고르는 문제였다. Random…

Engram: 조건부 연산(MoE) 이후의 두 번째 희소성 축, 조건부 메모리(Conditional Memory) 한 줄 요약 (TL;DR) Engram은 Transformer에 “지식 조회(lookup) primitive”를 추가해, 표준 모델이 early layer에서 수행하던 정적 지식/로컬 패턴…
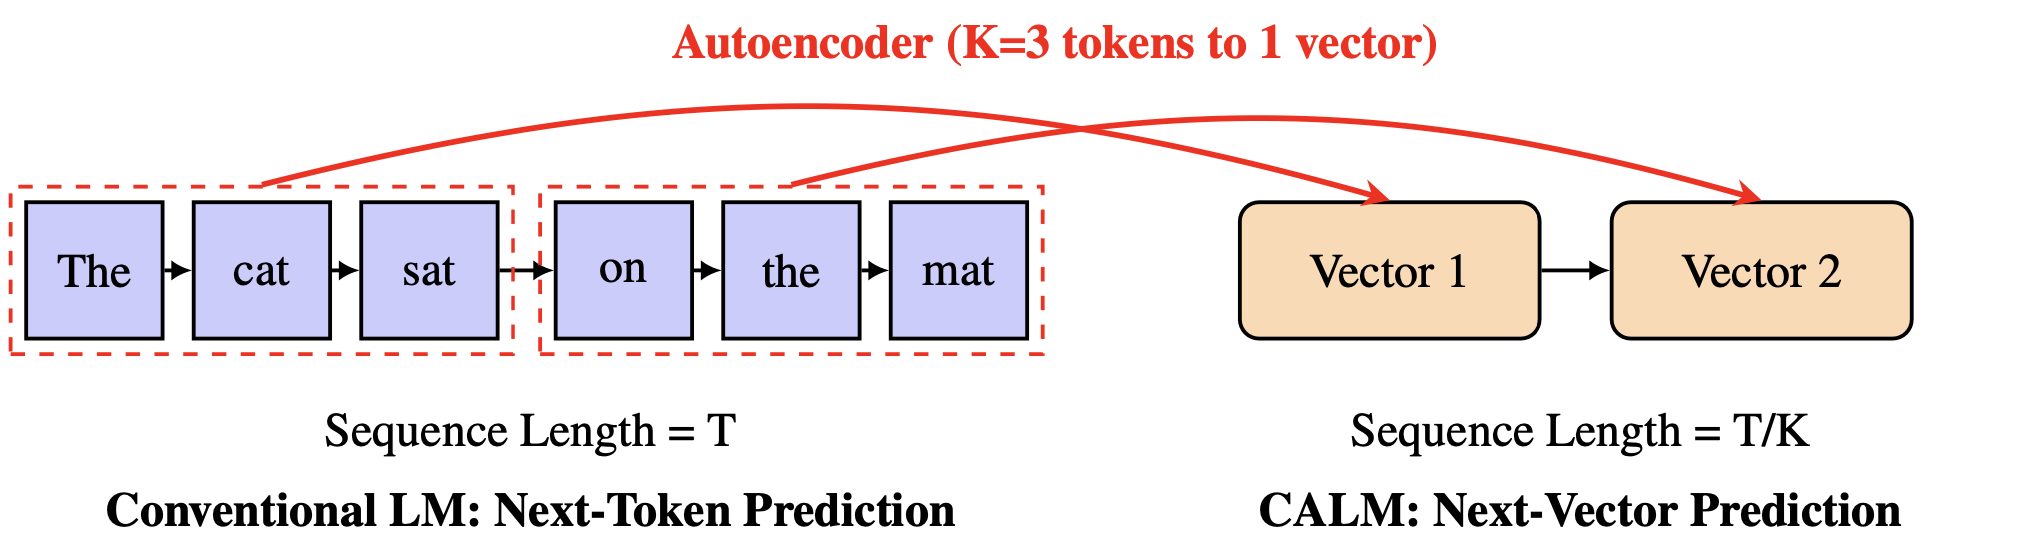
CALM: 토큰-by-토큰 병목을 “연속 벡터-by-벡터”로 우회하는 Likelihood-Free 언어모델링 CALM (Continuous Autoregressive Language Models) 은 (K=4) (tokens/step) 단위로 토큰을 연속 잠재벡터로 압축한 뒤 next-vector를 AR…

Function Token Hypothesis: LLM “기억 검색”의 게이트는 왜 구두점과 개행인가 한 줄 요약 (TL;DR) 이 논문은 LLM의 기억을 “feature의 재활성화(retrieval) + 학습을 통한 feature 확장(consolidation)”으로 정의하고, function…

NVIDIA Nemotron 3: 하이브리드 Mamba–Transformer MoE로 “정확도/처리량” 프런티어를 당기다 Nemotron 3 는 MoE 하이브리드 Mamba–Transformer, LatentMoE , MTP , NVFP4 학습, 멀티-환경 RL 을 결합해 “정확도 대비 추론 처리량…

Radial Attention: O(n log n) Sparse Attention with Energy Decay로 “긴 비디오”를 싸게 뽑기 한 줄 요약 (TL;DR) 사후(softmax 이후) attention 에너지가 거리(시간/공간)와 함께 지수적으로 감쇠 한다는 관찰을 바탕으로, 계산 밀도도 같…

Massive Activations가 만든 하나의 서사: Attention Sink 와 Compression Valley 를 잇다 TL;DR 잔차 스트림의 massive activations(특히 BOS) 가 지배적 특이값 을 형성해 중간층 표현 압축(엔트로피↓) 과 attention sink(주목이…

GTA & GLA: 디코딩의 ‘메모리-지배’를 깨는 하드웨어 효율 어텐션 TL;DR GTA(키·값 타이잉)와 GLA(잠재 헤드 샤딩) 으로 FLOPs/byte를 끌어올리고 per-GPU KV 캐시를 줄여, 품질 손실 없이 커널 1.2–2× 가속, 서빙 지연 대폭↓, 처리량 최대 2×↑ 를 달성한다. (근…
“GPU에 OS를 입히자”: LLM 시대를 위한 GPU 멀티태스킹 OS 레이어 의 제안 한 줄 요약 (TL;DR) LLM 서빙에서 GPU는 종종 ≤10%대 활용 에 머무르고(현장 관찰), 부하는 수분 단위 3× 로 요동한다. 저자는 커널-그레인 시간/공간 공유 + CUDA 가상메모리(2 MB) 기반 메모…
DroidSpeak: 교차-LLM Prefix-KV 재사용으로 프리필 지연을 1.7–3.1× 줄이는 방법 TL;DR (한 줄 요약) 동일 아키텍처이되 가중치가 다른 LLM들 사이에서, 보내는 모델의 prefix KV를 받는 모델이 연속층 부분 재계산 + E-first 파이프라이닝으로 재사용하면 TTFT(…

Marconi: 하이브리드 LLM 시대의 프리픽스 캐싱을 다시 설계하다 한 줄 요약 (TL;DR) Marconi는 하이브리드 LLM(Attention+SSM) 서빙에서 재사용 가능성이 높은 접두만 선별 입장(admission) 하고, FLOP/바이트 효율을 반영한 퇴장(eviction) 으로 캐시를 관리…

SGLang & RadixAttention: “LM 프로그램” 시대의 실행 최적화, 어떻게 6.4× 빨라졌나 TL;DR 언어–런타임 공동 설계(co-design) 위에 RadixAttention(라딕스 트리 기반 KV 캐시+스케줄링), Compressed FSM(다중 토큰 제약 디코딩), API…

Structured State Space Duality: Mamba-2로 본 SSM↔Attention 통일과 2–8× 가속 한 줄 요약 (TL;DR) SSD(Structured State-Space Duality) 는 SSM과 마스킹 어텐션이 동일 함수를 서로 다른 수축 순서로 계산한다는 통찰을 제시하고…

Dynamic Memory Sparsification(DMS): KV 캐시 8× 압축으로 LLM 하이퍼-스케일링을 현실로 한 줄 요약 (TL;DR) 1 K 스텝만의 경량 재적합과 지연 퇴출 전략을 결합한 DMS는 KV 캐시를 최대 8× 압축하면서도 Qwen-R1 32B 기준 AIME 24 +9.1 pt…

Hydragen: 공유 프리픽스가 있는 대규모 배치를 32 × 빠르게 디코딩하는 비밀 병기 한 줄 요약 (TL;DR) Softmax 분모 재스케일링으로 프리픽스-서픽스를 분해해 Code-Llama-13 B 기준 vLLM보다 최대 32배 빠르게, 동일 출력을 보장하며 장문·대규모 배치 디코딩을 가속한다.…

Kimi K2: 오픈소스 LLM이 에이전트 지능을 향해 내딛은 한 걸음 TL;DR MuonClip 프리트레인 + 대규모 에이전틱 툴 데이터 + Verifiable‑RL 정렬의 3‑단계 파이프라인으로, Kimi K2는 τ²‑Bench 66.1·SWE‑bench 65.8 등에서 기존 오픈소스 모델을 두 자릿…

Qwen 3: 생각량을 조절하는 거대 MoE 언어모델의 진화 한 줄 요약 (TL;DR) Qwen 3는 “얼마나 깊게 생각할지”를 토큰 수치로 직접 제어할 수 있는 Thinking Budget과 128-전문가 MoE 설계를 결합해, 활성 파라미터 22 B 만으로도 기존 100 B+ 밀집 모델을 넘어서는 성…
Massive Activations, Hidden Biases: 재해석된 Self-Attention의 비밀 한 줄 요약 (TL;DR) 수천만 개 중 4–10 개의 초거대 스칼라(×10 000) 가 LLM · ViT의 성능을 사실상 ‘혼자서’ 지탱한다. 이 스칼라는 입력과 무관한 상수형 자기-어텐션…
Peri-LayerNorm: Post-LN와 Pre-LN을 넘어서는 세 번째 선택지 한 줄 요약 (TL;DR) Residual 직후에 LayerNorm을 한 번 더 넣는 “Peri-LayerNorm(Peri-LN)” 구조만으로 — 400 M→3.2 B 파라미터 LLM에서 FP16 오버플로를 0 건으로 만…
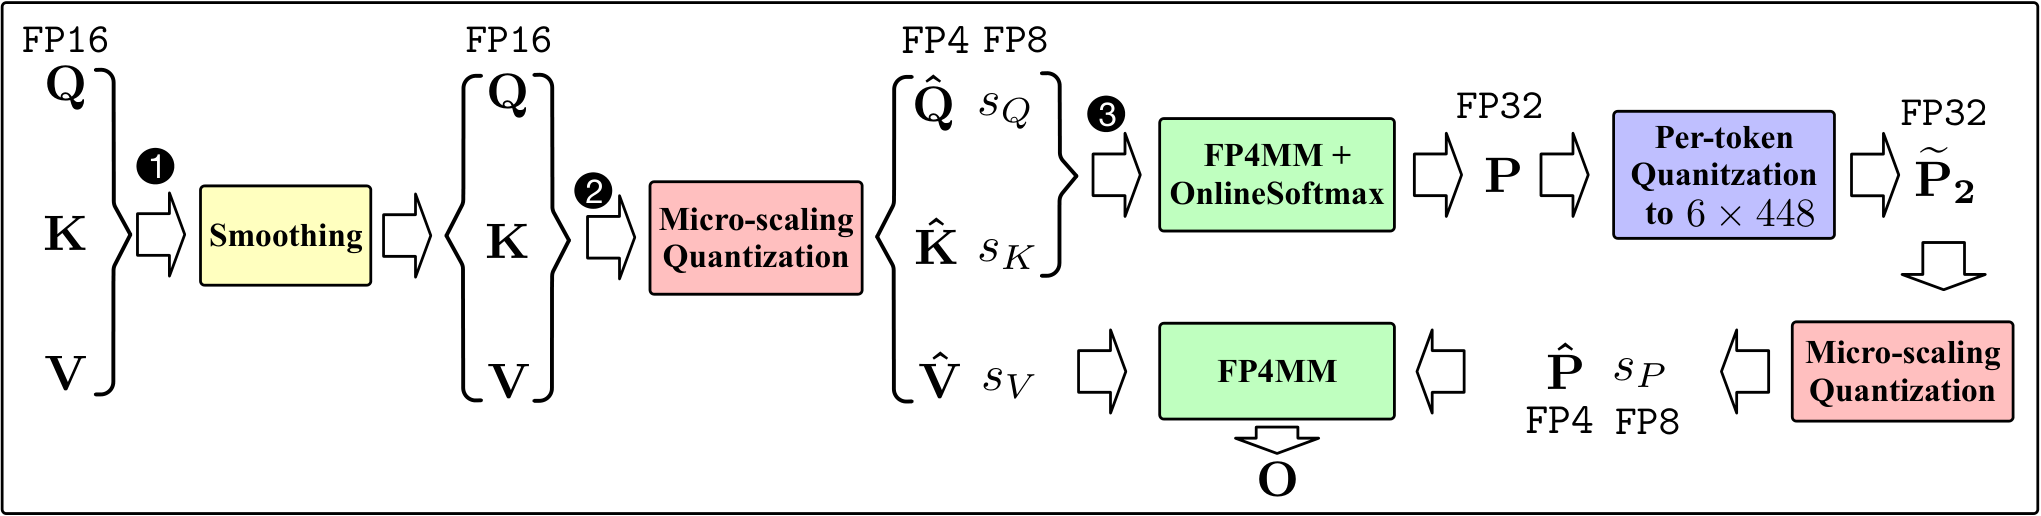
SageAttention3의 FP4 추론과 SageBwd의 INT8 학습을 구분합니다. 검산한 예시로 양자화 오차, 저장량, 커널과 전체 실행 시간의 차이를 설명합니다.
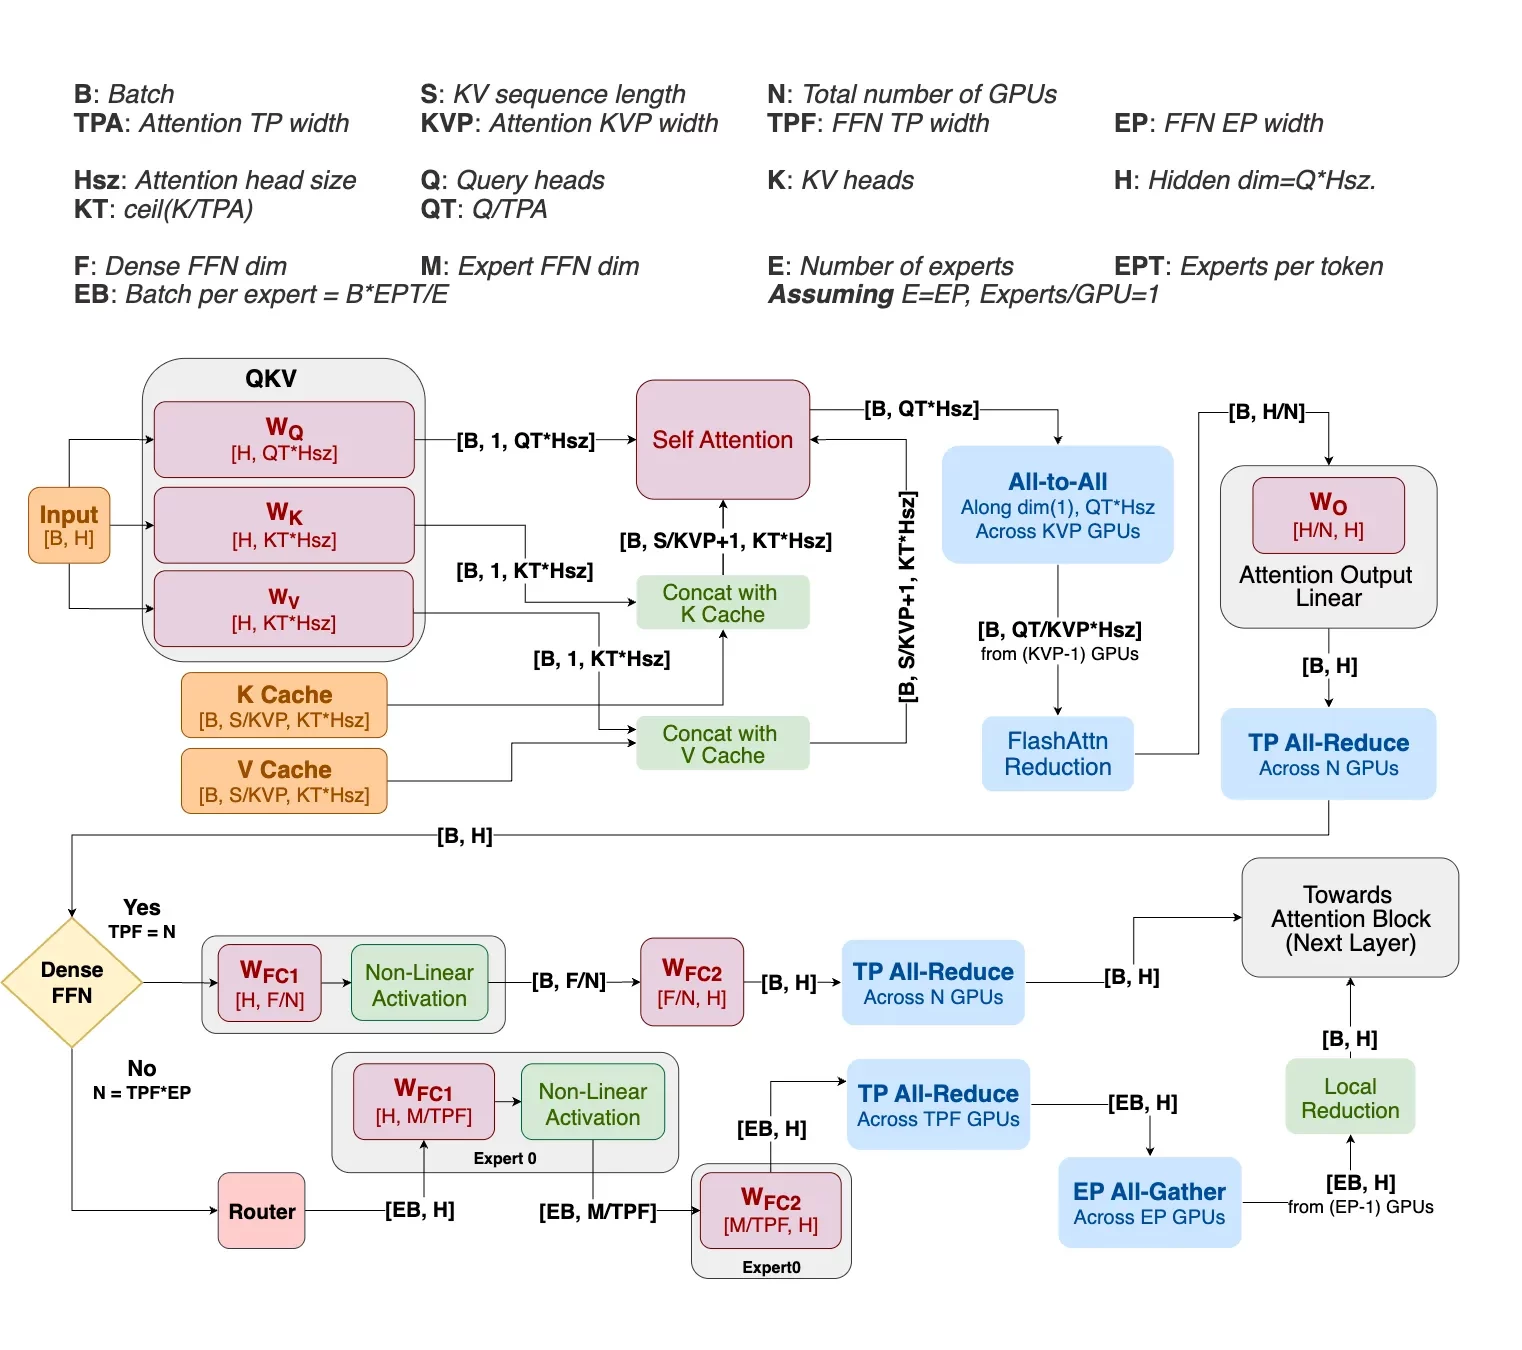
Helix Parallelism: 초장기 LLM 디코딩의 지연-처리량 벽을 깨다 한 줄 요약 (TL;DR) Helix Parallelism은 Attention과 FFN을 서로 다른 병렬화 전략으로 스케줄링해 KV 캐시 중복과 FFN 가중치 로드 병목을 동시에 해소—1 M 토큰 컨텍스트에서 토큰 지연을 최…
Subgoal Curriculum + CoT Consistency: DeepSeek-Prover-V2가 자동 정리 증명의 판을 갈아엎다 TL;DR DeepSeek-Prover-V2는 “문제를 잘게 쪼개고, 쪼갠 대로 끝까지 맞춘다”는 원칙으로 소형 7 B 모델에서도 MiniF2F Pass\@32 82.4…
Inference-Time Scaling: DeepSeek-GRM이 초대형 모델을 넘어선 비결 한 줄 요약 (TL;DR) “27 B 모델 × 32배 샘플”—Generative Reward Model(GRM)과 k-Vote 합산만으로 GPT-4o·Nemotron-340B보다 높은 종합 정확도 72.8 %를…
CODE I/O: 코드 입·출력 + 자연어 CoT로 범용 추론까지 — 데이터 설계만으로 7B-30B LLM을 평균 +2 점 끌어올리다 TL;DR “코드 함수 → 입력·출력 예측 + 체계적 Chain-of-Thought(CoT)”라는 단일 데이터 파이프라인만으로, 3.5 M 샘플이 14 M 규모 SOTA…
Native Sparse Attention (NSA) — 64 k 토큰도 11× 빠르게, 정확도는 그대로 한 줄 요약 (TL;DR) NSA는 ‘압축 → 선택 → 슬라이딩’ 3 분기 희소 어텐션과 GQA/MQA-친화 커널을 결합해 64 k 컨텍스트에서 디코딩 속도를 11.6 배, 학습 속도를 최대 9 배…
Janus-Pro 7B: Dual-Encoder Multimodal LLM That Outsmarts Bigger Models 한 줄 요약 (TL;DR) SigLIP 이해 인코더 + VQ 생성 인코더를 완전히 분리한 뒤 7 B 파라미터 LLM에 붙이는 ‘Dual-Encoder + Adapter’ 설계로,…
한 줄 요약 (TL;DR) DeepSeek-V3는 671 B-parameter MoE LLM에 Aux-loss-free Load-Balancing Bias + FP8 혼정밀 훈련 + Multi-Token Prediction을 결합해, dense 405 B 모델과 동급 (또는 우위) 성능을 절반 이하의…
📝 Janus: 두 얼굴의 인코더로 멀티모달 이해 + 생성의 딜레마를 깬 1.3 B 모델 한 줄 요약 (TL;DR) Janus는 멀티모달 이해와 이미지 생성에 요구되는 서로 다른 표현 ― 고차원 semantic vs. 저차원 texture ― 의 “표현 충돌”을 듀얼 비전 인코더(SigLIP + VQ…
한 줄 요약 (TL;DR) JanusFlow는 Rectified Flow + 분리형 비전 인코더 + 표현 정렬로 1.3 B 파라미터 단일 모델만으로 이미지 이해·생성 양쪽에서 동급 최고 성능(FID 9.51 / GenEval 0.63 / MMBench 74.9)을 달성한다. 핵심 아이디어 “LLM 내부에…
한 줄 요약 (TL;DR) Loss-Free Balancing(LFB)은 auxiliary loss를 완전히 제거한 채, 전문가별 bias 한 줄 업데이트만으로 Mixture-of-Experts(MoE) 모델의 ‘로드 밸런스 ↔ 성능’ 딜레마를 깨고 Perplexity ≈ 0.5↓, MaxVio ≥ 90…
한 줄 요약 (TL;DR) Fire-Flyer 2는 1만 대의 PCIe A100 GPU를 HFReduce·HaiScale 스택으로 묶어 DGX-A100의 80 %대 성능을 장비·전력 40 % 절감으로 달성한 ‘가성비형 초대규모 LLM 훈련 클러스터’다. 핵심 아이디어 PCIe GPU + CPU 감축 +…
DeepSeek-Coder: GPT-3.5 Turbo를 추월한 최초의 오픈소스 코드 LLM AI 실무자가 꿈꿔 온 “상용 수준을 넘어서는 공개 코드 모델”이 마침내 등장했다. DeepSeek-Coder는 레포지터리 전역 의존성 학습, 16 K 토큰 장문맥, FIM 중심 사전학습이라는 세 가지 설계 축으로…
DeepSeekMoE 정리 – Dense 성능을 40 % FLOPs로 끌어낸 ‘세분화-전문가’ 트릭 한 줄 요약 (TL;DR) Fine-Grained Expert Segmentation (FGES) + Shared Experts (SEI) 로 FFN-MoE를 재설계한 DeepSeekMoE는 동일…
📝 한 줄 요약 (TL;DR) DreamCraft3D는 2-스테이지 3D 생성 파이프라인과 \Bootstrapped Score Distillation(BSD)\라는 비밀 병기를 결합해, 단 한 장의 2D 이미지(또는 텍스트 프롬프트)만으로도 360° 기하 일관성과 사진급 고해상도 텍스처를 동시에 달성한다…
한 줄 요약 (TL;DR) STAND (STochastic Adaptive N-gram Drafting)은 추가 학습이나 별도 드래프트 모델 없이도 대규모 LLM의 테스트-타임 스케일링(Test-Time Scaling)을 가속한다. 표준 오토리그레시브 디코딩 대비 추론 지연을 60 \ 65 % 줄이고 처…
⚡️TL;DR KVzip는 LLM의 KV 캐시를 한 번 압축해도 이후 모든 질의 · 세션에서 재사용할 수 있도록 설계된 query-agnostic 캐시 컴프레서다. 그 결과 정확도 손실 ≤ 3 pp를 유지하면서 레이턴시 2 × ↓, 메모리 60–394 × ↓를 동시에 달성한다. 핵심 아이디어 “프리필은…
⚡️ REFORM: 100만 토큰도 잊지 않는 LLM 추론 파이프라인 한 줄 요약 (TL;DR) REFORM은 압축(Compress) → 선별(Gather) → 선택적 재계산(Recompute) 세 단계를 하나로 묶어, 단일 H100 GPU에서도 100 만 토큰 문맥을 망각 없이 다루고 추론 지연·메모리…
📝 Mamba Drafters: 선형 SSM으로 외부 Speculative Decoding SOTA 다시 쓰기 한 줄 요약 (TL;DR) Transformer 대신 Mamba SSM을 외부 드래프터로 쓰고, 트리 초안 + UCB 탐색을 결합해 재학습 없이도 Self-spec(EAGLE) 수준 속도·품질을…
Gemini 2.5: 1 M 토큰·멀티모달·초저지연 LLM의 비밀을 벗기다 한 줄 요약 (TL;DR) Sparse-MoE + Slice-Elastic TPU 학습 + Flash Distillation 덕분에, Gemini 2.5는 1 M 토큰 컨텍스트와 비디오·오디오까지 통합하면서도 코딩·수학·롱컨텍스트…
LLM 추론 가속화를 위한 비동기식 KV 캐시 프리페칭 논문 상세 분석 제공된 논문 "Accelerating LLM Inference Throughput via Asynchronous KV Cache Prefetching"은 대규모 언어 모델(LLM) 추론 시 발생하는 메모리 병목 현상을 해결하기 위한…
Hogwild! Inference 논문 심층 분석 제공해주신 "Hogwild! Inference: Parallel LLM Generation via Concurrent Attention" 논문을 자세히 분석하여 강점과 독창성, 핵심 알고리즘, 그리고 한계점을 설명해 드리겠습니다. 논문의 강점 및 독창적인…
MMInference 논문 리뷰: VLM의 긴 컨텍스트 추론, '순열'로 속도의 벽을 넘다 최근 Vision Language Model(VLM)은 이미지와 텍스트를 넘어 긴 비디오까지 이해하는 능력으로 무한한 가능성을 보여주고 있습니다. [cite\start]하지만 수백만 개의 토큰으로 이루어진 긴 비디…
가정용 기기로 700억 매개변수 LLM을 구동하다: prima.cpp 논문 심층 리뷰 최근 대규모 언어 모델(LLM)의 발전은 놀랍지만, 대부분의 강력한 모델은 막대한 자원을 갖춘 클라우드 데이터센터에서만 접근 가능했습니다. GPT-4, Claude 3.5와 같은 모델을 개인 기기에서 사용하는 것은 먼…
Slim Attention 논문 심층 분석 제공해주신 "Slim attention: cut your context memory in half without loss" 논문을 정독하고 요청하신 내용에 따라 상세하게 분석해 드리겠습니다. 논문의 강점 및 독창적인 지점 이 논문은 트랜스포머 모델의 오랜 골칫거…
MHA2MLA 논문 분석: 기존 LLM을 경제적으로 만드는 혁신 제출된 논문 "Towards Economical Inference: Enabling DeepSeek's Multi-Head Latent Attention in Any Transformer-based LLMS"는 기존의 대규모 언어 모델…
네, TransMLA 논문(arXiv:2502.07864v5)을 심도 있게 분석하여 강점과 독창성, 핵심 알고리즘, 그리고 한계점을 상세히 설명해 드리겠습니다. 논문의 강점과 독창성 TransMLA 논문은 기존의 대규모 언어 모델(LLM)이 가진 실질적인 문제, 즉 추론 시 발생하는 KV 캐시 병목 현상…
X-EcoMLA 논문 분석: 강점, 핵심 알고리즘, 한계점 "X-EcoMLA: Upcycling Pre-Trained Attention into MLA for Efficient and Extreme KV Compression" 논문은 기존의 대규모 언어 모델(LLM)이 가진 메모리 문제를 해결하기 위한…
"Bring-Your-Own-Model" 논문 상세 분석 요청하신 "A Bring-Your-Own-Model Approach for ML-Driven Storage Placement in Warehouse-Scale Computers" 논문을 심층적으로 분석하여 강점과 독창성, 핵심 알고리즘, 그리고 한…
이 논문("KNOW WHERE YOU'RE UNCERTAIN WHEN PLANNING WITH MULTIMODAL FOUNDATION MODELS: A FORMAL FRAMEWORK")은 로봇이 멀티모달 파운데이션 모델(시각과 언어를 함께 이해하는 모델)을 사용하여 계획을 수립할 때 발생하는 불확실성을…
논문 분석: REAL: 대규모 언어 모델의 효율적인 RLHF 훈련을 위한 매개변수 재할당 이 문서는 "REAL: Efficient RLHF Training of Large Language Models with Parameter Reallocation" 논문을 심층적으로 분석하여 논문의 핵심 강점과 독창성…
Rubick 논문 상세 분석: 강점, 핵심 알고리즘, 그리고 한계점 제공된 논문 "RUBICK: EXPLOITING JOB RECONFIGURABILITY FOR DEEP LEARNING CLUSTER SCHEDULING"에 대한 심층 분석 결과는 다음과 같습니다. 논문의 강점과 독창적인 지점…
AI 모델 공급망 공격에 대한 연구 논문 심층 분석 사용자께서 제공하신 "Supply-Chain Attacks in Machine Learning Frameworks" 논문은 머신러닝(ML) 시스템이 직면한 새로운 유형의 공급망 공격을 심도 있게 분석하고, ML 커뮤니티의 보안 인식 수준을 평가한 중요한…
제공해주신 논문 "Accelerating MoE Model Inference with Expert Sharding" (MOESHARD)에 대한 자세한 분석은 다음과 같습니다. 이 논문은 Mixture of Experts (MoE) 모델의 추론 속도를 높이기 위한 새로운 시스템인 MOESHARD를 제안합니…
FlexInfer 논문 상세 분석: 온디바이스 LLM 추론의 메모리 제약 극복 FlexInfer 논문 "FlexInfer: Breaking Memory Constraint via Flexible and Efficient Offloading for On-Device LLM Inference" [cite:…
ScaleFusion 논문 상세 분석: 고해상도 장편 비디오 생성을 위한 공간-시간 확산 트랜스포머의 확장 가능한 추론 ScaleFusion 논문 "SCALEFUSION: SCALABLE INFERENCE OF SPATIAL-TEMPORAL DIFFUSION TRANSFORMERS FOR…
이 SOLA 논문은 대규모 언어 모델(LLM) 서비스에서 서비스 수준 목표(SLO), 특히 첫 토큰까지의 시간(TTFT)과 출력 토큰당 시간(TPOT) 달성률을 최적화하기 위한 새로운 스케줄링 프레임워크를 제안합니다. 기존 시스템의 고정된 원칙에 따른 스케줄링 방식이 야기하는 TTFT와 TPOT 간의 지…
XGrammar 논문 상세 분석: 유연하고 효율적인 LLM 구조화 생성 엔진 제공해주신 논문 "XGrammar: Flexible and Efficient Structured Generation Engine for Large Language Models" [cite: 1]은 대규모 언어 모델(LLM)이…
DeepSeek-V3 논문 심층 분석: 확장성 문제 해결 및 AI 하드웨어 아키텍처에 대한 성찰 DeepSeek-AI에서 발표한 "DeepSeek-V3: 확장성 문제 해결 및 AI 하드웨어 아키텍처에 대한 성찰" 논문은 대규모 언어 모델(LLM)의 급격한 확장에 따른 현재 하드웨어 아키텍처의 한계를 분석…
Rodimus 논문 분석: 정확도-효율성 균형을 깨는 새로운 언어 모델 대규모 언어 모델(LLM)의 발전은 자연어 처리 분야에 혁신을 가져왔지만, 기존 소프트맥스 어텐션 메커니즘의 높은 연산 비용($\mathcal{O}(T)$ 복잡도)은 효율성 측면에서 한계로 지적되어 왔습니다. [cite: 2] 최근…
✅ 결론 요약 Qwen3의 정밀한 사전학습 덕분에 고성능을 보이나, 3bit 이하의 ultra-low-bit quantization에 매우 민감하여 기존 모델보다 성능 저하가 크다. 4bit 이상에서는 GPTQ와 AWQ가 최상의 trade-off를 제공하며, BiLLM은 1bit에서도 유의미한 결과를 보…
✅ 결론 요약 Gemini Embedding은 Google Gemini LLM에서 초기화된 범용 임베딩 모델로, MTEB(Multilingual) 기준 평균 +5.09 점의 성능 향상과 SOTA 달성을 기록하며 분류, 검색, 클러스터링 등 다양한 태스크에서 강력한 일반화 능력을 보여줍니다. 핵심 강점:…
✅ 결론 요약 Gemma 3는 장문 컨텍스트(최대 128K), 멀티모달 이미지 입력, 다국어 지원을 갖춘 1B\27B 오픈 모델 계열로, 효율적인 KV 캐시 설계와 향상된 distillation 및 RLHF 기반 후처리로 성능·메모리·활용성에서 매우 뛰어납니다. 특히 27B IT 모델은 Chatbot…
📌 결론 요약 논문 "MELODI: Exploring Memory Compression for Long Contexts"는 Transformer의 긴 문맥 처리 문제를 해결하기 위해 계층적 메모리 압축(hierarchical memory compression) 구조를 제안합니다. 핵심은 다층 반복 압축…
📌 결론 요약 논문 ‘Seesaw: High-throughput LLM Inference via Model Re-sharding’은 LLM의 두 주요 단계인 prefill과 decode에서 병렬화 전략을 동적으로 변경하는 ‘model re-sharding’ 기법을 제안하여, 평균 1.36배, 최대…
✅ 결론 요약 (핵심 강점 및 독창성) Seedream 2.0은 중국어와 영어 모두를 native하게 이해하고 시각화하는 최초 수준의 이중언어 텍스트-이미지 생성 모델이다. 주요 강점은 다음과 같다: 🔍 핵심 알고리즘 및 전체 파이프라인 (예시 기반 설명) 입력 프롬프트 예시: 전체 파이프라인 흐름 핵심…
MoE 추론의 패딩·마스크 비용을 줄이는 dynamic gating과 expert buffering, 부하 균형을 살펴봅니다. 처리량과 메모리 감소의 측정 조건을 구분합니다.
논문 "Comet: Fine-grained Computation-communication Overlapping for Mixture-of-Experts"는 MoE 모델의 핵심 병목인 GPU 간 통신 지연을 fine-grained 수준에서 컴퓨팅과 통신을 정교하게 겹치도록 설계함으로써 실행 성능을 크게 개…
📌 결론 요약 (핵심 기여 및 성능) MegaScale-Infer는 대규모 Mixture-of-Experts (MoE) 모델 서빙을 위한 효율적 시스템으로, Attention과 FFN 모듈을 분리(disaggregate) 하여 GPU 활용률을 극대화하고 최대 1.9×의 GPU throughput 개선 및…
논문 「SwitchHead: Accelerating Transformers with Mixture-of-Experts Attention」을 매우 자세하게 읽고 분석한 내용을 바탕으로, 논문의 강점과 독창적인 지점, 핵심 알고리즘의 상세한 설명과 함께 예시 입력을 이용한 동작 과정을 소개하고, 마지막으로…
📌 결론 요약 논문 "Duplex: A Device for Large Language Models with Mixture of Experts, Grouped Query Attention, and Continuous Batching"은 저연산량(Op/B)이 지배적인 MoE 및 GQA 기반 LLM 추론을 위…
논문 『Mirage: A Multi-Level Superoptimizer for Tensor Programs』를 자세히 분석한 내용을 정리하여 설명합니다. 📌 결론 압축 정리 『Mirage』는 GPU에서 실행되는 텐서 프로그램을 위한 최초의 다계층 슈퍼 옵티마이저로, 커널(kernel), 블록…
✅ 결론 요약 (핵심 강점, 독창성, 핵심 메커니즘) MoEUT는 Universal Transformer(UT)의 구조적 강점(레이어 파라미터 공유 기반의 recurrence)을 유지하면서도 기존 한계였던 parameter-compute ratio 문제를 해결한 구조다. 핵심은 다음 세 가지다:…
📌 논문 요약 및 분석 (FlexAttention: A Programming Model for Generating Optimized Attention Kernels) ✅ 논문의 강점 및 독창적인 지점 유연성 (Flexibility) 기존의 FlashAttention과 달리, FlexAttention은 다…
논문 『LeanAttention: Hardware-Aware Scalable Attention Mechanism for the Decode-Phase of Transformers』에 대한 상세한 분석을 다음과 같이 제시합니다. ✅ 결론 (요약) 이 논문은 Transformer 모델의 디코딩 단계에서 긴…
논문 『AIOpsLab: A Holistic Framework to Evaluate AI Agents for Enabling Autonomous Clouds』를 매우 상세히 분석한 결과, 다음과 같은 핵심 사항과 독창적 특징을 확인할 수 있었습니다. 📌 요약된 결론 (핵심 강점 및 독창성)…
논문 『SparseTransX: Efficient Training of Translation-Based Knowledge Graph Embeddings Using Sparse Matrix Operations』의 강점, 독창적인 지점, 핵심 알고리즘의 예시와 전체적인 과정, 그리고 한계점을 정리하여 전달드…
📌 논문 제목: NEO: Saving GPU Memory Crisis with CPU Offloading for Online LLM Inference 📌 저자: Xuanlin Jiang, Yang Zhou, Shiyi Cao, Ion Stoica, Minlan Yu 1. 결론 요약 (강점 & 독창적인 지…
논문『PipeFill: Using GPUs During Bubbles in Pipeline-parallel LLM Training』의 핵심 내용을 상세히 분석하여, 논문의 강점, 독창적인 지점, 핵심 알고리즘의 전체적인 과정 및 한계점을 요약하였습니다. 📌 결론 (요약) 『PipeFill』은 파이프라인…
논문의 핵심을 정리하여 결론부터 간략히 제시한 후, 구체적인 수치를 통해 강점 및 독창적인 지점을 설명하고, 논문에서 제안한 핵심 알고리즘을 예시와 함께 설명하며, 논문의 한계점을 논의하겠습니다. 📌 논문의 요약된 결론: 이 논문은 구조적 프루닝(structured pruning)을 수행한 대형 언어 모…
✅ 결론 요약 이 논문은 "메모리 용량을 초과하는 대규모 데이터셋에서 대표적인 subset을 효율적으로 선택"하는 문제를 다룬다. 기존 방법들은 중앙 서버가 전체 subset을 메모리에 올릴 수 있어야 한다는 제약이 있었지만, 이 논문은 중앙 서버 없이도 분산 환경에서 고품질 subset을 선택할 수 있…
✅ 결론 요약 SampleAttention은 기존 LLM의 attention을 거의 정확도 손실 없이 대체하면서, 최대 2.42배 TTFT(Time-to-First-Token) 지연을 줄이는 구조화된 adaptive sparse attention 기법이다. 핵심은 두 가지 sparse 패턴인 local…
✅ 결론 요약 이 논문은 초장문(long-context) LLM을 저렴한 하드웨어(예: 4 GPU) 상에서 효율적으로 훈련할 수 있게 하는 FPDT (Fully Pipelined Distributed Transformer) 구조를 제안함. 기존 대비 최대 16배 더 긴 시퀀스(예: 2M tokens)를…
논문의 강점과 독창적인 지점 1. 강점 저비트 정량화(Quantization)의 실용적 개선: 기존 INT4 정량화 기법들이 클라우드 기반 LLM 서빙에서 성능 개선을 보이지 못하는 문제를 해결. QoQ(W4A8KV4) 알고리즘 제안: 4비트 가중치(W4), 8비트 활성화(A8), 4비트 KV 캐시…
논문의 강점과 독창적인 지점 이 논문은 연합 학습(Federated Learning, FL)의 리소스 관리 문제를 다루며, 특히 다수의 FL 작업이 동일한 디바이스 풀에서 실행될 때 발생하는 자원 경쟁(Resource Contention) 을 해결하는 Venn이라는 새로운 리소스 관리 시스템을 제안합니다…
논문『AI Metropolis: Scaling Large Language Model-based Multi-Agent Simulation with Out-of-order Execution』의 주요 강점과 독창적인 지점, 핵심 알고리즘 및 한계점을 압축하여 설명하면 다음과 같습니다. 📌 결론 (요약) 강점…
논문의 핵심 내용을 요약하면 다음과 같습니다. 결론 요약 이 논문은 파이프라인 병렬화(Pipeline Parallelism, PP)를 사용하는 Transformer 모델 학습 시, 입력 및 출력 Embedding 레이어의 연산과 메모리 불균형 문제를 해결하기 위한 ‘Vocabulary…
논문의 핵심 요약 및 기여 DIFFSERVE는 query-aware model scaling 개념을 도입하여 Text-to-Image Diffusion Model의 효율적인 서빙을 가능하게 하는 시스템이다. 기존 서빙 시스템이 모든 요청에 대해 동일한 크기의 모델을 사용하는 반면, DIFFSERVE는 입…
SwiGLU MLP의 입력을 동적으로 고르고, DRAM에 있는 가중치를 재사용하는 DIP를 설명합니다. 시뮬레이션 결과와 행렬곱 계산 예시의 조건을 구분합니다.
논문의 핵심 요약 및 평가 논문 제목: Marconi: Prefix Caching for the Era of Hybrid LLMs 핵심 기여: Marconi는 Hybrid LLM(Attention + State Space Model, SSM)에서 효율적인 Prefix Caching을 지원하는 최초의 시스…
논문의 강점과 독창성 강점 기존 VM 스케줄링 방식보다 높은 효율성 기존의 One-shot 예측 방식(예: Lifetime Alignment, LA)보다 높은 정확도를 가지는 재예측(Reprediction) 기법을 활용. 예측 오류를 지속적으로 수정하여 리소스 활용도를 향상함. 실 서비스(Google의…
논문 『TurboAttention: Efficient Attention Approximation for High Throughputs LLMs』는 기존의 Attention 연산의 속도와 메모리 효율성을 동시에 개선한 통합적인 접근 방법을 제안하고 있으며, 이는 두 가지 핵심 알고리즘인 FlashQ와…
논문의 강점 및 독창적인 지점 이 논문은 대규모 데이터 센터에서 기계 학습(ML)을 활용한 저장소 배치(Storage Placement) 문제를 다루며, 기존 접근법의 한계를 극복하기 위해 크로스-레이어(Cross-Layer) 접근 방식을 제안했다. 주요 강점과 독창적인 점은 다음과 같다. 기존 단일 계…
본 논문은 JaxPP라는 시스템을 제안하여, 기존의 Single-Program Multiple-Data (SPMD) 방식의 한계를 극복하고 Multiple-Program Multiple-Data (MPMD) 파이프라인 병렬화를 통해 대규모 딥러닝 모델 학습의 확장성과 성능을 향상한 연구이다. 특히,…
논문의 핵심 내용을 먼저 간략히 요약한 후, 강점과 독창적인 지점을 자세히 설명하고, 핵심 알고리즘의 동작 원리를 예시와 함께 제시한 뒤, 논문의 한계점을 마지막으로 정리하겠습니다. 🔑 논문의 핵심 내용 요약 이 논문은 긴 시퀀스를 처리하는 Large Language Model(LLM) 서빙 시스템에서…
논문 『ThunderServe: High-performance and Cost-efficient LLM Serving in Cloud Environments』를 상세히 분석하여 다음과 같은 내용을 압축적으로 정리하였다. 📌 논문의 결론 요약 이 논문은 클라우드 환경에서 다양한 유형의 GPU를 사용하여…
논문 『VoLUT: Efficient Volumetric Streaming Enhanced by LUT-based Super-resolution』을 분석하여 핵심 사항을 아래와 같이 압축하여 전달하고, 강점과 독창성, 알고리즘의 동작 과정, 한계점을 차례로 제시합니다. 📌 결론 압축 요약: 본 논문은…
논문의 핵심 요약 및 기여점 논문 제목: Bridging the Safety Gap: A Guardrail Pipeline for Trustworthy LLM Inferences 핵심 내용: 이 논문은 Wildflare GuardRail이라는 프레임워크를 제안하여 대형 언어 모델(LLM)의 안전성과 신뢰…
논문의 핵심 내용 요약 및 강점 이 논문은 Model Folding이라는 새로운 데이터 프리 모델 압축 기법을 제안한다. 기존의 압축 방법(가지치기, 양자화)과 달리, Model Folding은 층(layer) 간 유사한 뉴런을 병합하여 모델 크기를 줄인다. 특히, 데이터 없이(data-free), 파인…
논문의 핵심 요약 이 논문은 Dynamic Diffusion Transformer (DyDiT)라는 새로운 모델을 제안하며, 기존 Diffusion Transformer (DiT)의 과도한 연산량 문제를 해결하는 것을 목표로 한다. DyDiT는 시간축(Timestep)과 공간축(Spatial)에서 동적으…
논문의 핵심 요약 및 기여점 이 논문은 HEXGEN-2라는 새로운 분산 LLM(대형 언어 모델) 추론 시스템을 제안합니다. 기존 동질적인 고성능 GPU 클러스터를 이용하는 방식과 달리, 이기종 GPU 환경에서 Prefill(입력 처리)과 Decoding(출력 생성) 단계를 분리(disaggregated…
논문의 강점과 독창적인 지점 이 논문의 핵심 기여는 Collaborative Speculative Decoding (CoSD) 알고리즘을 제안하여, 훈련 없이도 여러 LLM의 지식을 효과적으로 융합하는 방법을 제시한 점이다. CoSD의 강점은 다음과 같다. 효율적인 테스트 타임(추론 시점) 모델 융합 기…
논문의 핵심 요약 이 논문은 PruneNet이라는 새로운 모델 압축 기법을 제안하며, 기존 방법들의 한계를 극복하고자 한다. 주요 기여점은 다음과 같다: Calibration-Free Pruning: 기존 모델 프루닝 기법들은 보정 데이터(calibration dataset)에 의존하는 반면,…
논문의 핵심 요약 논문 "FLASHMASK: Efficient and Rich Mask Extension of FlashAttention"는 기존 FlashAttention이 지원하는 마스크 타입을 확장하고, 메모리 복잡도를 O(N²)에서 O(N)으로 줄이면서 성능을 향상시킨 새로운 column-wise…
논문의 강점과 독창적인 지점 강점 다양한 추론 방식의 활용 기존 LLM(대형 언어 모델)의 한계를 극복하기 위해 연역(deductive), 귀납(inductive), 가설(abductive), 유추(analogical) 네 가지의 논리적 추론 방식을 적용함. 각각의 추론 방식이 특정 유형의 문제에서 효과…
논문의 강점 및 독창적인 지점 1. 기존 Sequence Parallelism (SP)의 한계 개선 기존 SP 기법(LASP-1, Ring Attention 등)은 Right-product-first 특징을 제대로 활용하지 못하고, 링 스타일(Ring-style) 통신 방식을 사용해 통신-연산 병렬성이…
논문의 주요 강점과 독창적인 지점 BitsAI-CR는 대규모 산업 환경에서 코드 리뷰를 자동화하기 위해 설계된 LLM 기반 코드 리뷰 시스템으로, 기존 솔루션이 가진 문제(정확성 부족, 실용성 부족, 지속적인 개선 부족)를 해결하는 데 초점을 맞추고 있음. 주요 강점 • 정확성 향상: • 기존 LLM 기…
논문의 핵심 요약 이 논문은 RoSeMary라는 새로운 코드 워터마킹 프레임워크를 제안한다. 기존의 코드 워터마킹 기법들이 검출 가능성(detectability), 충실도(fidelity), 그리고 강건성(robustness) 간의 균형을 맞추지 못하거나, 서명을 검증하는 과정에서 보안 문제가 발생하는…
논문 요약 및 분석: SmolLM2 - When Smol Goes Big 논문의 핵심 기여 논문은 1.7B(17억) 파라미터 규모의 소형 언어 모델 SmolLM2를 제안하며, 성능을 최적화하기 위해 데이터 중심적 접근법을 활용함. 11조 개 토큰을 사용한 다단계 학습을 통해 기존 소형 모델보다 뛰어난 성…
논문의 강점과 독창성 1. 순수 강화학습 기반 모델 개발: DeepSeek-R1-Zero는 Supervised Fine-Tuning (SFT) 없이 순수 강화학습(RL) 만으로 훈련된 최초의 공개 연구 모델입니다. 기존의 LLM 개발이 대부분 대규모 감독 데이터에 의존했던 것과는 다르게, 이 모델은 RL…
논문 개요 및 강점 논문 제목: DeepSeek-VL2: Mixture-of-Experts Vision-Language Models for Advanced Multimodal Understanding 강점 및 독창성: 동적 타일링 전략 (Dynamic Tiling Strategy): 기존…
논문의 강점 및 독창적인 지점 문제 인식 및 대응: 이 논문은 기존 벤치마크(MMLU 등)가 LLM(대형 언어 모델)에 의해 거의 90% 이상의 정확도를 기록하며 포화 상태에 도달한 문제를 지적하고 있습니다. 이를 해결하기 위해 Humanity's Last Exam (HLE)이라는 새로운 벤치마크를 제안…
논문의 개요 및 강점 Qwen2.5-1M은 Alibaba Group의 Qwen 팀이 개발한 초장문 컨텍스트 지원 대규모 언어 모델 시리즈입니다. 이 모델은 기존 128K 토큰에서 1백만 토큰으로 컨텍스트 길이를 확장했으며, 이를 통해 코드 작성, 문서 요약, 복잡한 질의 응답 등의 작업에서 탁월한 성능을…
논문의 개요 및 강점 논문 제목: DeepSeek-Coder-V2: Breaking the Barrier of Closed-Source Models in Code Intelligence DeepSeek-Coder-V2는 오픈소스 코드 언어 모델로서 GPT-4 Turbo, Claude 3 Opus,…
논문의 강점과 독창적인 지점 동적 해상도 처리 (Naive Dynamic Resolution): Qwen2-VL은 고정된 해상도에서 이미지를 처리하는 기존 LVLM과 달리, 다양한 해상도의 이미지를 동적으로 처리할 수 있는 메커니즘을 도입했습니다. 이를 통해 고해상도 이미지의 세부 정보를 보존하며,…
논문의 강점 및 독창성 강화 학습과 증명 보조기 피드백의 통합 DeepSeek-Prover-V1.5는 증명 보조기(Lean 4)의 피드백을 활용한 강화 학습(RLPAF)을 통해 모델의 성능을 개선했습니다. 기존 모델들은 단순한 감독 학습에 의존했으나, 이 모델은 증명 검증 결과를 직접적으로 학습에 반영함…
논문의 강점 및 독창성 논문 제목: Let the Expert Stick to His Last: Expert-Specialized Fine-Tuning for Sparse Architectural Large Language Models 강점 Sparse Architecture LLM에 대한 최초의 체계적…
논문의 주요 강점 및 독창성 모델 성능 향상: Qwen2 시리즈는 이전 버전인 Qwen1.5와 비교해 대부분의 벤치마크에서 우수한 성능을 보입니다. 특히 Qwen2-72B 모델은 MMLU(84.2), GPQA(37.9), HumanEval(64.6), GSM8K(89.5), BBH(82.4) 등에서 두각…
논문의 강점 및 독창적인 지점 대규모 합성 데이터 생성 • 8백만 개의 Lean 4 공식 수식 및 증명을 생성하여 대규모 데이터 부족 문제를 해결했습니다. • 고등학생 및 대학생 수준의 수학 대회 문제를 활용하여 자연어 문제를 공식화하고, 불필요하거나 오류가 있는 수식을 제거하는 자동화된 품질 관리 시스…
논문의 강점과 독창적인 지점 DeepSeek-VL은 현실 세계의 비전-언어 이해를 목표로 한 오픈 소스 멀티모달 모델로, 1.3B와 7B 크기의 모델을 제공합니다. 이 모델의 강점과 독창성은 다음과 같습니다: 현실적인 데이터 구성: • 웹 스크린샷, PDF, OCR 데이터, 차트, 전문가 지식 및 교과서…
논문 개요: “How to Train Data-Efficient LLMs” 이 논문은 대규모 언어 모델(LLM) 훈련의 높은 비용 문제를 해결하기 위해 데이터 효율적 사전 훈련 방법론을 탐구합니다. 저자들은 데이터 품질 및 커버리지 기반 샘플링 기법을 활용하여 모델 성능과 훈련 자원 소모 사이의 최적 균…
논문 요약: “DeepSeek-Coder: When the Large Language Model Meets Programming - The Rise of Code Intelligence” 논문의 강점 및 독창성 강점: 오픈 소스 코드 모델: DeepSeek-Coder 시리즈는 1.3B부터 33B까지 다양…
논문의 개요 및 강점 논문 제목: DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models 저자: Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song 외.…
논문의 강점과 독창적인 지점 논문 "DeepSeek LLM: Scaling Open-Source Language Models with Longtermism" 은 대규모 오픈소스 언어 모델 개발과 스케일링 법칙(scaling laws)에 대한 연구를 다루고 있습니다. 주요 강점과 독창적인 지점을 정리하면…
논문 요약 및 핵심 내용 이 논문 "Qwen-Audio: Advancing Universal Audio Understanding via Unified Large-Scale Audio-Language Models"에서는 다양한 오디오 유형과 태스크를 다룰 수 있는 대규모 오디오-언어 모델…
논문의 강점 및 독창적인 지점 강점 요약: 다양한 모델 시리즈 제공: Qwen 시리즈는 기본 LLM뿐만 아니라 대화형 모델(Qwen-Chat), 코드 생성(Code-Qwen), 수학 문제 해결(Math-Qwen) 등 다양한 특화 모델을 제공함. 우수한 성능: 오픈 소스 모델 중 최상위 성능을 기록하며,…
논문의 핵심 요약 및 평가 1. 논문의 강점과 독창적인 지점 이 논문은 Qwen-VL 시리즈라는 대규모 Vision-Language Model (LVLM) 을 소개하며, 기존 모델 대비 다양한 시각적 이해 및 언어적 응용 능력을 향상시킨 것이 핵심이다. 다음과 같은 주요 강점과 차별점이 있다: 2. 핵심…
논문 요약 및 분석: Janus - Decoupling Visual Encoding for Unified Multimodal Understanding and Generation 1. 연구의 주요 기여 Janus는 멀티모달 이해(Understanding)와 생성(Generation)을 통합한 자율회귀…
논문의 강점 및 독창적인 지점 빠르고 정확한 하드웨어 평가 프레임워크 (LLMCompass) 제공 기존의 Roofline 모델이 빠르지만 부정확하고, 사이클 수준의 시뮬레이션이 정확하지만 느린 단점을 보완. 평균 10.4%의 연산자 오류율과 LLM 추론에 대한 4.1%의 오류율을 기록하며 빠른 평가 가능…
논문의 강점과 독창적인 지점 압축된 컨텍스트 메모리(CCM) 도입: 온라인 언어 모델 추론 시 지속적으로 증가하는 컨텍스트를 압축하여, 기존보다 5배 적은 메모리로 유사한 성능을 달성. 슬라이딩 윈도우 방식보다 뛰어난 성능을 발휘하며, 무제한 길이의 스트리밍 설정에서도 효과적임. 경량 LoRA(LoRA:…
논문의 강점 및 독창성 강점 효율적인 상태 복원 기술 (HCache) 제안 기존 KV 캐시 오프로드 및 토큰 재계산 방법 대비, 최대 5.73배 빠른 TTFT(Time To First Token) 및 1.92-2.40배 적은 저장 공간을 요구하여 실질적인 성능 향상을 입증함. IO 및 연산 자원을 동시에…
논문의 강점 및 독창적인 지점 강점: 확장된 데이터 스케일링: Qwen2.5는 이전 버전보다 크게 확장된 18조 토큰의 데이터로 사전 학습됨. 이는 상식, 전문가 지식, 추론 능력을 강화하여 여러 도메인에서 뛰어난 성능을 발휘. 다양한 모델 크기 및 최적화: 0.5B에서 72B까지 다양한 모델 크기를 제…
논문의 강점과 독창적인 지점 AIOS 시스템의 혁신성: 이 논문은 대형 언어 모델(LLM) 기반의 지능형 에이전트들을 위한 새로운 운영 체제, AIOS (LLM Agent Operating System)를 제안합니다. 기존의 에이전트 시스템들은 자원 관리의 비효율성 및 잠재적인 보안 문제에 직면했으나,…
논문의 강점과 독창적인 지점 적응형 KV 캐시 압축 기법 (DynamicKV) 기존의 고정 패턴 기반 KV 캐시 압축 방식(예: PyramidKV, SnapKV 등)과 달리, DynamicKV는 각 작업의 특성을 고려하여 레이어별로 최적의 토큰 보존 크기를 동적으로 조정. 특정 레이어에서만 필요한 정보의…
논문의 강점과 독창적인 지점 학습 기반의 Attention 희소성 활용: SeerAttention의 주요 혁신은 사전 정의된 희소성 패턴이 아닌 학습 가능한 게이트(AttnGate)를 사용하여 attention 희소성을 학습한다는 점입니다. 기존의 방법들은 고정된 희소성 구성을 사용했으나, 이는 다양한…
논문 요약 이 논문은 Taipan이라는 새로운 하이브리드 모델을 제시합니다. Taipan은 Mamba-2와 Selective Attention Layers(SALs)를 결합하여 긴 문맥을 효과적으로 처리하면서도 계산 효율성을 유지하는 모델입니다. 주요 아이디어는 모든 토큰에 대해 동일한 계산 자원을 할당…
논문의 강점 및 독창성 강점: 양방향 P2P 통신 활용: 기존 Ring-Attention의 단방향 통신 한계를 극복하고, Query(Q)와 block output을 동시에 전송함으로써 통신 지연을 줄이고 계산-통신 중첩을 증가시킴. 통신 오버헤드 감소: 블록 기반으로 QKV 텐서를 토큰 차원에서 GPU에…
논문의 강점, 독창적 지점, 그리고 핵심 내용 강점: 효율성과 고해상도: Sana는 최대 4096x4096 해상도의 이미지를 효율적으로 생성하며, 경쟁 모델 대비 최대 100배 이상의 처리량을 제공합니다. 경량화된 모델: Sana-0.6B는 0.6B 파라미터로 FLUX(12B)와 유사한 성능을 내면서도,…
논문의 강점과 독창적 지점 강점: 효율적 성능 개선: Block Transformer는 기존 Transformer의 가장 큰 병목 현상인 Key-Value(KV) 캐시 관련 I/O 부담을 크게 완화하여, 최대 1020배 높은 추론 처리량을 달성합니다. 효율적인 글로벌-로컬 구조: 하위 계층은 글로벌 문맥…
논문의 강점, 독창성, 핵심 알고리즘 설명, 그리고 한계점 분석 강점 및 독창성 문제 인식과 해결: 기존 LLM(대형 언어 모델)의 정렬 과정이 환각(사실과 다른 정보 생성)을 증가시킬 수 있음을 지적하며, 이를 해결하기 위한 FLAME(Factuality-Aware Alignment) 접근법을 제안.…
논문 요약 및 분석 MobiLlama: Towards Accurate and Lightweight Fully Transparent GPT 핵심 내용 MobiLlama는 소규모 언어 모델(SLM) 개발을 목표로 설계된 0.5B 파라미터 모델입니다. 주요 특징은 다음과 같습니다: 효율성: 모든…
요약 및 강점 논문 "Rethinking Optimization and Architecture for Tiny Language Models"은 경량 언어 모델(LM)을 모바일 디바이스에서도 실행 가능하도록 최적화하는 데 초점을 맞춥니다. 이를 위해 신경망 아키텍처 설계, 파라미터 초기화, 최적화 전략에…
결론 요약 논문 "Cascade Speculative Drafting for Even Faster LLM Inference"는 대형 언어 모델(LLM)의 추론 속도를 향상시키기 위해 제안된 CS Drafting 알고리즘을 다룹니다. 이는 기존의 Speculative Decoding의 성능을 개선하여 최대…
논문의 강점과 독창적인 지점 독창적인 분산 시스템 설계: 이 논문은 분산된 신뢰성이 낮은 기기들로 대규모 언어 모델(50B+ 파라미터)을 실행하기 위한 결함 허용 알고리즘을 제안합니다. 이는 기존의 고성능 서버에 의존하지 않고, 일반 사용자 장비를 활용하여 LLM을 실행할 수 있도록 설계되었습니다.…
논문의 주요 강점과 독창성 효율적인 대규모 LLM 훈련 및 추론: EE-LLM은 Early-Exit LLM의 대규모 훈련 및 추론을 지원하는 첫 번째 프레임워크 중 하나로, 3D 병렬 처리를 기반으로 설계되어 대규모 모델 훈련에서 높은 효율성을 제공합니다. Early-Exit 층을 추가하면서도 훈련 시간…
결론 요약 이 논문은 Gated Linear Attention Transformer (GLA Transformer)라는 새로운 변형을 제안하며, 이를 통해 기존의 Linear Attention의 한계를 극복하고 하드웨어 효율성을 크게 개선했습니다. 특히, FLASHLINEARATTENTION 알고리즘을…
논문의 주요 내용 및 독창성 이 논문은 대용량 언어 모델(LLM)을 제한된 DRAM 환경에서도 효과적으로 실행할 수 있는 방법을 제안합니다. 이 방법은 플래시 메모리를 사용해 모델 파라미터를 저장하고, 필요할 때 DRAM으로 불러오는 구조를 제안하며, 다음과 같은 주요 기법들을 포함합니다:…
논문의 강점, 독창성, 핵심 알고리즘, 그리고 한계점 결론 요약 이 논문은 대규모 언어 모델(LLM)을 엣지 디바이스에서 효과적으로 실행하기 위한 새로운 양자화 프레임워크인 Agile-Quant을 제안합니다. 기존의 가중치 중심 양자화와 달리, 활성화 값까지 4비트 정밀도로 양자화하여 성능 손실 없이 최…
논문의 강점과 독창적인 지점 강점: 강화 학습 기반 정렬: "Sparrow"는 인간 피드백을 활용한 강화 학습(RLHF)을 통해 규칙 기반 평가와 선호도 평가를 결합하여 높은 수준의 성능을 달성함. 모델의 응답 선호도가 향상되는 동시에 규칙 위반율이 8%로 낮아짐. 증거 기반 응답: 질문에 대한 응답 시…
논문의 강점 및 독창적인 지점 일반 목적 인터페이스 모델(METALM): METALM은 다양한 기초 모델(언어, 시각, 멀티모달)을 연결하는 일반 목적 인터페이스로 설계되었습니다. 비인과적(양방향) 인코더와 인과적(단방향) 디코더를 결합한 반-인과적 학습 목표를 도입하여 기존 모델의 장점을 통합했습니다.…
논문의 강점과 독창적인 지점 논문 "OPT: Open Pre-trained Transformer Language Models"는 다음과 같은 강점과 독창적인 지점을 지니고 있습니다. 효율적인 학습: OPT-175B는 GPT-3과 성능이 유사하지만, 훈련 과정에서 약 1/7의 탄소 배출로 동일한 규모의 모…
논문 요약 및 강점, 독창성, 한계점 분석 요약 "SparQ Attention: Bandwidth-Efficient LLM Inference" 논문은 대형 언어 모델(LLM) 추론 시 발생하는 메모리 대역폭 병목 현상을 해결하기 위한 SparQ Attention 기법을 제안합니다. 이 기법은…
결론 및 주요 결과 논문 "CBQ: Cross-Block Quantization for Large Language Models"의 주요 기여와 성과를 요약하면 다음과 같습니다: 강점 및 독창성: Cross-Block Dependency (CBD): 기존 Block 기반 PTQ(Post-Training…
강점 및 독창적인 지점 이 논문은 Shifted Cross Chunk Attention(SCCA)와 Shifted Dilated Attention(SDA)를 도입하여 긴 문맥을 효율적으로 처리하는 데 초점을 둡니다. 주요 강점은 다음과 같습니다: 효율성: 기존 sparse attention 패턴의 한계를…
논문의 강점과 독창적인 지점 메모리 효율성: GaLore는 Gradient Low-Rank Projection이라는 독창적인 방식을 통해 기존의 Low-Rank Adaptation (LoRA)보다 메모리 효율성을 크게 개선하였습니다. 특히, Optimizer 상태 메모리를 최대 65.5% 감소시키고,…
논문의 주요 강점 및 독창성 초대형 컨텍스트 처리: Gemini 1.5는 텍스트, 비디오, 오디오 등 다양한 모달리티에서 최대 1천만 토큰을 처리할 수 있어 기존 모델(GPT-4 Turbo: 128k 토큰, Claude 3.0: 200k 토큰) 대비 큰 도약을 이뤘습니다. 이는 긴 문서나 비디오 등 복잡…
논문의 요약 논문은 Google DeepMind에서 개발한 Gemma 모델에 대해 다루고 있으며, 이는 기존 Gemini 모델의 연구와 기술에 기반한 경량 언어 모델입니다. 이 모델은 2B와 7B 파라미터로 제공되며, 다음과 같은 주요 기여를 포함합니다: 성능 우위: 유사한 크기의 공개 모델을 대상으로…
논문의 강점 및 독창성 1. 주요 기여점: LayerSkip 방법: 이 논문은 Layer Dropout과 Early Exit Loss를 통합하여 모델의 계산량을 줄이면서도 성능 저하를 최소화하는 혁신적인 방법을 제안합니다. Layer Dropout: 초기 레이어의 dropout 비율은 낮고, 마지막 레이…
논문의 강점 및 독창적인 지점 핵심 요약: 이 논문은 Transformer 기반 대형 언어 모델(LLM)의 특정 층에서 랭크 감소(LASER) 기법을 통해 성능을 개선할 수 있음을 발견했습니다. 특히, 훈련이 끝난 모델에 적용 가능한 후처리 방법으로, 특정 층의 고차 요소(작은 특이값에 해당하는 성분)를…
요약 논문 "Gemma 2: Improving Open Language Models at a Practical Size"은 Google DeepMind의 Gemma 2 모델을 소개합니다. 이 모델은 경량 모델로서, 2억27억 파라미터 크기의 다양한 버전으로 제공되며, 다음과 같은 주요 기술적 기여와 혁신…
Mooncake: A KVCache-Centric Disaggregated Architecture for LLM Serving 강점과 독창적인 지점 KVCache 중심의 분리 아키텍처: Mooncake는 LLM의 prefill과 decoding 단계를 분리하여 GPU, CPU, DRAM, SSD의 리소스…
논문의 강점 및 독창적인 지점 효율적이고 정확한 INT8 양자화 기반 주의 메커니즘(SageAttention): SageAttention은 INT8 양자화를 적용하여 기존 FlashAttention2 및 xformers보다 약 2.1배, 2.7배 빠른 성능을 제공합니다. 이는 효율성과 정확성을 모두 확보…
논문의 강점, 독창성, 핵심 알고리즘, 그리고 한계점 요약 결론 요약 이 논문은 Meta의 최신 언어 모델 Llama 3의 개발, 구조, 학습, 성능 평가, 그리고 안전성을 다룹니다. 405B 매개변수를 가지며 128K 토큰의 긴 문맥 처리, 멀티모달 확장, 다국어 지원, 툴 사용을 기본적으로 지원하는…
강점과 독창성 강력한 이론적 연결: 논문은 Transformer와 Structured State Space Models(SSMs)을 연결하는 "State Space Duality" (SSD)를 제안했습니다. 이는 SSM을 Attention 기반 모델의 한 변형으로 새롭게 해석할 수 있게 하며, 이를 통해…
논문의 강점 및 독창성 이 논문은 대규모 언어 모델(LLM)의 Tensor Parallel 전략에서 발생하는 통신 병목 현상을 해결하기 위해 정교한 양자화 기술을 사용하여 통신 압축을 제안한 점에서 독창적입니다. 주요 강점은 다음과 같습니다: 효율적인 통신 압축: 부분 결과를 양자화하여 3.54.5배 데…
강점 및 독창적 기여 이 논문은 Context Parallelism (CP)라는 기법을 통해 대규모 언어 모델(LLM)에서의 긴 문맥 길이(최대 1M 토큰) 추론 효율성을 대폭 향상시키는 방법을 제안합니다. 주요 강점과 독창적인 기여는 다음과 같습니다: 긴 문맥 길이에서의 추론 효율성: 기존의 방법보다…
결론 요약 논문 "FastAttention: Extend FlashAttention2 to NPUs and Low-resource GPUs for Efficient Inference"은 FlashAttention 시리즈의 성능을 NPU와 저자원 GPU로 확장하며, 초저자원 환경에서 Transformer…
\ 논문의 요약 및 강점 논문의 제목: SimpleFSDP: Simpler Fully Sharded Data Parallel with torch.compile 핵심 요약: SimpleFSDP는 PyTorch-native compiler 기반의 Fully Sharded Data Parallel (FSDP)…
논문 요약: ClusterKV: Semantic Space에서 KV Cache를 관리하는 효율적인 압축 기법 주요 강점과 독창적인 점 • 효율성과 정확성의 균형: • 기존 방식인 “비-회수 가능 KV 압축” 및 “페이지 단위 회수”는 정확성 및 자원 효율성을 저하시켰으나, ClusterKV는 토큰의 의미…
논문의 핵심 요약 이 논문은 대형 언어 모델(LLM) 추론 시 CPU-GPU 간의 데이터 전송 병목 현상을 해결하기 위해 I/O를 고려한 부분 KV 캐시 재계산 기법을 제안합니다. 기존의 GPU 메모리 부족 문제를 CPU 메모리로 오프로드하여 해결하려는 접근법의 단점을 보완하며, GPU 계산과 PCIe…
요약 및 주요 내용 논문의 주된 기여점: • 기존 LLM이 단어 수준의 예측에 의존하는 데 비해, Large Concept Model (LCM)은 문장 수준에서 “개념”으로 정의된 고차원의 임베딩 공간에서 작동함. • 모델링이 특정 언어 또는 모달리티에 국한되지 않고 더 높은 수준의 추상적 의미 표현을…
논문의 강점 및 독창성 효율성 증가: • SageAttention2는 4비트 정밀도(INT4)와 FP8(8비트 부동소수점)을 활용하여 기존 FlashAttention2 대비 약 3.1배 빠른 연산 속도를 제공함. • RTX4090에서 최대 485 TOPS 성능을 달성하며, FlashAttention2와…
논문의 강점 및 독창적인 지점 Global Prefix Sharing의 명시적 적용 기존의 LLM 추론 엔진은 LRU 기반 캐시를 사용해 접두사(prefix)를 공유했지만, 이는 대규모 배치에서 최적화를 달성하지 못했습니다. BatchLLM은 전역적으로 접두사를 명시적으로 식별하고 관리하여 공유 접두사를…
논문의 강점과 독창성 강점 학습 없이 활성화 희소성 예측: • SparseInfer는 기존 방법들이 필요로 했던 추가적인 학습 없이 활성화 희소성을 예측할 수 있습니다. 이는 모델이 변경되거나 양자화 수준이 달라져도 유연하게 적용 가능하다는 점에서 효율적입니다. 컴퓨팅 및 메모리 효율성: • 기존…
결론 요약 논문은 긴 시퀀스에 대한 Transformer 기반 대형 언어 모델(LLM)의 추론 효율성을 크게 개선하는 Star Attention이라는 알고리즘을 제안했습니다. 기존 Ring Attention 대비 최대 11배의 추론 속도를 제공하면서도 정확도를 95100% 수준으로 유지합니다. Star…
요약 이 논문은 Byte Latent Transformer (BLT)라는 새로운 아키텍처를 제안하며, 기존의 고정된 토큰화 기반 대규모 언어 모델(LLM)과 비교하여 효율성과 견고성을 크게 개선했습니다. BLT는 바이트 단위로 데이터를 패치화하여 동적이고 학습 가능한 방법으로 처리 능력을 효율적으로 할당…
결론 및 핵심 요약 이 논문은 LLM(대규모 언어 모델)의 효율적인 메모리 관리와 고성능 서빙을 위해 PagedAttention이라는 새로운 주의 알고리즘을 제안하며, 이를 기반으로 한 vLLM 시스템을 설계했습니다. 기존 시스템 대비 24배의 처리량 향상을 제공하며, 특히 메모리 낭비를 줄이고, 다양한…
논문의 강점과 독창성 스케일링 접근 방식의 혁신성: GShard는 6000억 개 이상의 파라미터를 가진 모델을 분산 TPU 클러스터에서 효과적으로 학습할 수 있도록 설계되었으며, 이를 통해 비용 효율적인 방식으로 초대형 신경망 모델을 학습할 수 있음을 입증했습니다. 6000억 파라미터 모델을 2048개의…
논문의 강점과 독창적인 지점 1. 강점 일반화된 병렬화 시스템: GSPMD는 다양한 병렬화 패턴(데이터 병렬화, 모델 병렬화, 파이프라인 병렬화)을 단일 프레임워크로 통합하여 모든 유형의 머신러닝 모델에서 사용할 수 있음. 사용자 주석(annotation)을 최소화하면서 모델을 대규모 장치 클러스터로 확…
결론 요약 이 논문은 Memory Layers라는 새로운 형태의 모델 아키텍처를 제안하여, 연산 복잡도를 거의 증가시키지 않으면서 언어 모델의 파라미터 공간을 확장하는 방식을 설명합니다. Memory Layers는 키-값 조회 메커니즘을 통해 사실 기반 질의응답(Factual QA)에서 성능을 크게 향상…
논문의 주요 내용을 요약하자면, Orca 모델은 GPT-4와 같은 대형 언어 모델(LFM)의 복잡한 설명 과정(Reasoning Process)을 학습하여, 기존의 Instruction-tuning 모델들에 비해 뛰어난 성능을 보이는 13B 파라미터 모델입니다. Orca의 주요 혁신은 설명 튜닝…
논문의 핵심 요약 이 논문은 Mixture-of-Experts (MoE) 기반 대형 언어 모델(Mixtral-8x7B)을 제한된 GPU 메모리 환경에서 효율적으로 추론할 수 있는 방법을 제안합니다. 주요 기여는 다음과 같습니다: LRU 캐싱 및 Speculative Expert Loading 알고리즘을…
논문 분석: FlashAttention-2 FlashAttention-2는 기존 FlashAttention의 성능 병목을 개선하여 Transformer 모델의 Attention 연산에서 효율성을 극대화한 알고리즘입니다. 특히, GPU의 병렬성 활용을 최적화하여 긴 시퀀스를 다루는 데 있어 탁월한 성능을…
FlashAttention-3 논문 분석 FlashAttention-3는 Transformer의 Attention 연산을 최적화하여 성능과 메모리 효율성을 크게 향상시킨 알고리즘입니다. 이 논문은 기존 FlashAttention-2의 한계를 극복하며, NVIDIA Hopper GPU의 특화된 하드웨어 기…
요약 및 결론 이 논문, "FlashAttention", 은 Transformer 모델의 self-attention 모듈에서 메모리 및 계산 효율성을 극대화하기 위한 새로운 알고리즘을 제안합니다. 이를 통해 긴 시퀀스를 다루는 Transformer의 병목을 해소하며 기존 방법 대비 속도와 메모리 사용에서…
논문 요약 Infinite-LLM은 초대형 언어 모델(LLM)의 동적 컨텍스트 길이 문제를 해결하기 위해 제안된 효율적인 서비스 시스템입니다. 논문은 특히 DistAttention 메커니즘과 Distributed KVCache를 도입해 LLM 요청 서비스의 확장성을 획기적으로 개선합니다. 이를 통해 긴…
논문 요약 및 분석 논문의 강점 문제 정의의 명확성: 예측 불가능하고 폭발적인 워크로드 하에서 ML 추론 시스템이 지연(SLO)을 만족하면서 높은 정확도를 유지해야 하는 문제를 효과적으로 다룸. 독창적인 접근 방식 - SubNetAct: SubNetAct는 SuperNet을 활용하여 메모리 효율성과 지연…
논문의 강점과 독창적인 지점 효율적이고 정확한 Weight Update 논문은 Alternating Direction Method of Multipliers (ADMM) 기반의 효율적인 Layer-wise Weight Update 알고리즘을 제안합니다. 기존 Gradient Descent 기반 방법들…
논문의 강점과 독창성 핵심 아이디어 - Heavy Hitter 기반 FFN 분할 (FFSplit): Feed-Forward Network (FFN)의 heavy hitter 뉴런은 특정 입력 토큰에서 높은 출력 노름(norm)을 가지며, 전체 성능에 크게 기여한다는 점을 발견했습니다. 이를 활용해 FFN…
논문 요약 및 분석 제목: FlightLLM: Efficient Large Language Model Inference with a Complete Mapping Flow on FPGAs 주제: FPGA 기반 대형 언어 모델(LLM) 추론을 위한 효율적 아키텍처 핵심 결론 및 강점 결론 요약…
논문의 강점 및 독창적인 지점 이론적 한계를 실질적 이점으로 전환: 기존 Linear Attention은 계산 복잡도를 \(O(n^2)\)에서 \(O(n)\)으로 낮추었으나, cumsum 연산의 병목으로 인해 causal 설정에서는 성능 개선이 한정적이었습니다. Lightning Attention-2는…
논문의 강점과 독창적 지점 혁신적 구조: 이 논문은 State Space Models (SSMs) 기반인 Mamba와 Mixture of Experts (MoE) 방식을 결합한 MoE-Mamba 모델을 제안합니다. 이를 통해 SSM의 선형 시간 복잡도와 MoE의 효율적 확장성을 동시에 확보했습니다. 학습…
요약 논문의 제목: DeepSpeed-FastGen: High-throughput Text Generation for LLMs via MII and DeepSpeed-Inference 핵심 기여: Dynamic SplitFuse라는 새로운 방법론을 통해 긴 프롬프트 처리와 텍스트 생성 작업을 동적으로 결…
논문의 핵심 내용 및 독창성 논문 제목: DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving 주요 기여: 문제 정의: 기존 LLM 서비스 시스템은 "Prefill"(첫 토큰 생성)과…
결론: TetriInfer의 주요 기여 및 핵심 아이디어 TetriInfer는 대규모 언어 모델(LLM)의 추론 과정에서 발생하는 간섭 문제(interference)를 해결하기 위해 설계된 클라우드 기반 추론 시스템입니다. 주요 강점은 사전 단계(prefill)와 디코드 단계(decode)의 분리…
논문 요약 및 분석 결론 요약 논문 Inferflow는 대규모 언어 모델(LLM)을 위한 효율적이고 확장 가능한 추론 엔진으로, 3.5비트 양자화 및 하이브리드 모델 분할과 같은 독창적인 기술을 제안하여 기존 엔진 대비 성능(추론 속도, 메모리 사용량)과 유연성을 개선했습니다. 주요 강점은 구성 파일 기…
핵심 요약 논문의 제목: "MEDUSA: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads" 논문의 주요 기여: LLM의 추론 속도를 높이기 위해 추가적인 Decoding Head를 도입해 병렬적으로 다수의 토큰을 예측.…
논문의 강점 및 독창적인 지점 효율적인 병렬 디코딩: LOOKAHEAD DECODING은 기존의 자동회귀 디코딩의 한계를 극복하기 위해 설계되었으며, 여러 토큰을 병렬로 생성하면서도 정확성을 유지하는 점이 강점입니다. 이는 계산 자원을 효율적으로 활용하여 디코딩 속도를 최대 1.8배(단일 GPU 기준),…
강점과 독창성 효율적인 추론 가속화 이 논문은 대규모 언어 모델(LLM)의 추론 속도를 높이기 위해 Speculative Decoding 방식을 체계적으로 분석하고 최적화하는 데 초점을 맞추고 있습니다. 기존의 초안 모델 설계는 정확성 위주였으나, 이 논문은 초안 모델의 설계 방향을 폭넓고 얕은 구조로…
논문의 강점과 독창적인 지점 강점: 효율적인 프롬프트 캐싱 문제 해결: LLM의 높은 자원 소모 문제를 완화하기 위해 프롬프트 캐싱을 도입하고, 기존 임베딩 기반 접근법을 개선함. 기존 모델(Wang et al., 2022)의 AUC가 0.51인 데이터셋에서 이를 0.81로 향상. 정량적 성능 개선:…
논문의 강점과 독창적인 지점 FP6 기반의 효율적인 양자화 지원: 논문은 FP6(6-bit 부동소수점) 양자화의 중요성을 부각하며, 기존 4-bit 또는 8-bit 양자화보다 품질과 성능 간의 우수한 균형을 제공한다고 주장합니다. 이는 LLaMA-70B 모델과 같은 대규모 언어 모델에서 특히 두드러집니다…
논문 요약과 분석 핵심 요약 이 논문에서는 TP-Aware Dequantization이라는 새로운 방법을 제안하여 대형 언어 모델(LLM)의 분산 추론 과정에서 지연(latency)을 줄이는 최적화를 소개합니다. 이 방법은 텐서 병렬(Tensor Parallel, TP) 환경에서 데이터 국지성(data…
논문의 주요 내용 요약 이 논문은 Nvidia Hopper GPU 아키텍처에 대한 심층적인 벤치마킹과 분석을 수행했습니다. 특히 Hopper 아키텍처의 다음 세 가지 주요 특징을 다루었습니다: Tensor Core의 새로운 명령 세트(wgmma): FP8, TF32와 같은 새로운 데이터 유형과 비동기식…
논문의 요약 논문 "Get More with LESS: Synthesizing Recurrence with KV Cache Compression for Efficient LLM Inference"는 대규모 언어 모델(LLM)의 추론에서 발생하는 키-값(KV) 캐시 메모리 병목 문제를 해결하기 위해…
논문의 핵심 요약 이 논문은 Hydragen이라는 새로운 방법을 소개하여, 공통 프리픽스를 공유하는 텍스트 배치에 대한 대규모 언어 모델(LLM) 추론을 최적화합니다. 이 방법은 특히 프리픽스와 서픽스에 대한 어텐션 계산을 분리하고, 인터-시퀀스 배칭을 통해 하드웨어 효율성을 극대화하여 GPU 메모리 대…
논문 요약 및 강점, 독창성 강점과 독창성: 주요 기여: 이 논문은 대규모 언어 모델(LLM) 추론에서 혼합 정밀도 General Matrix Multiplication (GEMM) 커널의 효율성을 높이기 위해 QUICK라는 새로운 CUDA 커널을 제안했습니다. - 기존 혼합 정밀도 커널의 병목 현상(특…
논문 요약과 분석 핵심 내용 요약 문제 정의: 긴 시스템 프롬프트를 포함하는 대규모 언어 모델(LLM)의 추론 효율성 문제. 기존 접근법은 메모리 접근의 비효율성으로 인해 처리 속도와 레이턴시가 저하됨. 기술적 기여: RelayAttention이라는 새로운 알고리즘을 제안하여 공유 시스템 프롬프트의 캐시…
강점 및 독창성 요약 이 논문 TeraPipe는 Transformer 기반 언어 모델(Large Language Models, LLMs)의 훈련을 가속화하기 위한 Token-Level Pipeline Parallelism을 제안합니다. 주요 강점은 다음과 같습니다: 토큰 단위 병렬화: 기존의 마이크로배치…
강점 및 독창성 동적 맥락 정리 (Dynamic Context Pruning): 본 논문은 Transformer 기반 모델의 맥락 정보를 동적으로 삭제하는 새로운 접근 방식을 제안합니다. 이는 단순히 고정된 컨텍스트 창(window) 크기나 정적 토큰 압축 방식에 의존하지 않고, 학습된 메커니즘을 통해…
논문의 강점과 독창적인 지점 독창적인 접근법: Multi-query Attention 이 논문은 Transformer 모델의 효율성을 높이기 위해 기존 Multi-head Attention을 Multi-query Attention으로 대체하는 혁신적인 방식을 제안합니다. Multi-query…
논문 "GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints"를 분석한 내용을 아래에 정리하였습니다. 논문의 강점 효율성 향상: Multi-Query Attention (MQA)를 활용하여 메모리 대역폭 병…
논문의 강점 및 독창성 효율적인 KV 캐시 관리: H2O(H2 Heavy-Hitter Oracle)라는 새로운 캐시 제거 정책을 통해, LLM의 KV 캐시 크기를 줄이면서도 성능을 유지할 수 있는 방법을 제안합니다. 이는 기존 LRU 또는 LFU와는 차별화된 접근법으로, 중요한 토큰(Heavy…
논문의 강점 효율적인 메모리 관리: SCISSORHANDS는 KV 캐시 메모리를 최대 5배까지 압축하여 대규모 언어 모델(LLM)의 배치를 확장하는 데 유리합니다. 이 방법은 모델을 재학습하지 않고도 메모리 사용량을 감소시켜 기존 하드웨어에서 모델 효율성을 향상시킵니다. 이론적 정당성 및 실험적 검증:…
논문의 주요 내용과 분석을 다음과 같이 요약하겠습니다: 논문의 강점 및 독창성 독창적 아이디어: 기존 Vision Transformer(ViT) 모델의 토큰 처리 속도를 향상시키기 위해 "토큰 병합(Token Merging, ToMe)" 기법을 제안했습니다. 이는 토큰을 단순히 제거하는 것이 아니라 병합…
논문의 강점과 독창성 이 논문 H2O (Heavy-Hitter Oracle)는 대형 언어 모델(LLM)의 추론 과정에서 발생하는 KV 캐시 메모리 문제를 효율적으로 해결하기 위해 새로운 접근법을 제안합니다. 주요 강점과 독창성은 다음과 같습니다: 문제 해결의 중요성: 대형 언어 모델은 메모리 사용량이 높…
논문 "GLM-130B: An Open Bilingual Pre-Trained Model"에 대한 분석은 아래와 같습니다: 논문의 강점 및 독창성 대규모 공개 모델: GLM-130B는 1300억 개의 매개변수를 가진 대규모 언어 모델로, 영어와 중국어를 모두 다룹니다. 이 모델은 GPT-3(175B)와…
논문의 강점 독창적인 Roofline 모델 분석: 이 논문은 Roofline 모델을 사용하여 LLM(대형 언어 모델)의 추론 효율성을 평가하고 병목 현상을 분석하는 데 초점을 맞추고 있습니다. 이는 기존의 일반적인 리뷰 논문과 차별화되며, 모델의 메모리 및 계산 병목을 체계적으로 진단합니다. 다양한 최적…
논문의 강점과 독창성 강점: 효율적인 압축 알고리즘: LLMLingua는 대형 언어 모델(LLM)의 프롬프트를 최대 20배까지 압축하면서도 성능 저하를 최소화했습니다. 이는 기존 연구와 비교하여 압축 비율과 성능 유지 면에서 큰 향상을 보여줍니다. 체계적인 프레임워크: Budget Controller:…
논문 요약 및 분석 논문 "Model Tells You What to Discard: Adaptive KV Cache Compression for LLMs"는 대규모 언어 모델(LLMs)의 효율적인 추론을 위한 KV 캐시 압축(FastGen) 방법을 제안합니다. 이 방법은 메모리 사용량을 줄이고 추론 속…
논문의 상세 분석 1. 요약과 강점 "No Token Left Behind: Reliable KV Cache Compression via Importance-Aware Mixed Precision Quantization"라는 제목의 이 논문은 Mixed-precision KV cache (MiKV)라는…
논문 요약과 분석 이 논문은 구글 연구팀이 작성한 "Scaling Instruction-Finetuned Language Models"로, 대규모 언어 모델(예: PaLM, T5)을 Instruction Fine-Tuning 기법으로 미세조정하여 새로운 작업에 대한 일반화 능력을 크게 향상시키는 방법을…
논문의 주요 내용 및 독창성 논문 제목: Benchmarks as Limits to Arbitrage: Understanding the Low-Volatility Anomaly 저자: Malcolm Baker, Brendan Bradley, Jeffrey Wurgler 출판년도: 2011 연구의 배경 및…
이 논문은 BLOOM(176B 파라미터 오픈소스 다국어 언어 모델)에 대한 연구를 담고 있습니다. 아래에서 논문의 강점, 독창적인 점, 알고리즘의 핵심 흐름, 그리고 한계점을 자세히 정리하겠습니다. 논문의 강점 개방성과 협업: BLOOM은 기존의 상업적 모델과 달리 전 세계 연구자들의 협력으로 개발된 오…
논문 "CacheGen: KV Cache Compression and Streaming for Fast Large Language Model Serving"에 대한 분석을 아래와 같이 제공합니다. 강점 및 독창성 강점 효율적인 KV 캐시 전송 및 로딩: CacheGen은 LLM의 KV 캐시를 압축하여 전…
논문의 제목: CHAI: Clustered Head Attention for Efficient LLM Inference 논문의 주요 내용 요약 이 논문은 대규모 언어 모델(LLM)의 추론 시 발생하는 메모리 및 계산 병목현상을 줄이기 위해 Clustered Head Attention (CHAI)를 제안합…
논문에서 다루는 내용인 "Galactica: A Large Language Model for Science"를 바탕으로 요청하신 논문 분석을 다음과 같이 수행했습니다: 논문의 강점 과학 데이터에 특화된 대규모 언어 모델 개발 Galactica는 과학적 지식과 데이터를 효율적으로 저장, 결합, 추론할 수…
논문의 강점과 독창적인 지점 이 논문은 고유 변동성이 높은 주식의 낮은 미래 평균 수익률이라는 현상을 국제 시장과 미국 시장에서 종합적으로 분석합니다. 이 연구의 강점과 독창적인 지점은 다음과 같습니다: 국제적 검증: 이전 연구가 주로 미국 시장에 국한되었다면, 이 논문은 23개 선진국의 데이터를 분석하…
논문의 주요 내용, 강점, 독창성, 알고리즘 예시, 한계점 논문의 개요 논문 "LongLLMLingua: Accelerating and Enhancing LLMs in Long Context Scenarios via Prompt Compression"은 대규모 언어 모델(LLM)이 긴 문맥을 처리할 때…
논문의 강점과 독창적인 지점 트랜스포머와 RNN의 연결 제시: 이 논문은 트랜스포머를 "무한 상태 RNN(MSRNN)"으로 재정의함으로써, 전통적으로 개념적으로 구별되어 온 두 아키텍처 간의 연결성을 제시합니다. 이는 두 모델의 근본적인 공통점을 부각시키는 독창적인 접근입니다. 효율적 메모리 관리 제안:…
논문의 강점과 독창성 강점: 훈련 불필요한 가속화 방법: 기존의 모델 압축이나 속도 향상 방법은 대규모 재학습이 필요한 경우가 많지만, 이 논문에서는 훈련 없이 모델의 속도를 개선할 수 있는 혁신적인 접근법을 제시했습니다. U-Net 구조 활용: U-Net의 구조적 특성을 활용하여 고레벨 특징…
논문 제목은 "Get More with LESS: Synthesizing Recurrence with KV Cache Compression for Efficient LLM Inference"입니다. 논문에서 제안된 LESS(Low-rank Embedding Sidekick with Sparse…
강점과 독창성 효율적이고 튜닝이 필요 없는 2비트 양자화 알고리즘: KIVI는 LLM의 키-값 캐시(KV Cache)를 튜닝 없이 2비트로 양자화하여 최대 2.6배 메모리 감소와 최대 3.47배 처리량 증가를 달성합니다. 기존 연구와 달리 키 캐시는 채널별로, 값 캐시는 토큰별로 양자화하는 새로운 방식을…
논문 "KVQuant: Towards 10 Million Context Length LLM Inference with KV Cache Quantization"은 초대형 문맥 창 길이를 가진 대규모 언어 모델(LLM)에서 효율적인 추론을 가능하게 하는 방법론을 제안합니다. 아래는 논문의 강점, 독창적인 지…
논문 "Momentum Strategies" (1996)를 분석하고 요청하신 내용을 자세히 설명드리겠습니다. 논문의 강점과 독창적인 지점 이 논문은 주식 시장에서 모멘텀 효과를 체계적으로 분석한 대표적인 연구입니다. 논문은 다음과 같은 강점과 독창성을 가지고 있습니다: 모멘텀 투자 전략 검증: 과거…
논문 요약: "No Token Left Behind: Reliable KV Cache Compression via Importance-Aware Mixed Precision Quantization"는 대규모 언어 모델(LLM)의 추론 시 발생하는 메모리 병목 현상을 해결하기 위한 Key-Value(KV)…
강점과 독창적인 지점 WKVQuant은 대규모 언어 모델(LLM)의 메모리 사용 문제를 해결하기 위해 설계된 Post-Training Quantization (PTQ) 프레임워크입니다. 주요 강점과 독창적 특징은 다음과 같습니다: 효율성과 정확성의 균형: 기존 방식(Weight-Only…
논문 "Improving Language Understanding by Generative Pre-Training"의 주요 내용을 자세히 정리하고, 강점과 독창성, 알고리즘의 예제 과정을 설명한 뒤, 한계점도 다루겠습니다. 논문의 주요 내용 목적: 대규모 비지도 학습(Generative…
이 논문은 Google의 PaLM 2에 대한 기술 보고서로, 언어 모델의 새로운 상태를 정립한 모델로서, 다중 언어 처리 능력과 추론 능력을 강화하고, 이전 모델에 비해 컴퓨팅 효율성을 크게 개선한 것이 핵심입니다. 아래에 이 논문의 강점, 독창적인 지점, 핵심 알고리즘 설명, 그리고 한계점을 정리했습니…
논문의 요약 PowerInfer는 소비자용 GPU로 대형 언어 모델(LLM)을 빠르게 추론할 수 있도록 설계된 시스템입니다. LLM 추론에서 고도 국소성을 활용하여 GPU와 CPU의 협력을 통해 효율성을 극대화합니다. 주요 기여 Hot & Cold Neuron 분리: 자주 활성화되는 "hot…
논문 요약: QAQ: Quality Adaptive Quantization for LLM KV Cache 주요 기여 품질 적응형 양자화(Quality Adaptive Quantization): LLM의 Key-Value(KV) 캐시를 위한 새로운 양자화 방식 제안. 이는 GPU 메모리 사용량을 10배까지…
논문 요약: ALISA: 대규모 언어 모델 추론 가속화를 위한 희소성 기반 KV 캐싱 이 논문은 대규모 언어 모델(LLM)의 추론 속도를 개선하기 위해 ALISA라는 새로운 알고리즘-시스템 공동 설계 방안을 제시합니다. 특히, GPU 메모리가 제한된 환경에서 LLM 추론 효율을 극대화하기 위한 다양한 방…
이 논문은 Google AI Language 팀에서 작성한 "BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding"로, 자연어 처리(NLP) 분야에서 혁신적인 성과를 이룬 대표적인 논문입니다.…
논문 요약 및 강점, 독창성, 핵심 알고리즘 설명 논문 요약 논문은 대형 언어 모델(LLM)의 비효율적인 메모리 사용 문제를 해결하기 위해 Dynamic Memory Compression (DMC) 방법을 제안합니다. 이 방법은 모델의 키-값(KV) 캐시를 실시간으로 동적으로 압축하여, 더 적은 메모리로…
논문 분석: Fast Inference from Transformers via Speculative Decoding 논문의 강점 속도 향상: Speculative Decoding 기법을 통해 기존의 T5-XXL과 같은 대규모 모델보다 2배에서 3배 빠른 추론 속도를 달성. 모델 수정 불필요: 모델 아키텍…
논문의 강점과 독창적인 지점 이 논문은 대규모 언어 모델(LLM) 서빙을 위해 FASTDECODE라는 새로운 시스템을 제안합니다. 주요 강점과 독창성은 다음과 같습니다: 메모리-계산 분리 아키텍처: LLM의 중요한 구성요소인 KV-Cache를 GPU가 아닌 CPU에서 처리하도록 설계했습니다. CPU는 메…
논문의 강점과 독창성 강점: 과제 무관 압축(Task-Agnostic Compression): LLMLingua-2는 특정 과제에 의존하지 않는 프롬프트 압축 모델로, 다양한 도메인과 과제에 일반화할 수 있는 능력을 갖추고 있습니다. 효율성: 모델은 적은 크기의 데이터로 훈련되고 작은 모델…
논문은 Direct Preference Optimization (DPO)라는 새로운 방법을 제안하며, 인간 선호 데이터 기반으로 대규모 언어 모델(LLM)을 효율적으로 미세 조정(fine-tuning)하는 과정을 크게 간소화합니다. 아래는 논문의 주요 기여점, 강점, 핵심 알고리즘 설명, 한계점에 대한…
논문 요약 및 분석 논문 제목: Hierarchical Context Merging: Better Long Context Understanding for Pre-Trained LLMs 핵심 내용: 이 논문은 대형 언어 모델(LLMs)의 문맥 길이 제한 문제를 해결하기 위해…
논문 요약 및 평가 논문의 주요 내용 및 독창성 이 논문은 "MELTing Point: Mobile Evaluation of Language Transformers"로, 모바일 및 엣지 디바이스에서 대형 언어 모델(LLM)의 실행 가능성을 평가하는 것을 목표로 합니다. 이를 위해 MELT라는 자동화된 벤…
논문의 강점과 독창성 MuxServe: Flexible Spatial-Temporal Multiplexing for Multiple LLM Serving는 다중 대형 언어 모델(LLM)을 효율적으로 서빙하기 위한 공간-시간 다중화(spatial-temporal multiplexing) 시스템을 제안합니다…
논문의 주요 강점 및 독창성 논문은 Google Research의 Flan-T5 및 Flan 2022 데이터를 중심으로, 지시 조정(instruction tuning)의 방법론적 개선을 제시하며 이를 통해 상당한 성능 향상을 입증합니다. 주요 강점과 독창성을 다음과 같이 요약할 수 있습니다. 효율적인 지…
논문의 요약 논문 제목: Transformer-Lite: High-efficiency Deployment of Large Language Models on Mobile Phone GPUs 저자: Luchang Li 외 다수 목적: Transformer-Lite는 모바일 GPU에서 대형 언어 모델(LLM)…
논문 "Tree of Thoughts: Deliberate Problem Solving with Large Language Models"는 대형 언어 모델(LLM)을 활용한 문제 해결 능력을 향상시키기 위해 "사고의 나무(Tree of Thoughts, ToT)"라는 새로운 프레임워크를 제안합니다. 아래…
논문의 강점, 독창성, 핵심 알고리즘, 그리고 한계점에 대한 분석 논문의 강점 효율적인 메모리 사용: LLM 추론 과정에서 가장 큰 병목 중 하나인 키-값(KV) 캐시 메모리를 최적화하여 최대 70%까지 메모리 사용을 줄였습니다. 기존 모델 성능을 거의 유지하면서도 메모리 효율성을 대폭 향상했습니다. 추…
논문의 주요 내용 분석 논문의 강점 무한 컨텍스트 처리 능력: Infini-attention은 Transformer 모델의 기존 한계를 극복하며, 무한 길이의 입력을 효율적으로 처리할 수 있도록 설계되었습니다. 이는 긴 문맥의 언어 모델링과 책 요약 작업에서 우수한 성능을 보입니다. 효율성:…
다음은 논문 "Llama 2: Open Foundation and Fine-Tuned Chat Models"에 대한 한글 요약 및 분석입니다. 논문의 강점, 독창적인 기여, 핵심 알고리즘 설명(예시 포함), 그리고 한계점에 대해 설명드리겠습니다. 논문의 강점 모델의 확장성: Llama 2는 7B,…
논문 요약: Mistral 7B Mistral 7B는 70억 개의 매개변수를 가진 언어 모델로, 효율성과 성능을 모두 갖춘 모델을 목표로 설계되었습니다. 이 모델은 OpenAI의 Llama 2와 같은 기존 모델을 다양한 벤치마크에서 능가하며, 특히 수학, 코드 생성, 논리 추론에서 탁월한 성능을 보입니다…
논문 "Retrieval Head Mechanistically Explains Long-Context Factuality"는 대규모 언어 모델(LLMs)이 긴 맥락에서 정보를 검색하는 메커니즘을 설명하며, 이를 통해 모델의 정확성과 합리성을 이해하고 개선하려는 연구입니다. 아래는 논문의 핵심 내용, 강점…
논문 분석: SnapKV 이 논문은 대형 언어 모델(LLM)의 Key-Value(KV) 캐시 최적화를 목표로 한 새로운 알고리즘 SnapKV를 제안합니다. 아래는 논문의 핵심 기여, 알고리즘 동작 방식, 강점, 한계점 등을 한국어로 정리한 내용입니다. 논문의 강점 문제 해결 LLM은 긴 프롬프트를 처리할…
논문의 강점 및 독창적인 지점 이 논문은 SqueezeAttention이라는 2D KV-캐시 압축 알고리즘을 제안하여 대형 언어 모델(LLM)의 추론 효율성을 개선하는 방법을 소개합니다. 주요 강점과 독창적인 지점은 다음과 같습니다: 레이어별 중요도 반영: 기존 방법들은 모든 레이어에 동일한 캐시 예산을…
논문의 강점 및 독창적 기여 이 논문, "Toward Inference-optimal Mixture-of-Expert Large Language Models", 은 대규모 언어 모델에서 Mixture-of-Experts (MoE) 접근법을 연구하며, 주요 기여는 다음과 같습니다: MoE 모델 확장성에 대…
논문의 강점 및 독창성 논문 "DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model"는 다음과 같은 강점과 독창성을 보여줍니다: 효율적인 모델 아키텍처: Multi-Head Latent Attention…
이 논문 "MobileAIBench: Benchmarking LLMs and LMMs for On-Device Use Cases"의 주요 내용을 자세히 분석하고 요약하겠습니다. 또한 논문의 강점, 독창적인 점, 알고리즘 설명, 한계점 등을 정리하겠습니다. 논문의 주요 내용 이 논문은 모바일 기기에서…
논문의 강점과 독창적인 지점 효율적인 병렬 디코딩: 기존의 자동회귀 디코딩 방식은 한 번에 한 개의 토큰만 생성하여 GPU의 병렬 계산 능력을 충분히 활용하지 못했으나, 이 논문의 Hidden Transfer 방식은 한 번의 전파 과정에서 다수의 토큰을 예측하고 디코딩하는 방식을 제안함으로써 병렬 처리…
논문 "PowerInfer-2: Fast Large Language Model Inference on a Smartphone"은 스마트폰에서 대형 언어 모델(LLM)을 효과적으로 실행하기 위한 혁신적인 프레임워크인 PowerInfer-2를 소개합니다. 아래는 논문에 대한 상세 분석입니다: 강점과 주요 기…
논문 "RAGCache: Efficient Knowledge Caching for Retrieval-Augmented Generation"는 Retrieval-Augmented Generation (RAG) 시스템의 효율성을 높이기 위해 제안된 다단계 캐싱 시스템을 소개합니다. 이 시스템은 외부 지식을…
논문의 주요 내용 및 독창적인 점 논문의 강점과 독창적인 점 트리 기반 추측적 추론 (Tree-based Speculative Inference): 기존의 순차적 디코딩 또는 단일 시퀀스 기반 추측적 추론과 달리, SpecInfer는 트리 구조를 활용하여 여러 후보 토큰을 동시에 추론합니다. 이는…
논문의 요약 및 강점 이 논문은 대형 언어 모델(LLM)의 키-값(KV) 캐시를 압축하기 위한 데이터 없이 저비트 양자화(Data-free Low-bit Quantization) 기술, DecoQuant를 제안합니다. 이 기술은 텐서 분해(Matrix Decomposition)를 사용하여 KV 캐시 메모…
논문 제목: Layer-Condensed KV Cache for Efficient Inference of Large Language Models 논문의 강점 및 독창성 이 논문은 대형 언어 모델(LLM)의 효율적인 추론을 위해 Layer-Condensed KV Cache (LCKV) 라는 새로운 방법론을…
PyramidInfer: Pyramid KV Cache Compression for High-throughput LLM Inference라는 논문은 대형 언어 모델(LLM)에서 Transformer 기반 KV 캐시(key-value cache)를 효율적으로 압축하는 새로운 방법을 제안합니다. 아래는 논문…
논문 "SKVQ: Sliding-window Key and Value Cache Quantization for Large Language Models"는 대규모 언어 모델(LLMs)이 긴 문맥을 처리할 때 발생하는 메모리와 계산 부담을 줄이기 위해 새로운 양자화(Quantization) 전략을 제안하고…
논문의 개요: "You Only Cache Once: Decoder-Decoder Architectures for Language Models (YOCO)" 이 논문은 대규모 언어 모델에서 메모리 및 속도 최적화를 위해 YOCO(You Only Cache Once)라는 새로운 디코더-디코더 아키텍처를 제…
논문의 강점과 독창적인 지점 강점: 효율적인 메모리 사용: LoCoCo는 고정된 크기의 Key-Value (KV) 캐시를 활용하여, 긴 문맥에서도 메모리 사용량을 크게 줄입니다. 기존 방법들과 달리, 문맥 손실을 최소화하며 효율적으로 작동합니다. 데이터 기반 융합 기법: 기존의 경험적 KV 제거 방식 대…
논문 "Loki: Low-rank Keys for Efficient Sparse Attention"에 대한 상세한 분석을 제공하겠습니다. 이 논문은 자가회귀 기반의 대규모 언어 모델(LLM)에서 사용되는 자가주의 메커니즘의 계산 및 메모리 병목 현상을 개선하기 위한 새로운 방법론을 제안합니다. 강점과 독…
강점 및 독창성 논문 MiniCache: KV Cache Compression in Depth Dimension for Large Language Models는 대형 언어 모델(LLM)에서의 메모리 효율성을 향상시키기 위한 혁신적인 접근 방식을 제시합니다. 이 논문의 주요 강점과 독창성은 다음과 같습니다…
논문의 강점과 독창성 피라미드 정보 집중(Pyramidal Information Funneling)의 발견: LLM의 주의(attention) 메커니즘에서 낮은 층에서는 주의가 넓게 분산되고, 높은 층으로 갈수록 특정 토큰에 집중되는 독특한 패턴을 발견했습니다. 이 패턴을 기반으로, 층별로 주의 분포의…
논문의 강점과 독창성 1. 독창적인 기여: Cross-Layer Attention (CLA): 기존의 Multi-Query Attention (MQA)와 Grouped-Query Attention (GQA)이 개별 레이어에서 키-값(KV)을 공유했던 방식과 달리, CLA는 인접 레이어 간에 키-값을 공유…
The uploaded document appears to detail a method for compressing the Key-Value (KV) Cache in large language models (LLMs) using an L2 norm-based strategy. Here is a…
논문의 주요 강점 및 독창성 강점: 효율성 증대: 기존의 KV 캐시 감소 방법들은 주로 attention score에 의존했으나, 본 논문은 value vector의 ℓ1 노름을 추가적으로 고려함으로써 더 효과적인 pruning을 구현했습니다. 이는 기존 방법 대비 여러 과제에서 더 나은 성능을 보였습니…
The uploaded document introduces CItruS, a novel method for improving long-sequence modeling in transformer-based large language models (LLMs). Here’s a detailed…
논문의 강점 및 독창성 문제 정의의 중요성: 이 논문은 LLM(대형 언어 모델)의 효율적인 추론에 있어서 KV 캐시의 메모리 확장 문제를 지적하며 이를 해결하기 위한 독창적인 접근 방식을 제안합니다. 현재 LLM이 더 긴 컨텍스트와 더 큰 배치 크기를 지원하면서 메모리 병목 현상이 심각해지고 있는 상황에…
논문의 요약 이 논문은 MLKV (Multi-Layer Key-Value Sharing)라는 새로운 방법을 제안하여 Transformer 모델에서 KV(Key-Value) 캐시 메모리 사용량을 효율적으로 줄이는 방안을 탐구합니다. 기존 MQA(Multi-Query Attention) 및…
The uploaded document appears to be a comprehensive benchmarking paper evaluating various methods to enhance long-context capabilities in Large Language Models (LLMs),…
논문의 요약, 강점 및 독창성, 알고리즘 설명, 한계점 논문 제목: Dynamic Discriminative Operations (D2O) for Efficient Generative Inference of Large Language Models 1. 논문의 요약 이 논문은 대규모 언어 모델(LLMs)의…
논문의 핵심 내용 이 논문은 대형 언어 모델(LLM)의 효율적인 추론을 위해 ADORE(Adaptive Token Release)라는 새로운 기법을 제안합니다. 주요 내용은 다음과 같습니다: 배경 및 문제 정의: 대형 언어 모델의 키-값(Key-Value, KV) 상태를 효율적으로 관리하는 데 초점이 맞…
논문의 강점 및 독창성 문제 정의의 명확성: 기존 연구가 다루지 않은 멀티모달 대규모 언어 모델(MLLMs)의 장문 컨텍스트 문제를 타겟으로 하여, 멀티모달 키-값(KV) 캐시 관리의 효율성을 개선하려는 명확한 목표를 설정함. 효율적인 KV 캐시 압축: LOOK-M은 KV 캐시 크기를 최대 80% 줄이면…
논문의 강점과 독창적인 지점 이 논문은 KV Cache Merging이라는 새로운 접근 방식을 통해 LLM(대규모 언어 모델)의 긴 문맥 작업에서 메모리 효율성을 크게 향상시킵니다. 주요 강점은 다음과 같습니다: 독창적인 관찰: 논문은 단일 시퀀스 내에서 키 상태(key states)가 높은 유사도를 보…
논문의 강점과 독창성 강점: 적응적 자원 할당 방식: 이 논문은 기존에 균일하게 할당된 캐시 자원을 각 어텐션 헤드의 특성에 따라 적응적으로 배분하는 방법을 제안합니다. 이는 자원 사용 효율성을 극대화하며, 결과적으로 캐시 크기를 줄이면서도 품질 손실을 최소화합니다. 이론적 근거 제공: 캐시 제거 손실…
The uploaded paper is a comprehensive review titled "Keep the Cost Down: A Review on Methods to Optimize LLM’s KV Cache Consumption." Here's a detailed breakdown: 강점과 독창적…
논문의 분석: LazyLLM - DYNAMIC TOKEN PRUNING FOR EFFICIENT LONG CONTEXT LLM INFERENCE 강점 및 독창적인 지점 효율적 인퍼런스: LazyLLM은 긴 문맥을 처리하는 LLM의 효율성을 향상시키는 새로운 토큰 제거 방법을 제안합니다. 특히, 첫 번째…
논문 분석: "PQCache: Product Quantization-based KVCache for Long Context LLM Inference" 1. 강점 및 독창성 강점 메모리 효율성: - KVCache의 메모리 사용 문제를 해결하기 위해 Product Quantization(PQ)를 활용하여 메…
논문의 주요 내용 및 강점 강점 및 독창성: 기존 문제점 개선: 기존 Accumulative Attention Score (A2S) 기반 토큰 정리 방법은 Transformer Decoder 구조에서 공정하지 못한 토큰 비교 문제를 야기했습니다. 논문은 이를 Masked Self-Attention의…
논문 상세 분석 제목과 범위 이 논문은 대규모 언어 모델(LLMs)의 추론 과정에서 KV 캐시 관리를 최적화하여 메모리 사용량을 줄이고 성능을 유지하기 위한 NACL이라는 프레임워크를 제안합니다. 이 프레임워크는 프록시 토큰 제거(Proxy-Tokens Eviction)와 랜덤 제거(Random…
논문을 분석하고 요청하신 내용을 세부적으로 정리해보겠습니다. 논문의 강점 및 독창성 주요 강점: 효율적인 KV-Cache 압축: 기존의 키-값 캐시(KV-Cache) 압축 방식(토큰 샘플링, 양자화)보다 잠재적 차원에서의 중복을 활용하여 효율적으로 캐시를 압축합니다. 최대 50%의 메모리 절감과 1.89…
논문의 주요 내용 분석 및 평가 논문의 강점과 독창성 이 논문은 Double Sparsity라는 새로운 방식의 사후 훈련 희소화 기법을 제안하며, 다음과 같은 독창적인 요소를 포함합니다: 이중 희소화 (Double Sparsity) 기법: Token Sparsity: 중요한 토큰만 선택하여 연산을 수행해…
논문의 주요 내용 및 강점 논문의 목적 RetrievalAttention은 대규모 언어 모델(LLM)의 긴 문맥 처리에서 발생하는 연산 복잡성과 GPU 메모리 사용량 문제를 해결하기 위해 제안된 방법입니다. 이 방법은 주의 메커니즘의 동적 희소성을 활용하여, CPU 메모리에 있는 키-값(KV) 벡터를 근…
논문 "THINK: Thinner Key Cache by Query-Driven Pruning" 분석 논문의 강점 및 독창성 효율적인 메모리 최적화: THINK는 대규모 언어 모델(LLMs)의 KV 캐시(channel dimension) 최적화에 초점을 맞추어, 메모리 비용을 기존보다 20% 이상 감소시…
논문 "Discovering the Gems in Early Layers: Accelerating Long-Context LLMs with 1000x Input Token Reduction"은 대규모 언어 모델(LLMs)에서 긴 문맥 입력 처리 시 발생하는 계산 및 메모리 문제를 해결하기 위해 새로운 접…
논문 개요 InfiniPot는 메모리 제약 환경에서 기존의 대규모 언어 모델(LLM)이 긴 문맥을 처리할 수 있도록 설계된 새로운 Key-Value(KV) 캐시 제어 프레임워크입니다. 추가적인 훈련 없이, InfiniPot은 긴 문맥에서도 핵심 정보를 유지하며 효과적으로 처리할 수 있는 Continual…
논문의 제목: KV-COMPRESS: Paged KV-Cache Compression with Variable Compression Rates per Attention Head 1. 논문의 강점 및 독창성 1.1 KV-Compress의 주요 기여 PagedAttention 프레임워크 개선: 기존의 KV-…
논문의 강점과 독창성 이 논문에서는 LOCRET (Long-context Retaining Heads)이라는 새로운 프레임워크를 제안하여 긴 문맥을 다루는 대형 언어 모델(LLM)에서 효율적인 메모리 관리와 성능을 제공합니다. 주요 강점과 독창성은 다음과 같습니다: KV 캐시 압축의 정밀도: 기존의 캐시…
논문 "TACO-RL: Task Aware Prompt Compression Optimization with Reinforcement Learning"의 주요 내용을 분석한 결과, 강점, 독창성, 핵심 알고리즘, 그리고 한계점을 아래와 같이 정리했습니다. 논문의 강점 문제 해결의 중요성: LLM…
논문의 강점과 독창적인 지점 효율적인 메모리 사용 및 성능 개선: DuoAttention은 Retrieval Heads와 Streaming Heads의 구분을 통해 장문의 문맥을 처리하면서도 메모리 사용량을 최대 2.55배 감소시키고 디코딩 속도를 최대 2.18배 개선하였습니다. 이는 특히 GPU 자원이…
논문의 강점 및 독창적인 지점 강점: 실제 활용 가능성: LORC(Low-Rank Compression for LLMs KV Cache)는 미리 훈련된 대형 언어 모델(LLM)에 바로 적용할 수 있어 재훈련이나 세부적인 튜닝 없이 사용할 수 있습니다. 이는 배포 과정에서의 복잡성을 크게 줄여줍니다. 이론…
강점 및 독창적인 지점 논문의 강점: 효율성 향상: SparseVLM은 추가적인 훈련 없이 비전-언어 모델(VLM)의 효율성을 크게 향상시키는 방식을 제안합니다. 이는 기존의 많은 방법이 추가 데이터와 훈련이 필요했던 점에서 차별화됩니다. FLOPs(연산 복잡도)를 최대 67%까지 줄이면서도 93%의 정…
논문의 분석: "SWIFTKV: FAST PREFILL-OPTIMIZED INFERENCE WITH KNOWLEDGE-PRESERVING MODEL TRANSFORMATION" 논문의 주요 강점과 독창성 독창적인 구조 최적화: SingleInputKV: 초기 입력 토큰에 대해 마지막 레이어 일부를 스킵하…
강점 및 독창성 TidalDecode의 주요 강점과 독창성은 다음과 같습니다: 위치 지속 희소 주의(Position Persistent Sparse Attention, PPSA): 기존 희소 주의(sparse attention) 메커니즘에서 각 층마다 독립적으로 선택했던 중요한 토큰을 사용하지 않고, 여…
논문 제목: TorchTitan: One-stop PyTorch native solution for production ready LLM pre-training 논문의 강점과 독창성 PyTorch 기반 통합 솔루션: TorchTitan은 PyTorch-native 분산 훈련 시스템으로, 대규모 언어 모델…
논문 분석: "A Systematic Study of Cross-Layer KV Sharing for Efficient LLM Inference" 논문의 강점과 독창성 강점 통합적 접근: 기존 다양한 크로스 레이어 키-값(KV) 공유 방식을 하나의 통합된 프레임워크로 설명하며, 이들의 성능과 효율성을 체…
논문의 강점 및 독창성 문제의 명확성: 대규모 언어 모델(LLM)에서 KV-Cache가 메모리 및 계산 병목 현상을 유발한다는 문제를 잘 정의하고 있습니다. 이는 대규모 모델과 긴 컨텍스트 쿼리를 처리할 때 중요한 병목 요소로 작용합니다. 독창적인 접근: Attention-Gate (AG) 메커니즘은 학…
논문 분석 및 요약 논문 제목: Prompt Compression for Large Language Models: A Survey 논문의 강점과 독창성 포괄적인 서베이: 이 논문은 대규모 언어 모델(LLM)의 효율성을 높이는 데 중요한 프롬프트 압축(prompt compression)에 대해 하드 프롬프…
논문 제목: Scaling Laws for Neural Language Models 강점 및 독창성: 스케일링 법칙 발견: 모델 성능이 매개변수 수(N), 데이터 크기(D), 학습에 사용된 계산량(C)에 따라 일정한 파워 법칙을 따른다는 점을 체계적으로 분석. 이러한 법칙은 7개 이상의 크기 차수에 걸쳐…
논문의 강점 효율성 및 간결성: SimLayerKV는 7줄의 코드로 구현 가능하며 기존의 복잡한 알고리즘들과 달리 간단하면서도 강력한 성능을 제공합니다. 이는 모델 최적화를 쉽게 수행할 수 있는 실용적인 솔루션으로서 주목받을 만합니다. 훈련 불필요: 추가적인 모델 훈련 없이 기존의 사전 훈련된 모델에서…
논문의 주요 내용 분석 및 설명 이 논문에서는 코드 생성 작업을 위한 phi-1이라는 소형 대규모 언어 모델(LLM)을 제안합니다. 이 모델은 1.3억 개의 파라미터를 가진 Transformer 기반 모델로, 제한된 리소스(8개의 A100 GPU에서 4일간 훈련)를 활용해 높은 성능을 달성했습니다. 주요…
논문 요약: "MagicPIG: LSH Sampling for Efficient LLM Generation" 논문의 배경 및 문제 정의 최근 GPT, Llama 등과 같은 대형 언어 모델(LLM)은 긴 문맥을 활용한 응용에서 주목받고 있습니다. 하지만, 이 모델들은 키-값(KV) 캐시로 인한 병목 현상…
논문의 개요 및 독창성 분석 논문의 제목은 "Recycled Attention: Efficient Inference for Long-Context Language Models"입니다. 이 논문은 대규모 언어 모델(LLM)에서 긴 입력 시퀀스를 처리하는 효율성을 높이기 위해 Recycled…
논문의 요약 및 강점 논문의 제목은 "SQUEEZED ATTENTION: Accelerating Long Context Length LLM Inference"입니다. 이 논문은 긴 입력 문맥을 다루는 대형 언어 모델(LLM)에서 추론 속도를 대폭 개선하기 위해 제안된 새로운 주의 메커니즘인…
논문 "TokenSelect: Efficient Long-Context Inference and Length Extrapolation for LLMs via Dynamic Token-Level KV Cache Selection"에 대해 분석한 내용을 아래와 같이 정리하겠습니다. 논문의 강점 및 독창성 이…
논문 요약 및 분석 논문 제목: VL-CACHE: Sparsity and Modality-Aware KV Cache Compression for Vision-Language Model Inference Acceleration 논문의 주요 내용 및 기여점 이 논문은 Vision-Language Models…
논문의 개요와 강점 이 논문 "Chain-of-Thought Prompting Elicits Reasoning in Large Language Models"는 대규모 언어 모델이 복잡한 추론 작업을 수행할 수 있도록 하는 Chain-of-Thought (CoT) prompting 방법을 제안합니다. 이…
논문 분석 및 요약: "Deep Compression Autoencoder for Efficient High-Resolution Diffusion Models" 논문의 개요 및 주요 내용 이 논문은 고해상도 이미지 생성을 위한 효율적인 오토인코더인 Deep Compression Autoencoder…
논문의 강점 및 독창적인 지점 이 논문은 Hybrid Autoregressive Transformer (HART)라는 새로운 이미지 생성 모델을 제안하며, 이 모델은 특히 높은 효율성을 자랑합니다. HART는 1024x1024 해상도의 이미지를 직접 생성할 수 있으며, 기존의 확산 모델과 비교하여 다음과…
이 논문은 "Learning Transferable Visual Models From Natural Language Supervision"이라는 제목을 가진 CLIP (Contrastive Language-Image Pre-training) 모델에 대한 연구입니다. 논문의 핵심 내용 및 강점 기존 접근…
논문 분석: The COT Collection: Improving Zero-shot and Few-shot Learning of Language Models via Chain-of-Thought Fine-Tuning 논문의 강점 및 독창적인 지점 (1) 문제 정의 및 기여 이 논문은 소형 언어 모델…
논문의 요약 및 분석 논문의 개요 논문 "Condition-Aware Neural Network (CAN)"은 이미지 생성 모델에 제어 기능을 추가하기 위해 새로운 접근 방식을 제안합니다. 이 모델은 기존의 조건 제어 방법과는 달리, 조건에 따라 동적으로 네트워크의 가중치를 조정하여 이미지 생성 과정을…
논문의 개요 및 독창성 논문 "DistriFusion: Distributed Parallel Inference for High-Resolution Diffusion Models"은 고해상도 이미지 생성에서 발생하는 연산 병목을 해결하기 위해 다중 GPU를 활용하여 Diffusion 모델의 추론 속도를 대…
논문 요약 및 주요 내용 분석 논문 제목: "FastComposer: Tuning-Free Multi-Subject Image Generation with Localized Attention" 저자: Guangxuan Xiao, Tianwei Yin, William T. Freeman, Frédo…
논문 분석: VILA: On Pre-training for Visual Language Models 1. 논문의 배경 및 목표 이 논문은 Visual Language Model (VLM)을 개선하기 위한 사전 학습(pre-training) 기법을 연구합니다. 최근 대규모 언어 모델(LLM)의 성공을 기반…
논문 요약 및 강점 분석 논문 제목: VILA-U: A Unified Foundation Model Integrating Visual Understanding and Generation 논문의 주요 목표 및 독창적인 접근 방식 VILA-U는 텍스트와 비주얼(이미지/비디오)의 이해 및 생성 작업을 단일 모…
논문의 강점과 독창적인 지점 이 논문은 Batch Calibration (BC)이라는 새로운 기법을 제안하여 대형 언어 모델(LLMs)에서 In-Context Learning (ICL)과 프롬프트 엔지니어링에서 발생하는 다양한 바이어스 문제를 해결합니다. 이 방법은 기존의 교정 기법들이 가지는 한계를 극…
논문 분석: 강점, 독창적인 지점, 핵심 알고리즘 설명 및 한계점 이 논문은 Latent Reasoning Skills (LaRS)라는 새로운 접근법을 제안하여, Chain-of-Thought (CoT) 추론을 위한 효율적인 데모 선택 방법을 개발했습니다. 특히, LaRS는 기존의 CoT 기반 접근법의…
논문의 강점 및 독창적인 지점 이 논문은 LiteMoE (Lightweight Mixture of Experts) 프레임워크를 제안하여, 모바일 환경에서 대형 언어 모델(LLM)을 효과적으로 맞춤화하고 배포할 수 있도록 하는 방법을 제시합니다. 이 방법은 특히 모바일 장치의 제한된 리소스를 고려하여 설계…
논문 분석: 강점, 독창적인 지점, 핵심 알고리즘 설명 및 한계점 이 논문은 Correlation Clustering 문제를 다루며, 특히 노이즈가 있는 환경에서의 효율적인 쿼리 방식을 제안합니다. 논문에서 제안된 접근법은 다중 무장 밴딧(Combinatorial Multi-Armed Bandits,…
논문의 강점 및 독창적인 지점 ShadowKV는 긴 문맥을 가진 대형 언어 모델(LLM)에서 고속 추론을 가능하게 하는 시스템으로, 다음과 같은 강점과 독창적인 요소를 갖추고 있습니다: 메모리 사용 최적화: ShadowKV는 로우랭크(low-rank) 접근 방식을 활용하여 GPU 메모리 사용량을 크게 줄…
논문 "COMET: Towards Practical W4A4KV4 LLMs Serving"는 대형 언어 모델(LLMs)을 효과적으로 배포하기 위해 양자화(quantization) 기법을 활용하여 GPU 성능을 최적화하는 방법을 제안합니다. 특히 INT4 텐서 코어를 활용해 모델의 메모리 사용량과 계산 효…
The paper titled "ELICIT: LLM Augmentation via External In-Context Capability" introduces a novel framework aimed at enhancing the adaptive capabilities of large language…
이 논문 "Epic: Efficient Position-Independent Context Caching for Serving Large Language Models"는 대형 언어 모델(LLM) 추론 속도를 높이기 위한 위치 독립적 컨텍스트 캐싱(Position-Independent Context…
논문 분석: "Foundations of Factor Investing" 강점 및 독창적인 지점 이 논문은 팩터 투자(Factor Investing)에 대한 포괄적인 기초를 제공하며, 팩터 기반 인덱스가 어떻게 시장 자본화 가중 인덱스와 비교하여 보다 투명하고 비용 효율적인 접근 방식을 제공할 수 있는지…
이 논문 "RAG4ITOps: A Supervised Fine-Tunable and Comprehensive RAG Framework for IT Operations and Maintenance"는 IT 운영 및 유지보수를 위한 질의응답(QA) 시스템을 개선하기 위한 Retrieval-Augmented…
논문 분석: "Scientific Beta Multi-Beta Multi-Strategy Indices: Implementing Multi-Factor Equity Portfolios with Smart Factor Indices" 강점 및 독창적인 지점 이 논문은 팩터 투자 전략에서 다중 팩터 접근법을…
논문 분석 강점과 독창적인 지점 이 논문 "ALPINE: Unveiling the Planning Capability of Autoregressive Learning in Language Models"에서는 Transformer 기반 언어 모델의 경로 탐색 및 계획 능력을 분석하고 확장 가능한 알고리즘을…
논문 분석: "Can Graph Learning Improve Planning in LLM-based Agents?" 강점과 독창적인 지점 언어 모델과 그래프 학습의 통합: 이 논문은 대형 언어 모델(LLM)과 그래프 신경망(GNN)을 결합하여 복잡한 작업 계획(task planning)을 개선하려는 시…
논문 "Capital Asset Prices: A Theory of Market Equilibrium under Conditions of Risk"를 분석한 결과, 아래와 같이 논문의 강점, 독창적인 지점, 알고리즘의 전체 과정, 그리고 한계점을 설명하겠습니다. 논문의 강점 및 독창적인 지점 이 논문은…
논문 분석: "DynamoLLM: Designing LLM Inference Clusters for Performance and Energy Efficiency" 1. 논문의 강점 및 독창적인 지점 강점: 에너지 효율적인 LLM 인프라: 이 논문은 대규모 LLM 추론 클러스터에서 에너지 소비를 최적화하고…
논문 분석: "HYSYNTH: Context-Free LLM Approximation for Guiding Program Synthesis" 강점과 독창적인 지점 하이브리드 접근법: 이 논문은 대형 언어 모델(LLMs)과 하향식 및 상향식 탐색 방식을 결합한 하이브리드 방법론을 제안합니다. 기존에는 순수…
논문 분석: "MInference 1.0: Accelerating Pre-filling for Long-Context LLMs via Dynamic Sparse Attention" 강점과 독창적인 지점 효율적인 긴 문맥 처리: 이 논문은 긴 문맥을 처리하는 대형 언어 모델(LLM)의 추론 속도를 개선하는…
논문 "Portfolio Selection" (Harry Markowitz, 1952)를 분석한 결과를 토대로, 논문의 주요 강점, 독창성, 핵심 알고리즘 설명 및 예시, 그리고 한계점을 정리하여 설명하겠습니다. 1. 논문의 강점 및 독창적인 지점 Harry Markowitz의 "포트폴리오 선택 이론"은…
논문 "The Cross-Section of Expected Stock Returns"를 분석한 결과를 토대로, 논문의 강점, 독창성, 핵심 알고리즘 설명 및 예시, 그리고 한계점을 정리하여 설명하겠습니다. 1. 논문의 강점 및 독창적인 지점 이 논문은 Fama와 French가 제안한 연구로, 주식 수익…
네, 물론입니다. 논문의 강점과 독창성 어텐션 싱크(Attention Sinks) 개념 도입: 이 논문은 “어텐션 싱크”라는 새로운 개념을 도입하여, 초기 토큰이 중요한 의미를 갖지 않더라도 어텐션 점수를 흡수하여 모델의 성능을 안정적으로 유지하는 역할을 한다고 설명합니다. 이는 긴 문장에서도 성능 저하…
이 논문은 고성능 텐서 프로그램을 효율적으로 생성하기 위해 TLM (Tensor Language Model)을 사용하는 프레임워크를 제안하고 있습니다. TLM은 텐서 프로그램의 탐색 공간을 확장하면서도, 효율적인 최적화를 통해 컴파일 성능을 향상시키기 위한 접근 방식을 사용합니다. 논문의 강점과 독창성…
이 논문은 Meta AI에서 제안한 LLM Compiler라는 모델을 설명합니다. 이는 컴파일러 최적화 작업을 위해 설계된 대규모 언어 모델(LLM)로, 코드 최적화 및 디스어셈블리와 같은 컴파일러 관련 작업에서 높은 성능을 발휘하도록 훈련되었습니다. 논문의 강점과 독창적인 지점 컴파일러 최적화에 특화된…
논문의 강점 및 독창성 Beehive 구조와 Segmented Heavy Hitter 기반의 효율적 KV 캐시 관리: BUZZ는 일반적인 KV 캐시 방식의 메모리 문제를 해결하기 위해 벌집(beehive) 구조와 세분화된 Heavy Hitter를 결합한 새로운 KV 캐싱 방법을 제안합니다. 이를 통해 중…
논문의 강점 및 독창성 장치 및 모델 독립적 지연 예측: 이 논문은 다양한 장치와 DNN 모델에 대해 지연 시간을 예측할 수 있는 CDMPP (Cross-Device and Cross-Model Performance Prediction) 프레임워크를 제안합니다. 기존 방법들이 특정 장치나 모델에 대한 성…
논문의 강점과 독창성 Run-Length Tokenization (RLT) 기법: 이 논문은 비디오의 정적인 패치를 효율적으로 처리하여 비디오 트랜스포머 모델의 속도를 크게 향상시키기 위해 Run-Length Tokenization (RLT) 기법을 제안합니다. RLT는 비디오에서 시간이 지나도 변화가…
물론입니다. 논문의 주요 내용과 강점, 알고리즘 과정, 한계점에 대해 한국어로 설명드리겠습니다. 강점 및 독창성 향상된 통신 중첩: Flux는 GPU에서 종속 계산과 통신 작업을 매우 세밀한 단위로 분해하고 결합하여 최대 96%까지 통신 지연을 숨깁니다. 이 방식은 대규모 언어 모델의 분산 학습 및 추론…
논문의 강점과 독창성 1. 독창적인 KVSharer 방식: 이 논문은 LLM(대형 언어 모델)에서 메모리 사용량을 줄이기 위해 KVSharer라는 새로운 계층 단위의 KV(키-값) 캐시 공유 기법을 제안합니다. 기존 방식은 유사한 KV 캐시를 공유하여 메모리를 절약하려고 했지만, KVSharer는 비유사…
논문 "Splitwise: Efficient Generative LLM Inference Using Phase Splitting"는 대형 언어 모델(LLM)의 추론을 효율적으로 수행하기 위해서 추론 단계를 분리하는 Splitwise라는 기법을 제안합니다. 이 논문은 주로 대형 모델의 추론 요청 시 발생하…
KernelGPT 논문은 운영체제 커널에서의 결함 탐지를 위해 대형 언어 모델(LLM)을 활용한 자동화된 시스템 호출(specification) 생성 방법을 제안합니다. 기존의 커널 퍼징 도구 Syzkaller의 제약을 해결하기 위해 LLM을 활용하여 Syzkaller가 필요로 하는 system call…
논문 "Magicoder: Empowering Code Generation with OSS-INSTRUCT"는 대형 언어 모델(LLM)을 위한 오픈소스 기반 코드 생성 모델 Magicoder를 제안하며, 이를 통해 LLM의 코드 생성 성능을 크게 향상시키는 방법을 소개합니다. 이 논문의 주요 강점, 독창…
업로드된 논문은 DNN(딥 뉴럴 네트워크)의 성능을 개선하기 위해 커널 오케스트레이션을 최적화하는 텐서 프로그램 최적화 도구인 Korch에 대해 다루고 있습니다. 아래는 논문의 강점, 독창성, 핵심 알고리즘 예시와 한계점에 대한 설명입니다. 강점 및 독창성 운영자 분해와 세밀한 최적화: Korch는 "운…
논문 "SpotServe: Serving Generative Large Language Models on Preemptible Instances"는 대형 언어 모델(LLM)을 경제적인 프리엠티브 인스턴스에서 효율적으로 서빙할 수 있는 새로운 분산 시스템 SpotServe를 제안합니다. 이 논문의 주요 강…
개인의견 : pipeline Parallelism에 관련된 논문을 몇개 봤는데 그 중에서 가장 재밋는 논문인것 같네요. graph의 toplogy-aware Pipeline Parallelism이라는 당연한 개념을 포함하여 효과적인 결과를 내는것 같습니다. 다만 구현에 대한 오버헤드는 쫌 있을꺼같군요 논…
논문에서는 Helix라는 시스템을 소개하며, 이 시스템은 이기종(heterogeneous) GPU 클러스터 상에서 대규모 언어 모델(LLM)을 분산적으로 제공하기 위해 설계되었습니다. Helix의 주요 강점과 독창성, 핵심 알고리즘 예시, 한계점을 다음과 같이 정리해드립니다. 강점과 독창적인 지점 이기종…
이 논문, "Memory Bounds for the Experts Problem"는 전문가 조언을 이용한 온라인 학습 문제에 대한 메모리 제약을 다루고 있습니다. 전통적으로 전문가 예측에 기반한 알고리즘은 매일 예측을 처리하고, 최고의 전문가와 비교하여 손실을 최소화하도록 설계됩니다. 본 논문에서는 이러…
논문 "Sequoia: Scalable, Robust, and Hardware-aware Speculative Decoding"는 대형 언어 모델(LLM)에서 효율적인 추론(추론 속도 향상)을 위한 추론 속도 개선 알고리즘인 Sequoia를 제안합니다. 기존의 추론 속도 가속화 기법들이 규모 확장성, 하…
논문 "SpecExec: Massively Parallel Speculative Decoding for Interactive LLM Inference on Consumer Devices"의 주요 강점과 독창적인 점, 핵심 알고리즘 예시, 한계점 등을 한국어로 설명드리겠습니다. 강점과 독창적인 지점 소비자…
개인의견 : 잘모르는 분야이지만 meta publication을 보다가 흥미로워 보여서 선택한 논문.(내가 잘몰라서 질문을 못하겠다 ㅎㅎ;) 논문의 강점과 독창성 이 논문은 기존의 아이템 중심(Item-Centric) 랭킹 모델이 데이터 증가에 따른 성능 개선에 한계가 있음을 지적하고, 이를 해결하기 위…
Meta HDD 연구의 SMART 특징량 분석과 XGBoost 평가를 확인하고, 높은 재현율에도 운영 환경 적용이 어려웠던 이유를 정리합니다.
개인의견 : 패치 기반의 병렬 연산과 Cross-Attention을 통한 글로벌-로컬 상호작용, 그리고 토크나이저 free? 한 신기한 논문으로 보인다. 논문 요약: MEGABYTE의 강점과 독창성 이 논문은 MEGABYTE라는 모델을 소개하며, 기존의 Transformer 모델이 긴 시퀀스(수백만 바이…
개인의견 : 잘모르는 분야이지만 meta publication을 보다가 흥미로워 보여서 선택한 논문.(내가 잘몰라서 질문을 못하겠다 ㅎㅎ;) 이 논문에서는 공개 데이터와 비공개 데이터를 동시에 활용할 수 있는 검색 기반 시스템을 개발하기 위해 "SPLIT ITERATIVE RETRIEVAL…
FlexGen의 GPU 배치 간 가중치 재사용, 처리량 중심 정책 탐색, CPU attention과 4-bit 압축의 제약 및 단일 GPU 실험 조건을 원문으로 검토한다.
KV 캐시 압축 벤치마크의 prefill·decode 구분, 실제 품질 점수와 압축률, 양자화 메타데이터 비용 및 장문 생성에 대한 한계를 원문으로 검토한다.
Quest의 전체 KV 보존과 선택적 읽기, Query-Key 상한 점수, 페이지·토큰 예산, 전송량 계산과 decode 성능의 측정 범위를 원문으로 검토한다.
Teola의 primitive 그래프, causal prefix prefill과 구조화된 partial decoding, topology-aware batching 및 vLLM을 공유하는 실제 비교 조건을 원문으로 검토한다.
Attention Drop의 residual 기반 중요도, Joint Drop, 캘리브레이션 실험과 일반화의 경계를 원문으로 검토하고 제거 비율·품질·속도를 구분한다.
Multi-token Prediction의 공유 트렁크 학습, 자기 추측 디코딩, 실제 학습 비용과 코드 생성 평가를 원문으로 확인합니다.
CacheBlend는 검색된 청크의 KV 캐시를 일부 재계산해 융합한다. 토큰 선택, 로딩 파이프라인, Prompt Cache와의 차이 및 실험 조건을 원문과 대조한다.
Keyformer의 고정 KV 예산, 최근 윈도우를 제외한 핵심 토큰 선택, Gumbel 점수 누적과 온도, 위치 보존 및 배치별 성능 조건을 원문으로 검토한다.
Prompt Cache의 PML·위치 ID·모듈 간 attention 근사를 설명하고, 2048토큰 예시의 FLOPs 오류와 실험 조건별 TTFT를 원문에 맞게 정리한다.
개인의견 : 서비스를 하는 수준에서 생각하면 continuous batching같은 테크닉을 사용하면 prefill을 스케줄을 어떠한 방식으로 할지가 궁금했는데 이러한 방법으로 stall을 줄이다니 재밋는 논문이네요. 다만 prefill의 stall을 줄이기 위해서 decode는 불필요하게…
제목 DARTS: DIFFERENTIABLE ARCHITECTURE SEARCH 저자 Hanxiao Liu,Karen Simonyan,Yiming Yang Motivation 기존 NAS가 상당수의 시간 혹은 cost가 필요(2000 GPU days of reinforcement learning,…
제목 End-to-End Deep Learning of Optimization Heuristics 저자 Chris Cummins ; Pavlos Petoumenos ; Zheng Wang ; Hugh Leather Motivation 기존 머신러닝을 이용한 compiler optimizaion 방법에서는…
제목 Fast and Effective Orchestration of Compiler Optimizations 저자 Zhelong Pan,Rudolf Eigenmann Motivation compile-time optimizations 은 전반적으로 프로그램 성능을 향상시키지만 일부 기법은 성능 하락을…
제목 TVM: An Automated End-to-End Optimizing Compiler for Deep Learning TVM? 해당논문은 머신러닝용 컴파일러중에 대표적인 TVM에 대한 paper입니다. 현재는 apache에서 관리 하고 있으며 graph level IR 을 통한…
제목 Chameleon: Adaptive Code Optimization for Expedited Deep Neural Network Compilation 저자 Byung Hoon Ahn, Prannoy Pilligundla, Amir Yazdanbakhsh, Hadi Esmaeilzadeh…
제목 LLVM: A Compilation Framework for Lifelong Program Analysis & Transformation 저자 Chris Lattner Vikram Adve 개인적으로 느끼는 논문의 insight Lifelong Program Analysis개념을 도입하여…
제목 NeuroVectorizer: End-to-End Vectorization with Deep Reinforcement Learning 저자 Ameer Haj-Ali, Nesreen K. Ahmed, Ted Willke, Sophia Shao, Krste Asanovic, Ion Stoica…